
第二十五天,我們要探討模型訓練完成後,如何邁向實際應用與工程落地的核心步驟—— Model Persistence 與 Inference Pipeline。在開發階段,每次執行程式碼重新訓練模型看似可行,但當模型結構複雜、數據集龐大時,重新訓練往往需要數小時甚至數天。此外,在生產環境接收新資料進行預測時,特徵工程(如標準化、縮放)必須與訓練時的參數(平均值與標準差)完全一致。今天我們建立純 Python 腳本 day25_model_persistence.py,掌握使用 Scikit-Learn 的 Pipeline 整合前處理與分類器,並利用 joblib 將整個物件序列化儲存與重載推論。
第一部分
新建 day25_model_persistence.py。首先載入經典的紅酒資料集,並使用 Scikit-Learn 的 Pipeline 類別,將「特徵標準化(StandardScaler)」與 RandomForestClassifier 打包成單一物件,確保前處理與模型擬合在同一個工作流內完成: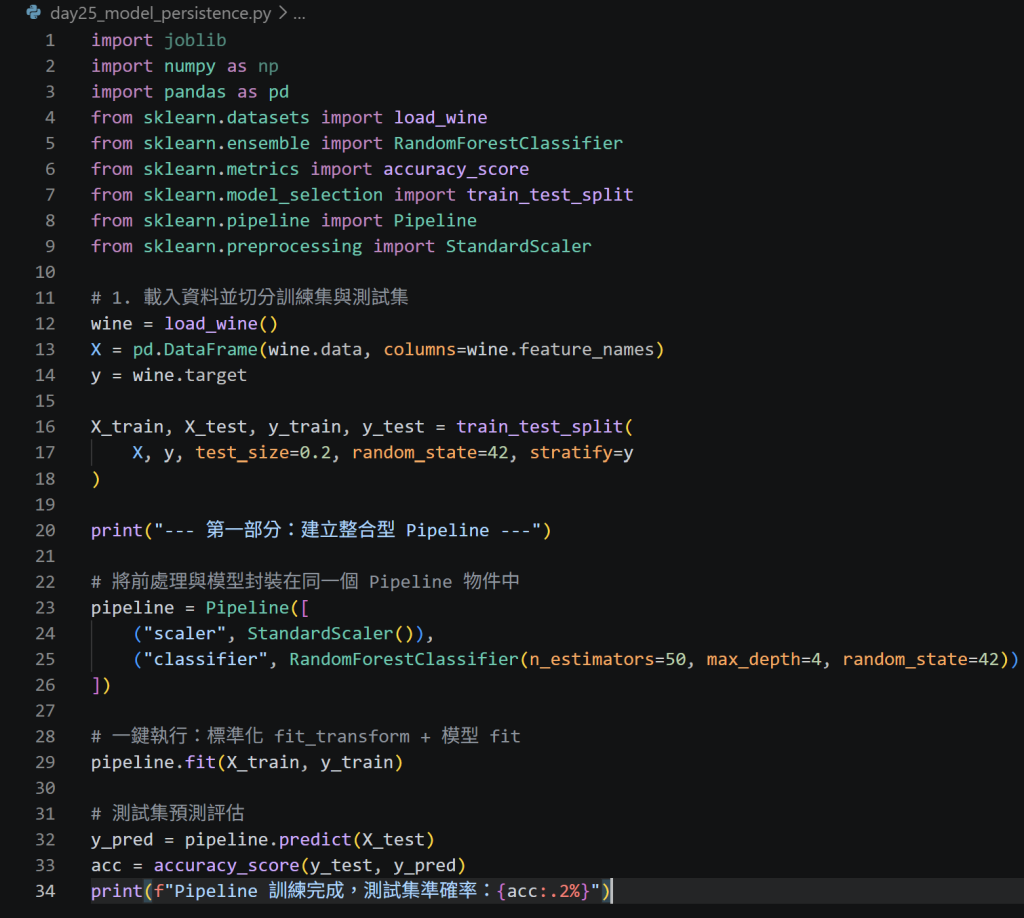
第二部分
訓練好的 Pipeline 物件包含完整的模型權重以及標準化參數(Mean 與 Std)。我們使用 Python 效能最佳的物件序列化工具 joblib,將整個管線物件儲存為實體檔案 wine_pipeline.joblib: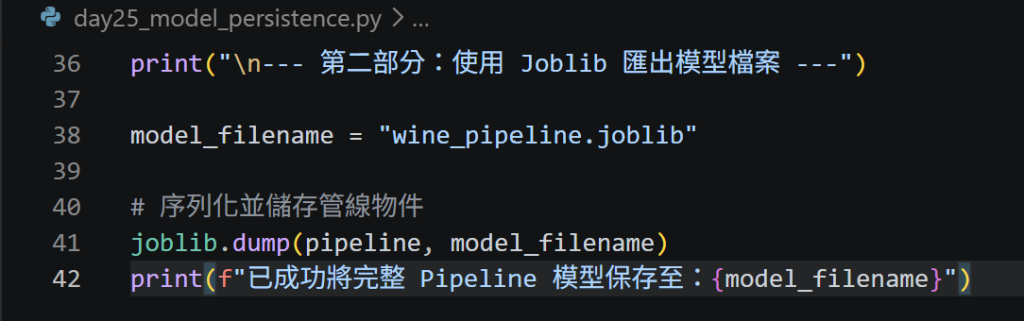
第三部分
模擬未來部署到 API 或生產環境時的場景:我們無需重新載入訓練集或重新擬合模型,直接使用 joblib.load() 讀取檔案,並接收一筆全新的待預測特徵向量,直接呼叫 .predict() 與 .predict_proba() 產出推論結果與預測信心度: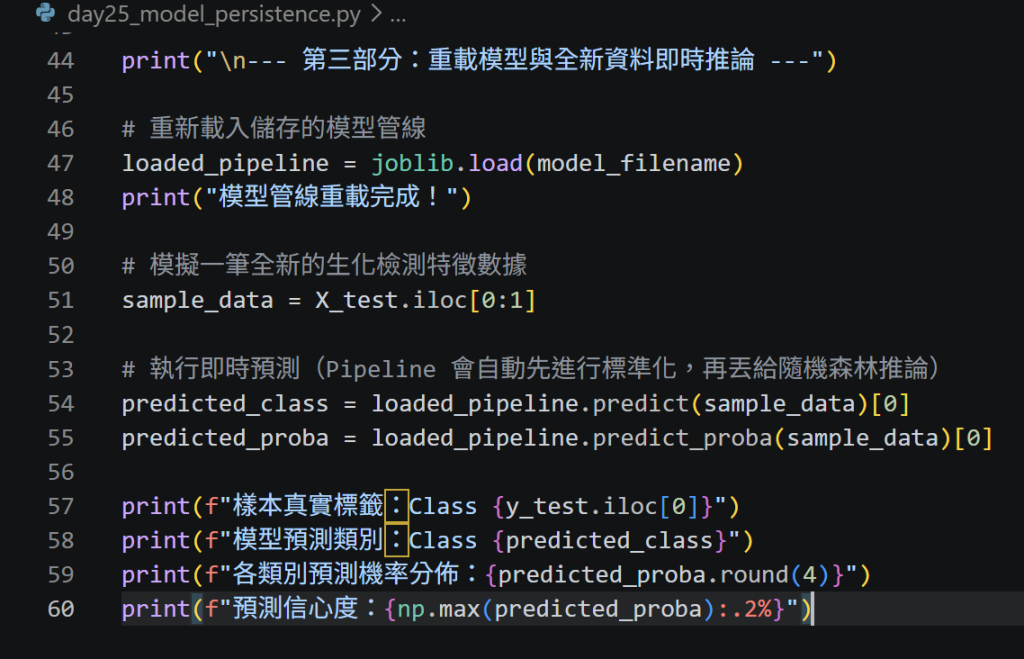
第四部分
在終端機輸入 python day25_model_persistence.py 執行驗證,確認檔案 wine_pipeline.joblib 成功生成在專案目錄下,且重載後的預測結果與真實標籤吻合。確認存檔(Ctrl + S)後推送到 GitHub 進行版本控制: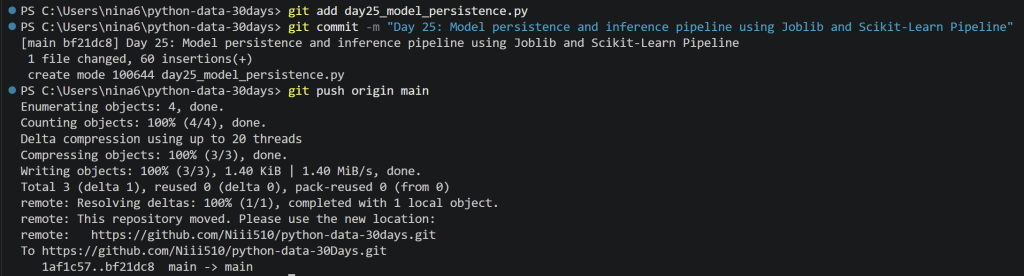
今日心得/遇到的問題
今天跨出了從模型實驗走向工程落地的重要一步。過去如果只儲存模型權重,推論新數據時往往需要手動先對資料做縮放,很容易遺失當時訓練用的統計參數或造成資訊不對稱。透過 Scikit-Learn 的 Pipeline,可以把特徵前處理步驟與演算法捆綁成單一物件,再用 joblib.dump 輸出單一 .joblib 檔案;未來架設 FastAPI 或 Flask 後端服務時,只需一行 joblib.load(),就能建立穩定、低延遲且乾淨的即時推論 API。

 niii

 iThome鐵人賽
 看影片追技術