
第二十七天,我們要探索在各類 Kaggle 數據競賽與工業界應用中表現亮眼的代表性架構——Boosting。在 Day 20 介紹的隨機森林屬於 Bagging 架構,每棵樹都是獨立並行生長、最後投票表決;而 Boosting 則是採取循序漸進、迭代修正的策略。模型會先訓練一棵弱決策樹,下一棵樹則專門針對前一棵樹預測錯誤的殘差進行擬合補強。今天我們建立純 Python 腳本 day27_gradient_boosting.py,掌握 Scikit-Learn 內建的 GradientBoostingClassifier 以及業界標準 XGBoost 的分類實作與成效評估。
第一部分
新建 day27_gradient_boosting.py。首先載入經典的乳癌腫瘤診斷資料集,切分訓練集與測試集,並使用 Scikit-Learn 內建的 GradientBoostingClassifier 進行模型訓練與預測: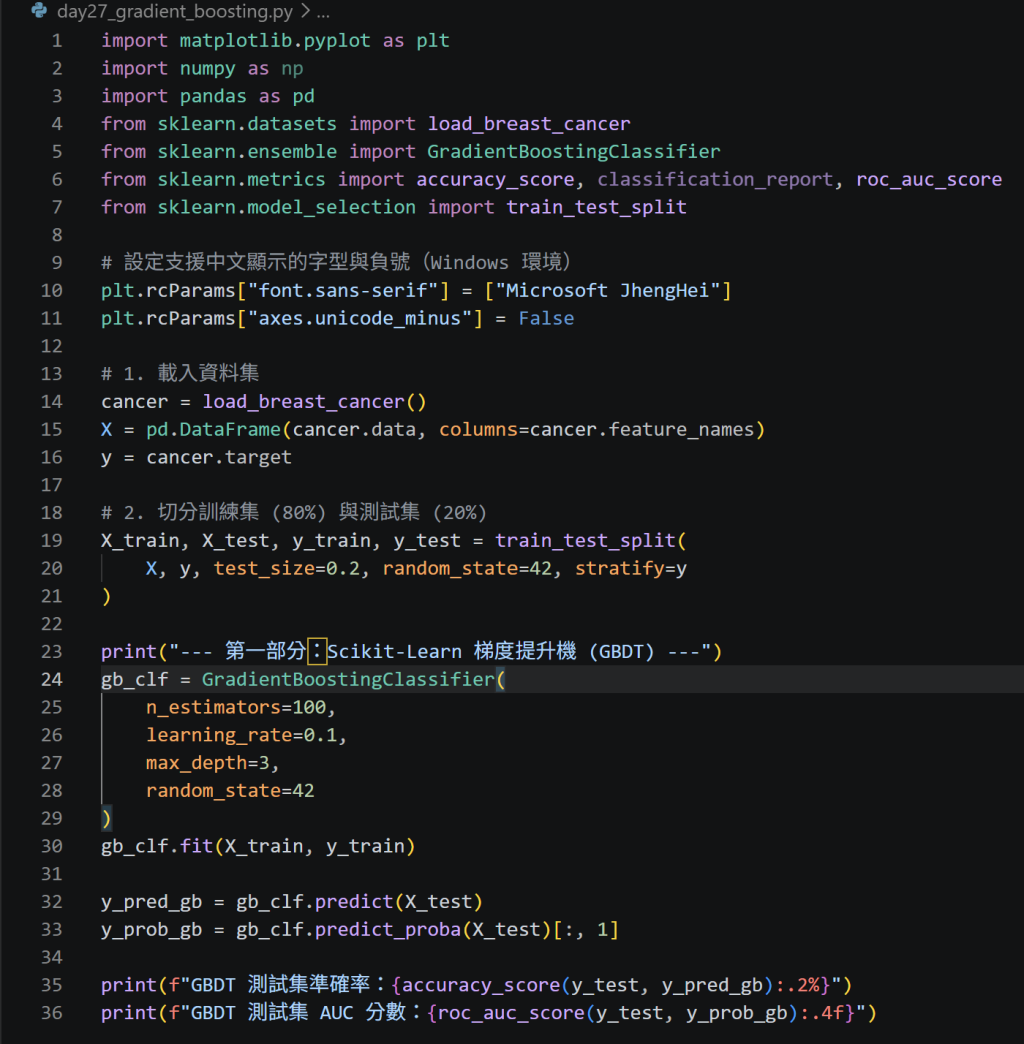
第二部分
接著實作在大型資料集上運算效率更高、正則化控制更嚴格的Extreme Gradient Boosting。透過 XGBClassifier 宣告模型,設定learning_rate、max_depth與子樣本採樣率,並產出分類評估指標: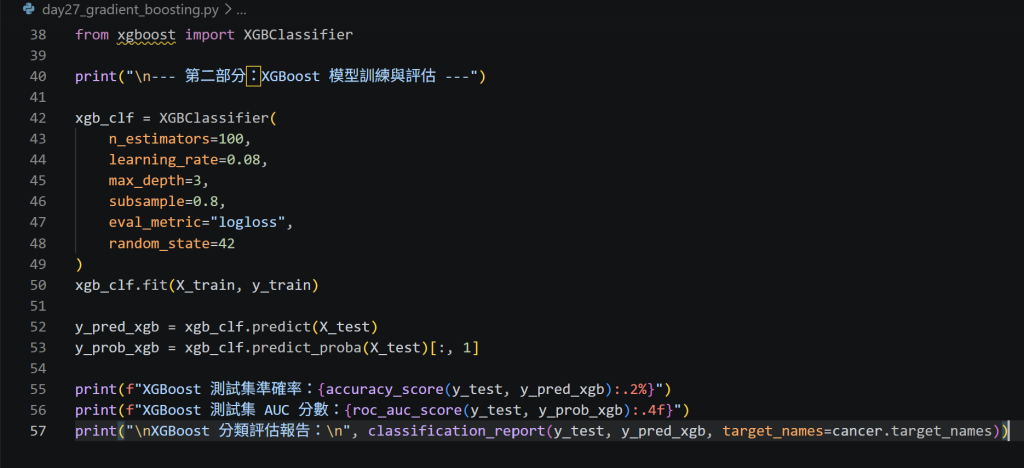
**
第三部分**
比較兩大模型學習到的特徵重要性(Feature Importance)。擷取排名前 8 位的特徵,繪製雙長條對比圖,觀察兩個演算法在挑選關鍵診斷指標時的異同: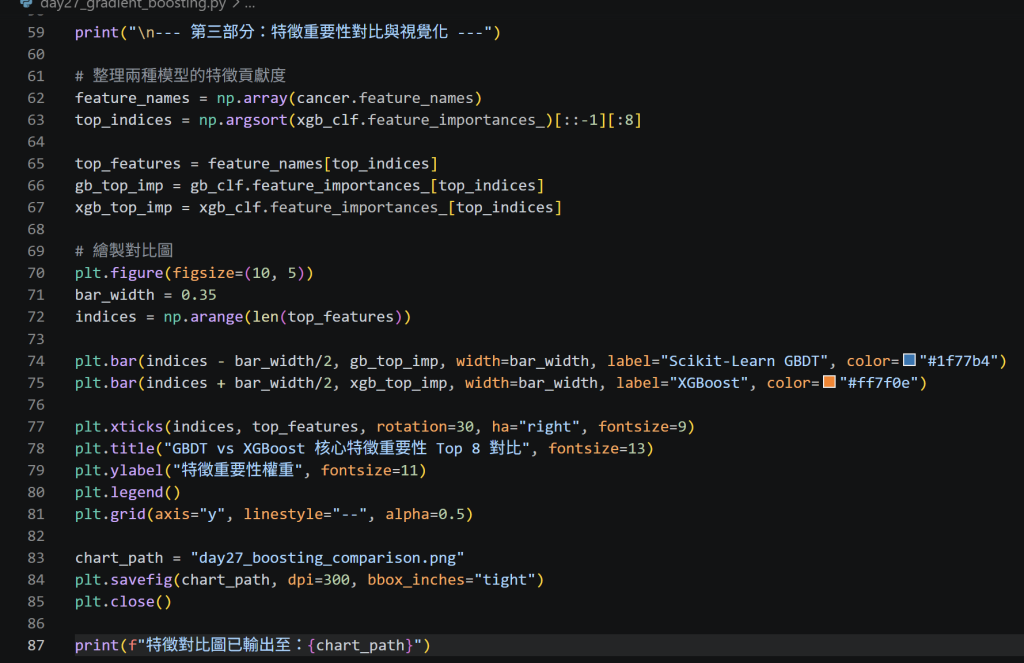
第四部分
在終端機輸入 python day27_gradient_boosting.py 執行驗證,確認 GBDT 與 XGBoost 的準確率與 AUC 數值順利印出,且圖片 day27_boosting_comparison.png 順利產出。確認存檔(Ctrl + S)後推送到 GitHub 進行版本控制: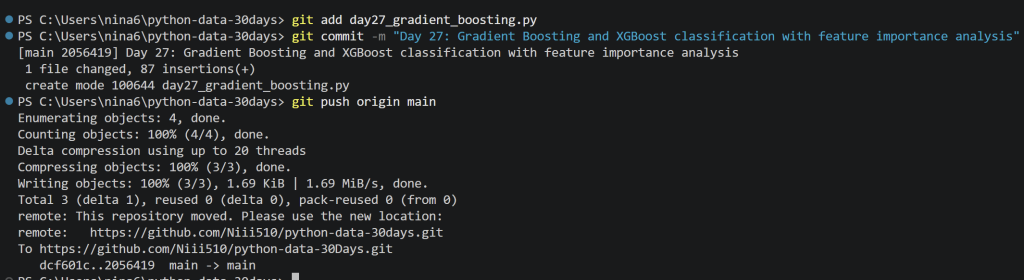
今日心得/遇到的問題
今天認識了樹模型體系中最具代表性的 Boosting 算法。不同於隨機森林靠大數法則平滑誤差,梯度提升機專注於踩在前面的錯誤往前走,因此往往能逼近更低的訓練誤差。但也正因如此,調參時必須特別控制learning_rate與max_depth,避免後期的樹過度擬合訓練集裡的雜訊。XGBoost 內建了 L1/L2 樹節點正則化與高效的平行列切分機制,是處理結構化表格資料時首選的基準模型之一。

 niii

 iThome鐵人賽
 看影片追技術