
第二十八天,我們進入了鐵人賽的最後衝刺階段!在過去兩週內,我們陸續學過了Logistic Regression、Decision Tree、Bagging 集成(Random Forest)以及 Boosting 集成(XGBoost)。但在實務專案中,沒有任何單一演算法能夠在所有數據集上稱霸(即「沒有免費的午餐定理 No Free Lunch Theorem」)。面對新任務時,資料科學家的標準工作流是搭建一組模型基準評測系統(Benchmark Pipeline),以相同的交叉驗證標準與測試集橫向比對各模型的準確率、F1-Score、AUC 與推論耗時。今天我們建立純 Python 腳本 day28_model_benchmark.py,掌握多模型自動化評測迴圈與多重 ROC 曲線疊圖視覺化。
第一部分
新建 day28_model_benchmark.py。載入資料集並切分訓練集與測試集,接著將 4 種主流模型統一封裝在字典結構中,為後續的自動化評估管線做準備: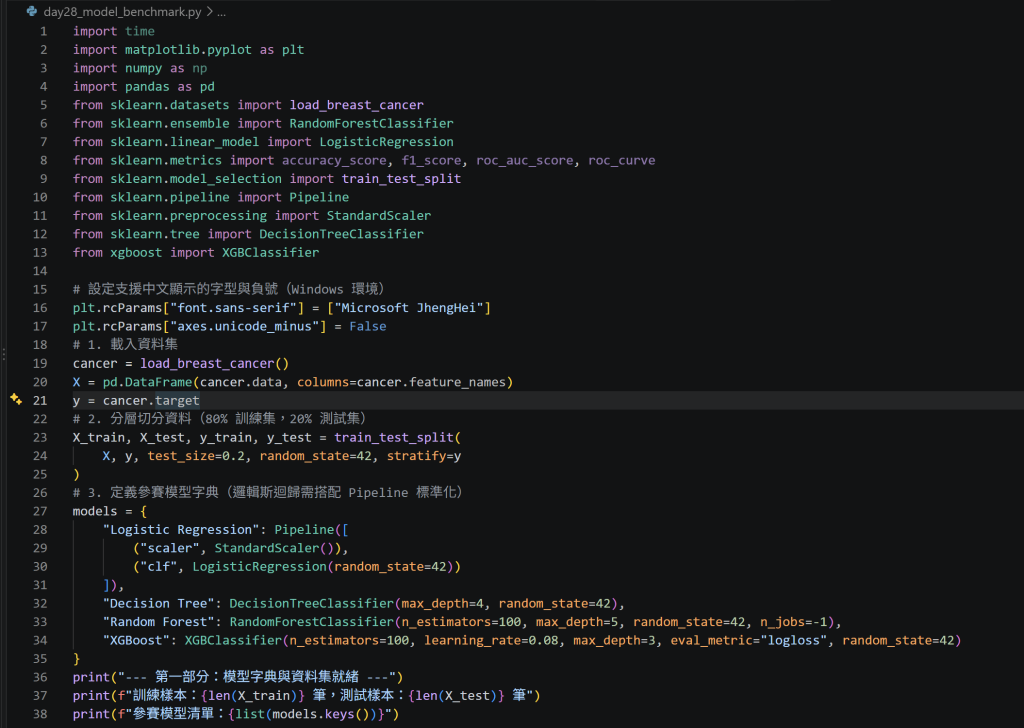
第二部分
設計評測迴圈。逐一訓練模型、記錄擬合時間,並在測試集上計算四大維度指標:準確率、F1-Score、AUC 與推論機率值: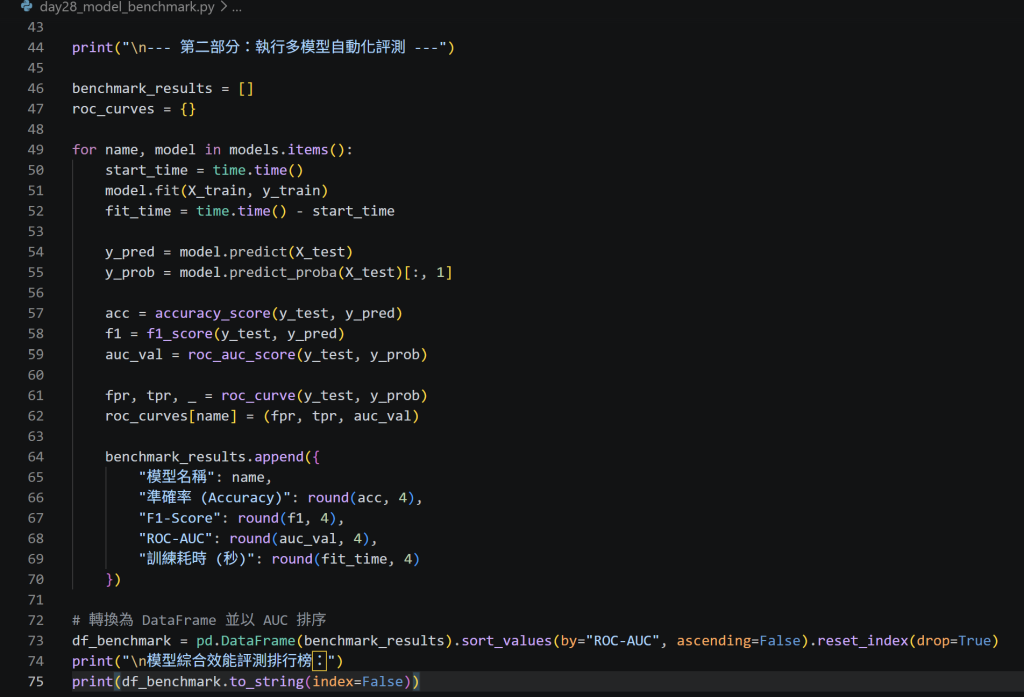
**
第三部分**
將各模型的 ROC 曲線繪製在同一張畫布上進行疊圖橫向對齊,並搭配各模型的 AUC 指標直觀看出哪一個分類器在測試集上最具鑑別力: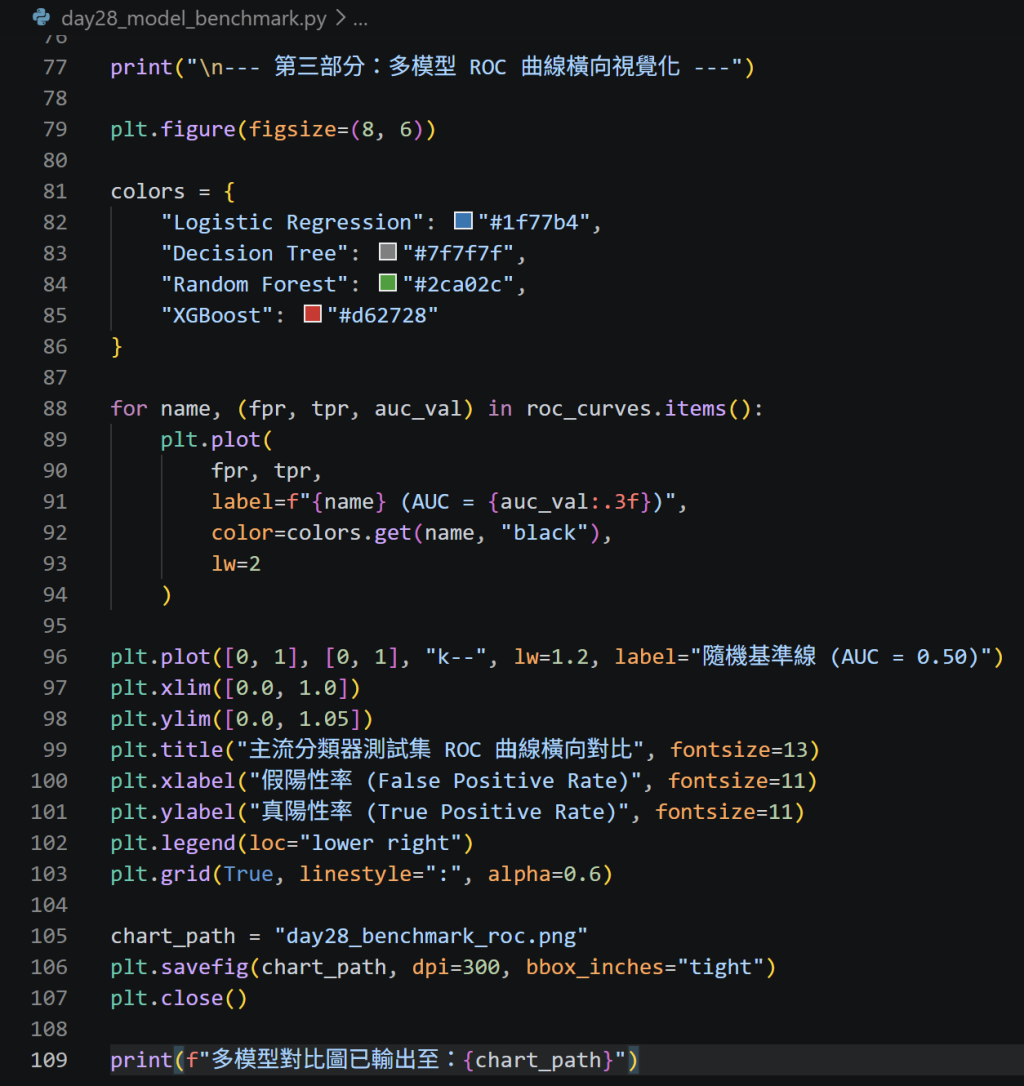
第四部分
在終端機輸入 python day28_model_benchmark.py 執行驗證,確認 4 款模型的指標排行榜順利印出,且圖片 day28_benchmark_roc.png 順利產出。確認存檔(Ctrl + S)後推送到 GitHub 進行版本控制: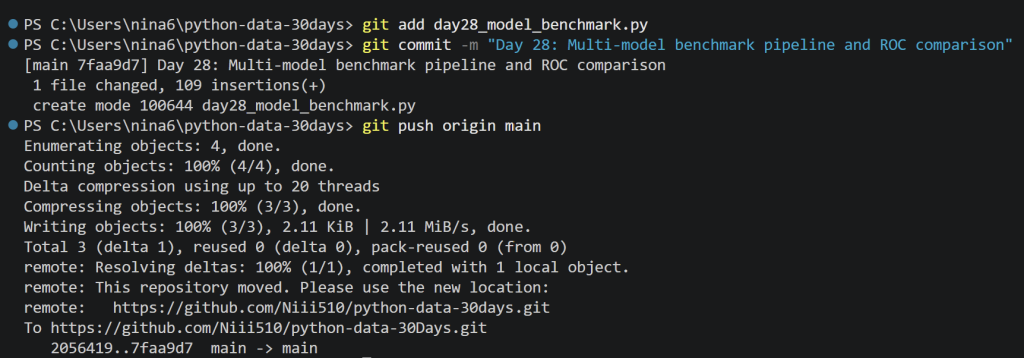
今日心得/遇到的問題
今天建立了一套非常標準的多模型競技場自動化架構。在真實的資料科學專案裡,我們通常不會一開始就孤注一擲在某個特定演算法上,而是會先用簡單的 Logistic Regression 作為 Baseline ,再逐步引入 Random Forest 與 XGBoost 等強大集成模型進行競爭。透過將模型物件封裝成字典並以迴圈提取指標,能大幅節省重複撰寫評估程式的時間,最後疊合的 ROC 曲線更能提供產品或業務團隊最直觀的模型決策依據。

 niii

 iThome鐵人賽
 看影片追技術