
第二十九天,也是我們鐵人賽技術實作的最高峰!在過去的 28 天中,我們從最基礎的矩陣處理、數據清理、分組視覺化,一路走到監督式學習(回歸、決策樹、隨機森林、XGBoost)、非監督式學習(K-Means、PCA)以及模型評估與調參。今天我們要將所有獨立模組熔鑄成一個完整的端到端機器學習生產級專案(End-to-End Production ML Project)。在腳本 day29_capstone_pipeline.py 中,我們將涵蓋:
1.模擬具備混合型態與缺失值之實務數據。
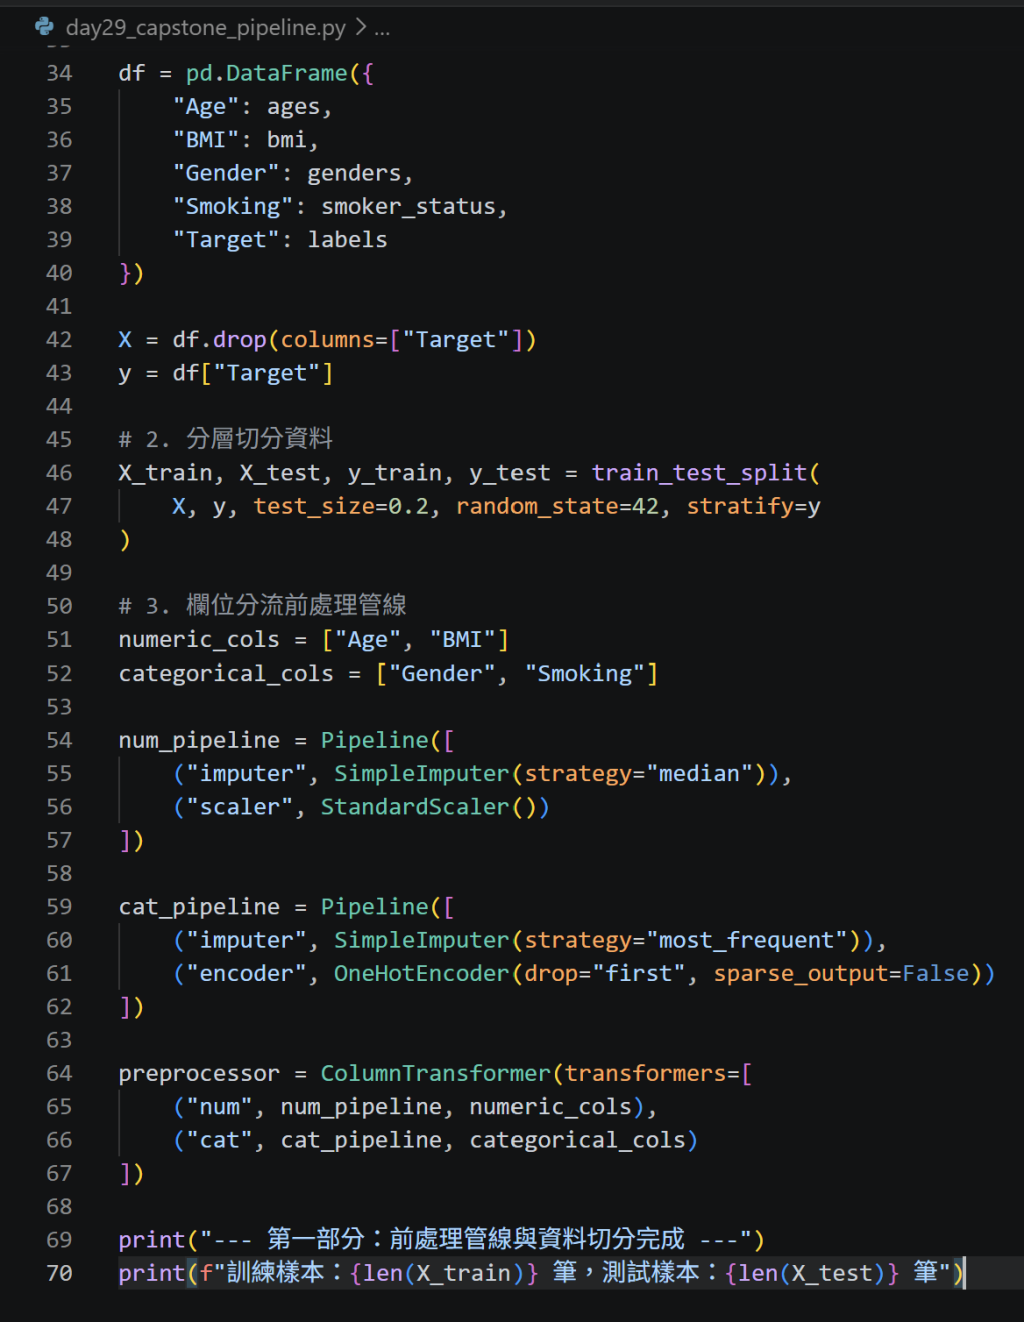
2.使用 ColumnTransformer 分流處理數值(填補+標準化)與類別特徵(填補+One-Hot)。
3.整合超參數網格搜尋(GridSearchCV)。
4.匯出混淆矩陣報表圖並將整條 Pipeline 序列化儲存為生產模型檔。
第一部分
新建 day29_capstone_pipeline.py。建立包含數值缺失值與字串類別的醫療預後數據集,並利用 Scikit-Learn 的 ColumnTransformer 搭建針對不同型別欄位的前處理管線: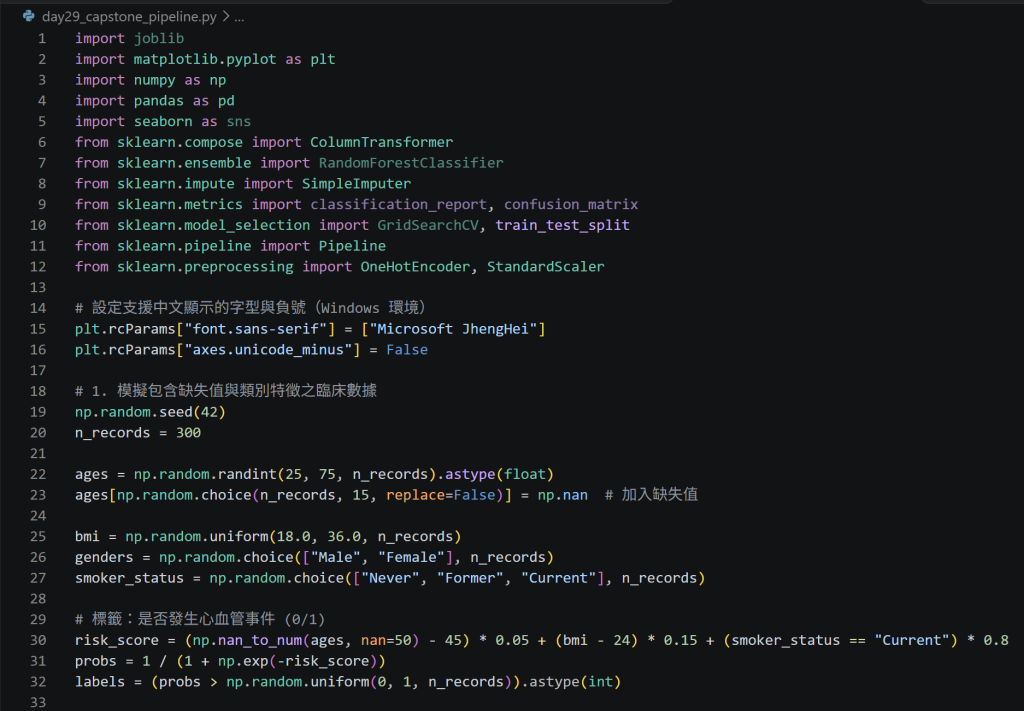
第二部分
將前處理器 preprocessor 與隨機森林分類器組合成完整的全流程 Pipeline,並串接 GridSearchCV 進行自動化超參數尋優: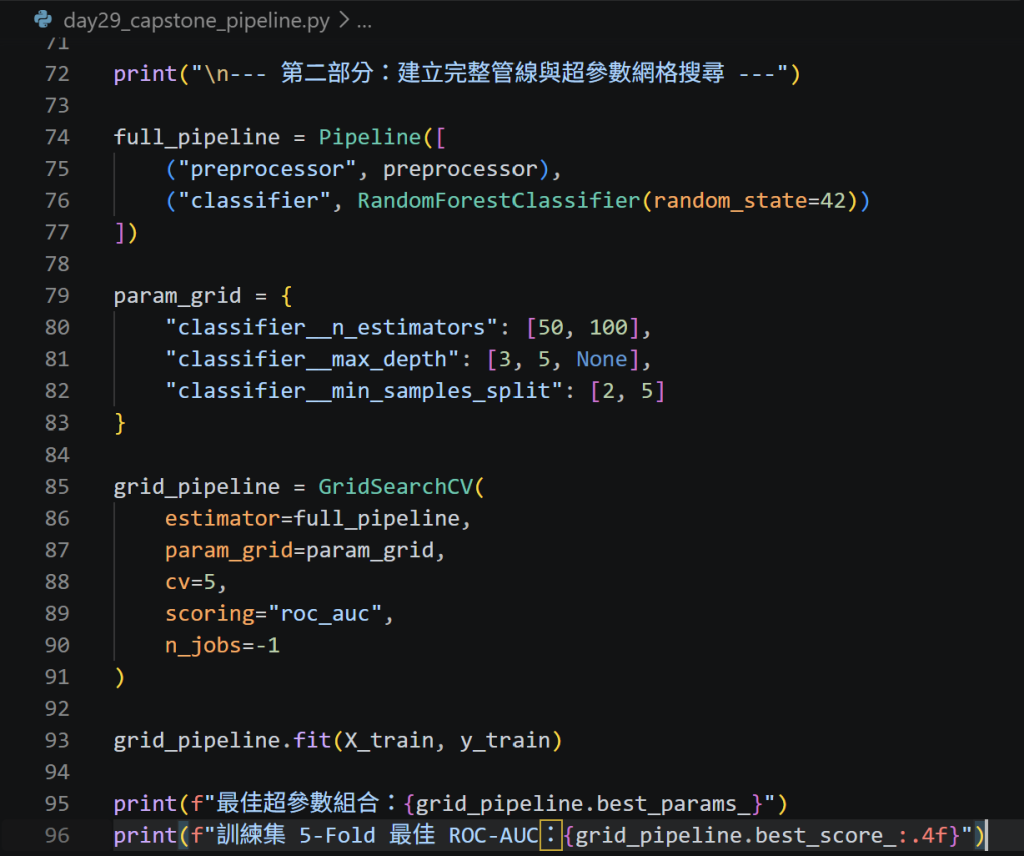
第三部分
使用測試集驗證最終模型成效,輸出分類報告,繪製混淆矩陣熱力圖並將最佳管線輸出成 .joblib 檔供生產部署使用: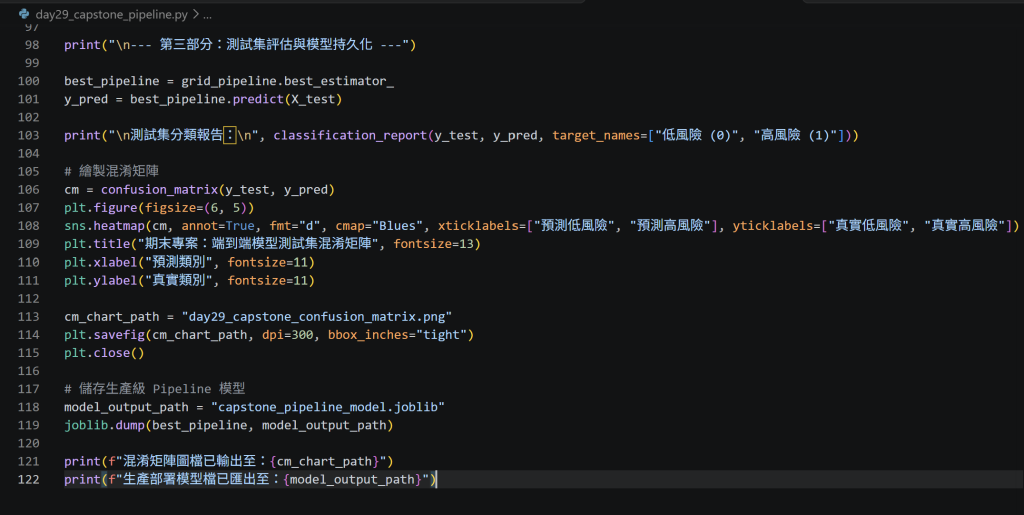
第四部分
在終端機輸入 python day29_capstone_pipeline.py 執行驗證,確認包含中位數缺失填補、One-Hot 編碼、超參數交叉驗證與模型儲存一次完成。按 Ctrl + S 儲存後推送到 GitHub 進行版本控制: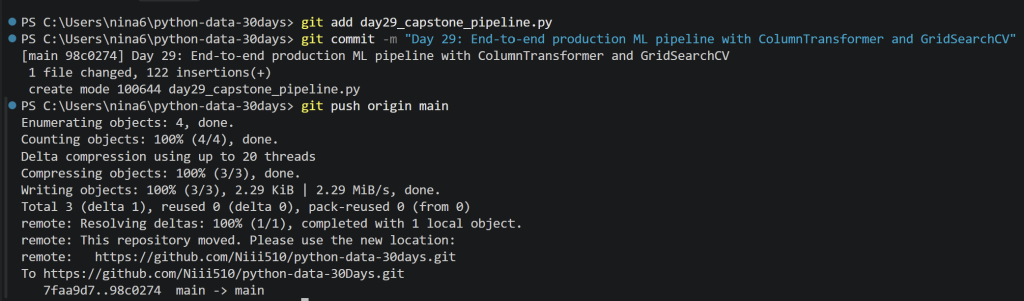
今日心得/遇到的問題
今天完成了真正貼近企業級應用場景的端到端機器學習管線。以往常見的作法是先在 Pandas 手動填補遺漏值、手動做 One-Hot,最後才把矩陣餵給模型,這樣做極易產生特徵洩漏且難以工程化。透過 ColumnTransformer 與 Pipeline 的完美組合,前處理策略被完整封裝在物件內部,即便未來輸入帶有缺失值的原始字串 DataFrame,模型也能自動完成清洗、轉換與預測,展現了高內聚、低耦合的架構之美。

 niii

 iThome鐵人賽
 看影片追技術