
第三十天,我們終於抵達了這趟 30 天馬拉松的終點線!從第一天建立虛擬環境、摸索 NumPy 陣列矩陣運算,到利用 Pandas 進行各種棘手的資料清洗、時間序列轉換與聚合統計;再從 Matplotlib/Seaborn 的視覺化圖表,一路跨進 Scikit-Learn 的機器學習世界——涵蓋回歸、二元/多元分類、決策樹、隨機森林、XGBoost、非監督式 K-Means 與 PCA,再到昨天整合度最高的生產級端到端 Pipeline。今天我們不寫繁重的演算法,而是撰寫一份完整的專案復盤檢視工具與成果總結腳本 day30_summary_review.py,並梳理這 30 天建立的完整技能樹。
第一部分
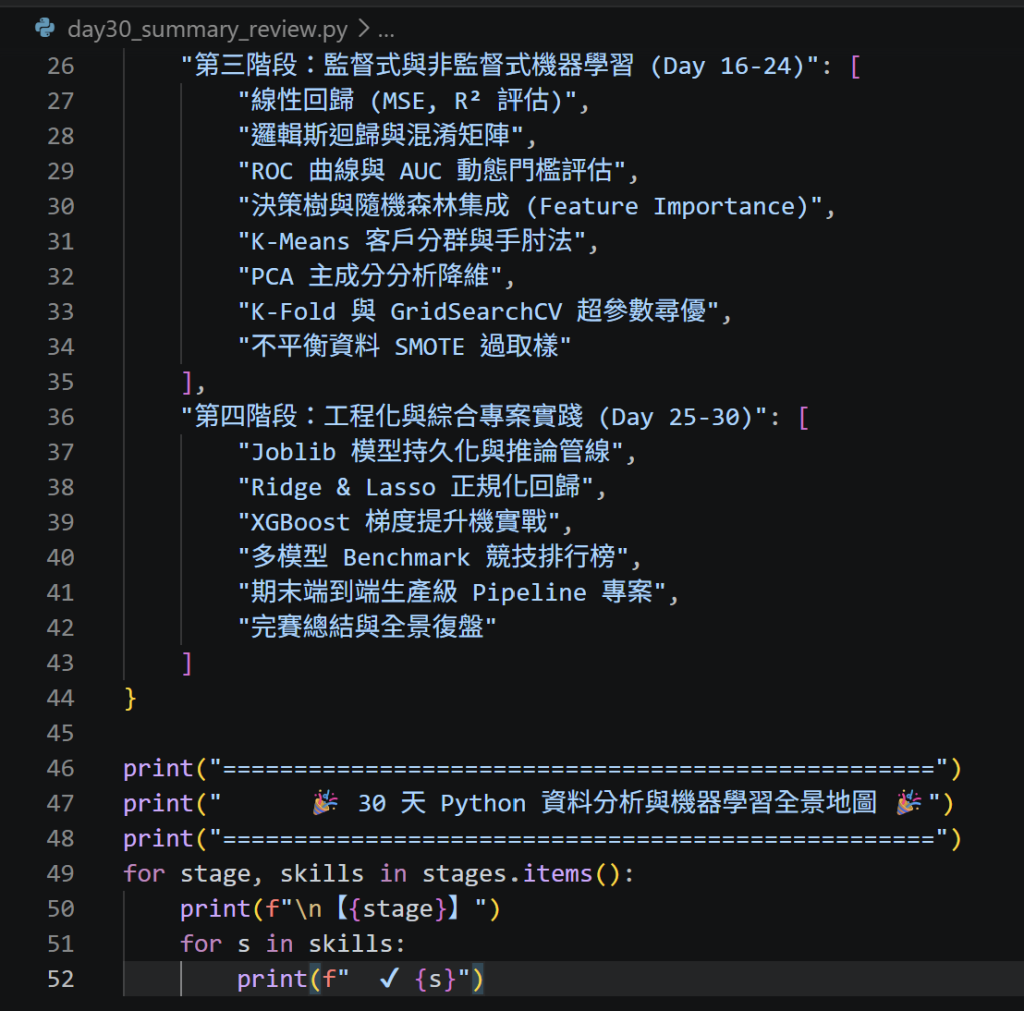
新建 day30_summary_review.py。回顧與盤點 30 天實作沉澱下來的核心架構,將整個 30 天知識體系劃分為四大核心階段,並在終端機格式化輸出這張扎實的技能樹: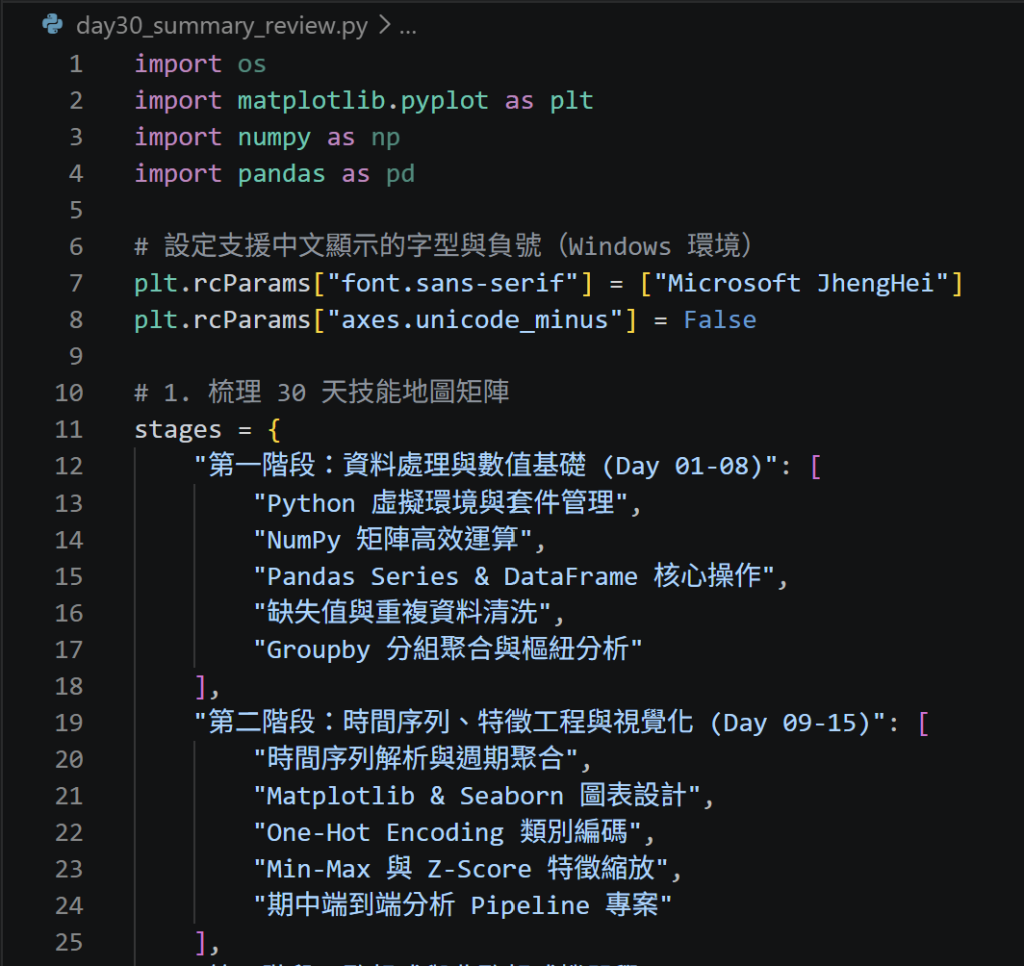
第二部分
將這 30 天的主題劃分與累計實作投入比重轉化為統計數據,並繪製成一張專業的「30 天技能樹分佈圓餅圖與學習進程時間軸」: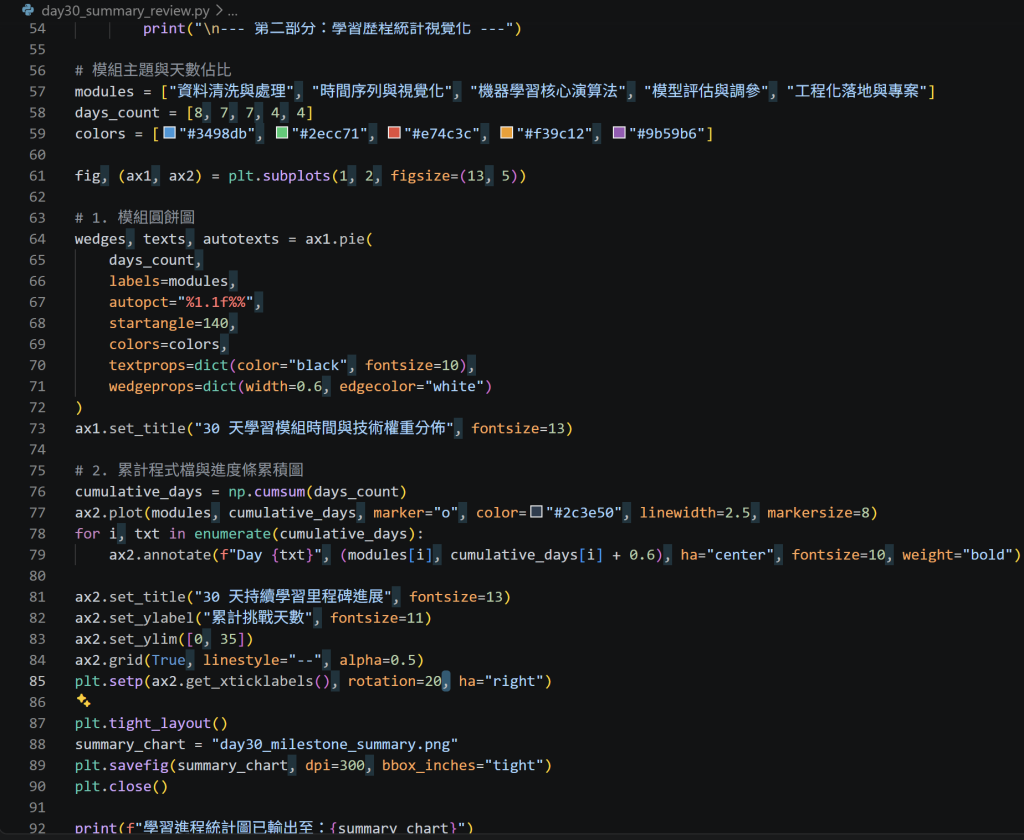
第三部分
在腳本中加入自動化檢查機制,動態掃描本地專案目錄,確認 30 天的 Python 腳本(day01 到 day30)是否皆整齊完備: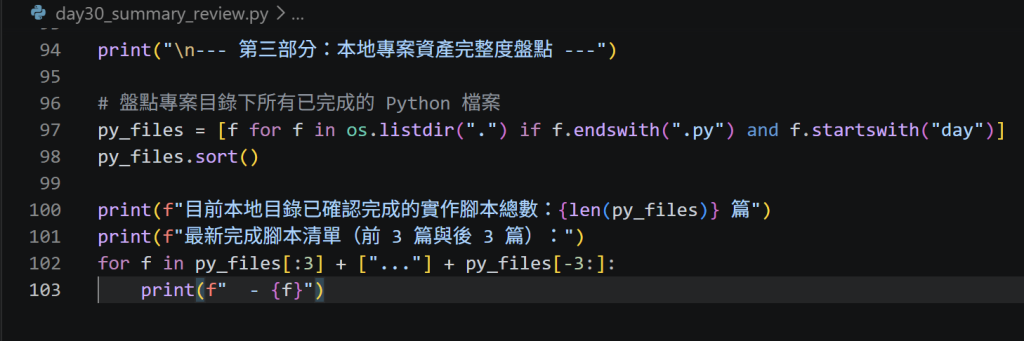
第四部分
在終端機輸入 python day30_summary_review.py 執行驗證,確認 30 天的技能地圖完整輸出、統計圖產出,且盤點數量正確無誤。按 Ctrl + S 儲存後推送到 GitHub 進行最後一次具有里程碑意義的 Push: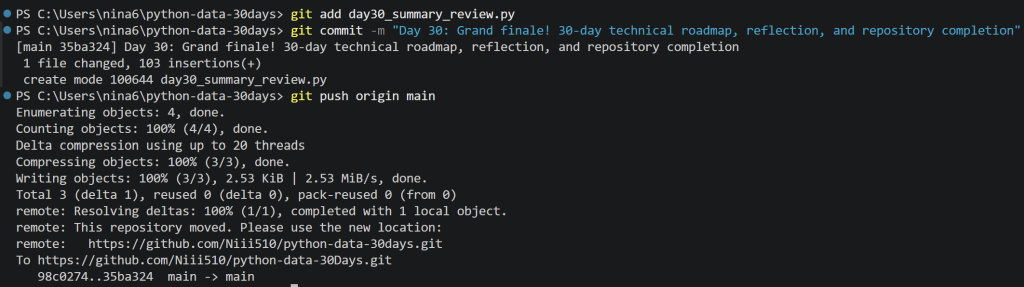
心得
這 30 天每天堅持寫出一篇結構完整、能實際跑通的 Python 腳本並撰寫技術筆記,是一場對毅力與基本功的巨大考驗。從一開始可能會被缺失值報錯、型別對不齊困住,到中後期能夠熟練地搭建 Pipeline、優化超參數、評估 ROC 曲線並應對類別不平衡,自己對於「資料」與「模型」的掌握度有了質的飛躍。30 天不是學習的終點,而是邁向深度學習(Deep Learning)、自然語言處理(NLP)與大型數據工程(MLOps)的最佳起點!

 niii

 iThome鐵人賽
 看影片追技術