
Spark 做 groupBy、join 或 distinct 時,常會先把資料重新分流,再交給下一批 tasks 處理。這批工作要切成幾份,很像把一箱貨分給同事:分太少,每個人扛太重,可能變慢、spill,甚至拖住整個 Stage;分太多,每個人只拿一小袋,反而花很多時間在啟動 task、排程和讀檔。
這時很容易直接問:「spark.sql.shuffle.partitions 到底要設多少?」更容易困惑的是,既然 AQE 已經開著,這個數字是不是根本不用管?
答案是:還是要管。它決定 Spark 一開始把工作切多細;AQE 則是在真的看見資料量後,幫忙把太零碎的工作合併。這篇用一個小實驗把過程拆開,也整理真正調整時可以怎麼想。
Ep22–Ep26:先學會從 UI 與執行證據找出慢在哪裡
        ↓
Ep27:shuffle 工作要切多細?
先切開,再讓 AQE 合併太零碎的工作
        ↓
Ep28:少數 task 特別慢時,要不要重跑一份?
        ↓
Ep29:小表要不要送到每個 Executor?
        ↓
Ep30:大量小檔案要怎麼裝進 scan tasks?
Ep07 曾介紹 AQE 會在執行中調整 query plan。這次我們把焦點縮小:當 shuffle 工作份數不合適時,AQE 是怎麼介入的?我又該怎麼設定一個不會太冒險的起點?
Spark 在 shuffle 開始前,其實還不知道每一份資料最後會有多大。比方說一個 groupBy,有些資料可能在聚合後大幅縮小,有些卻幾乎原封不動地進入 shuffle。Spark 必須先決定要把資料切成幾份,讓 map-side tasks 分別寫出對應的 shuffle blocks。
等 map-side tasks 真正做完,Spark 才拿得到每份 shuffle block 的大小。AQE 就是在這個時間點,才有資訊判斷哪些 partitions 小到可以一起交給同一個下游 task。
groupBy / join / distinct
        ↓
先依設定把未來工作切成多份
        ↓
map-side tasks 寫出 shuffle 資料
        ↓
現在才知道每一份實際有多大
        ↓
AQE 把太小、相鄰的份數合在一起
        ↓
下游 tasks 讀取原本或合併後的資料
所以 spark.sql.shuffle.partitions 不會因為 AQE 出現就失去意義。它是「一開始切幾份」的數字。如果一開始切得太少,某一份已經大得離譜,AQE 的 coalescing 不能把它切得更小;如果一開始切得比較細,AQE 才能把實際很小的份數併回來,避免產生一堆只跑幾秒的 task。
這篇談的是 Spark SQL/DataFrame 的 AQE post-shuffle coalescing。它不是 RDD 的萬用 partition 工具,也不會同時處理 skew join、broadcast join 或小檔案問題;那些都有自己的判斷方式。
可以把初始 partition 想成先把菜切開;AQE coalescing 則是在看見份量後,把太少的幾盤併成一盤。它擅長合併,不擅長補救一開始就切得太粗的大塊資料。
設定名稱看起來很多,但把它們放回流程,就不難分辨。
| 設定 | Spark 3.4.4 預設值 | 白話來說 | 什麼時候會在意它 |
|---|---|---|---|
spark.sql.shuffle.partitions |
200 |
一開始把 shuffle 工作切成幾份。 | task 普遍太大時,這是先讓工作切細的地方。 |
spark.sql.adaptive.enabled |
true |
要不要讓 Spark 在執行中拿實際資料量來調整計畫。 | AQE 的總開關。Spark 3.2 起預設為開啟,但仍要確認執行環境沒有覆寫它。 |
spark.sql.adaptive.coalescePartitions.enabled |
true |
AQE 能不能把太小的 shuffle partitions 合併。 | AQE 開著卻看不到 task 變少時,先檢查這個。 |
spark.sql.adaptive.advisoryPartitionSizeInBytes |
64MB |
Spark 合併時,希望每一份工作大約有多大。 | 它是參考目標,不是每個 task 絕不超過的硬上限。 |
spark.sql.adaptive.coalescePartitions.initialPartitionNum |
未設定;有效值沿用 spark.sql.shuffle.partitions |
AQE 合併前,先從幾個 partitions 開始看。 | 多數情況不用另外設;只有要刻意覆寫初始基準時才需要。 |
spark.sql.adaptive.coalescePartitions.parallelismFirst |
true |
Spark 要優先保留較多 tasks,還是更認真朝目標資料量合併。 | 想依 advisory size 調整時,官方文件建議設成 false。 |
spark.sql.adaptive.coalescePartitions.minPartitionSize |
1MB |
合併時最低要保留多大的一份工作。 | 它避免產生太細碎的結果,但不是把大 partition 切小的開關。 |
這些設定不是各調各的。舉例來說,advisory size 看起來設成 64MB,但如果仍保留預設的 parallelismFirst=true,Spark 可能更傾向維持高平行度,而不會完全照 64MB 的方向合併。反過來說,把目標大小調得很大,也救不了單一 hot key 造成的大 partition。
這次我固定使用 1,200,000 筆均勻分布的資料、16 個 source partitions、120,000 個 group keys,執行 groupBy(group_key)、sum 和 max(payload)。每筆資料都帶有不同的 payload,讓 aggregation 真的會寫出值得觀察的 shuffle 資料;key 是均勻分布的,所以這裡刻意不討論 skew。
實驗環境有兩個 Standalone Executors、共四個 task slots。三個 phase 都從 spark.sql.shuffle.partitions=32 出發,只有 AQE 與 coalescing 的開關不同:
| Phase | AQE | 合併小 partitions | 最後的 result partitions |
|---|---|---|---|
| Phase 1 | 關閉 | 關閉 | 32 |
| Phase 2 | 開啟 | 關閉 | 32 |
| Phase 3 | 開啟 | 開啟 | 11 |
第三個 phase 額外使用 16m 作為目標大小,並設 parallelismFirst=false、minPartitionSize=1m。這樣做只是讓「Spark 真的合併了」更容易看出來;不是說 production 都該直接照抄 16 MiB。
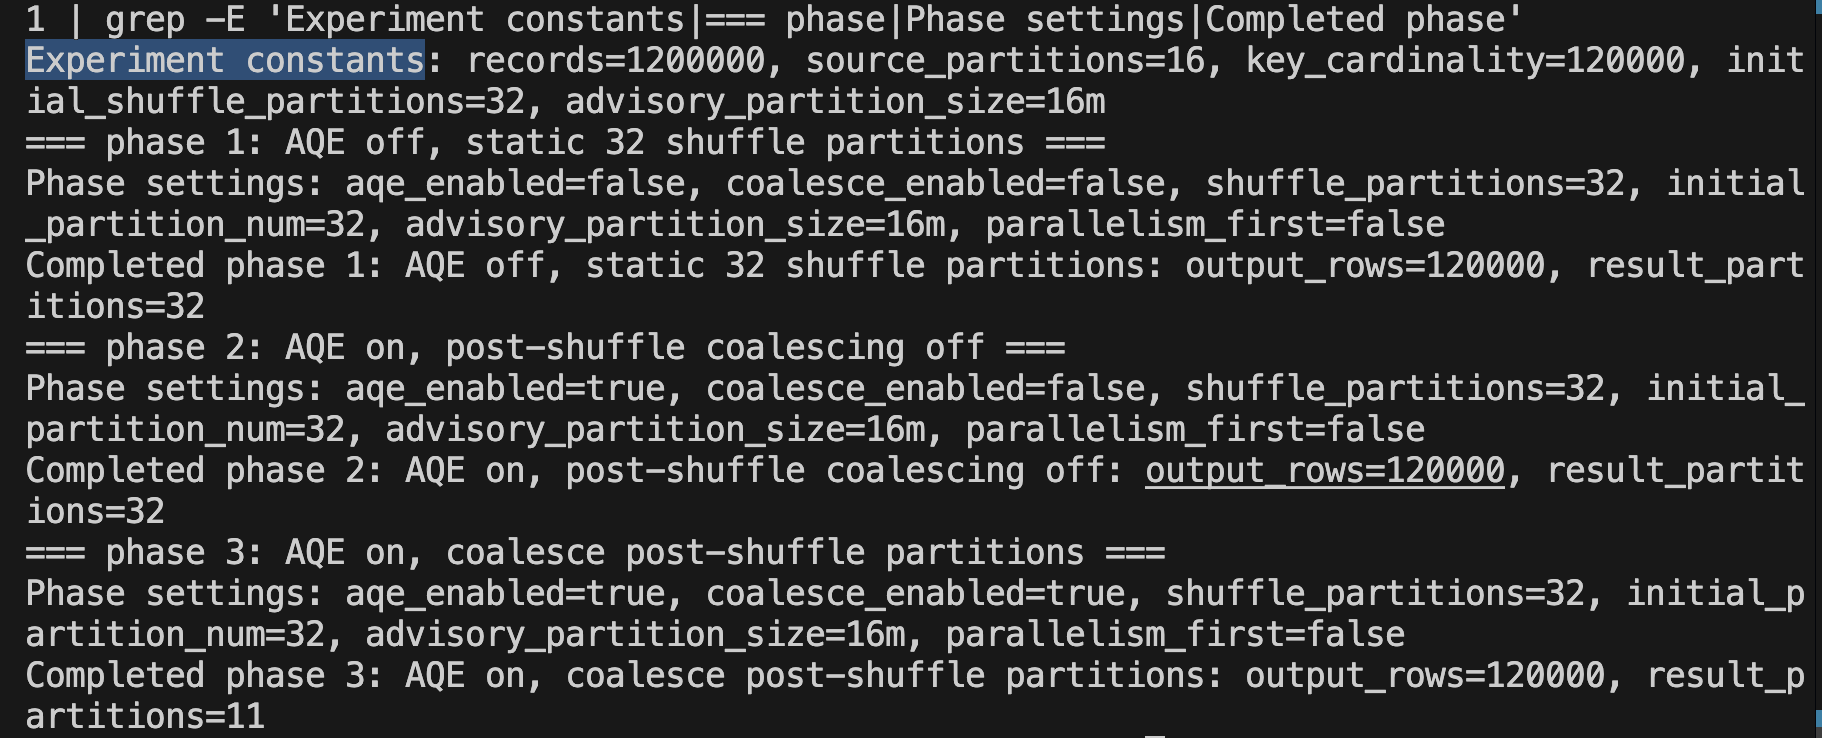
Jobs 頁很清楚地把三個 phase 排在一起。Phase 1 的 static execution 有 48 個 tasks:16 個 map tasks,加上 32 個下游 shuffle-read tasks。
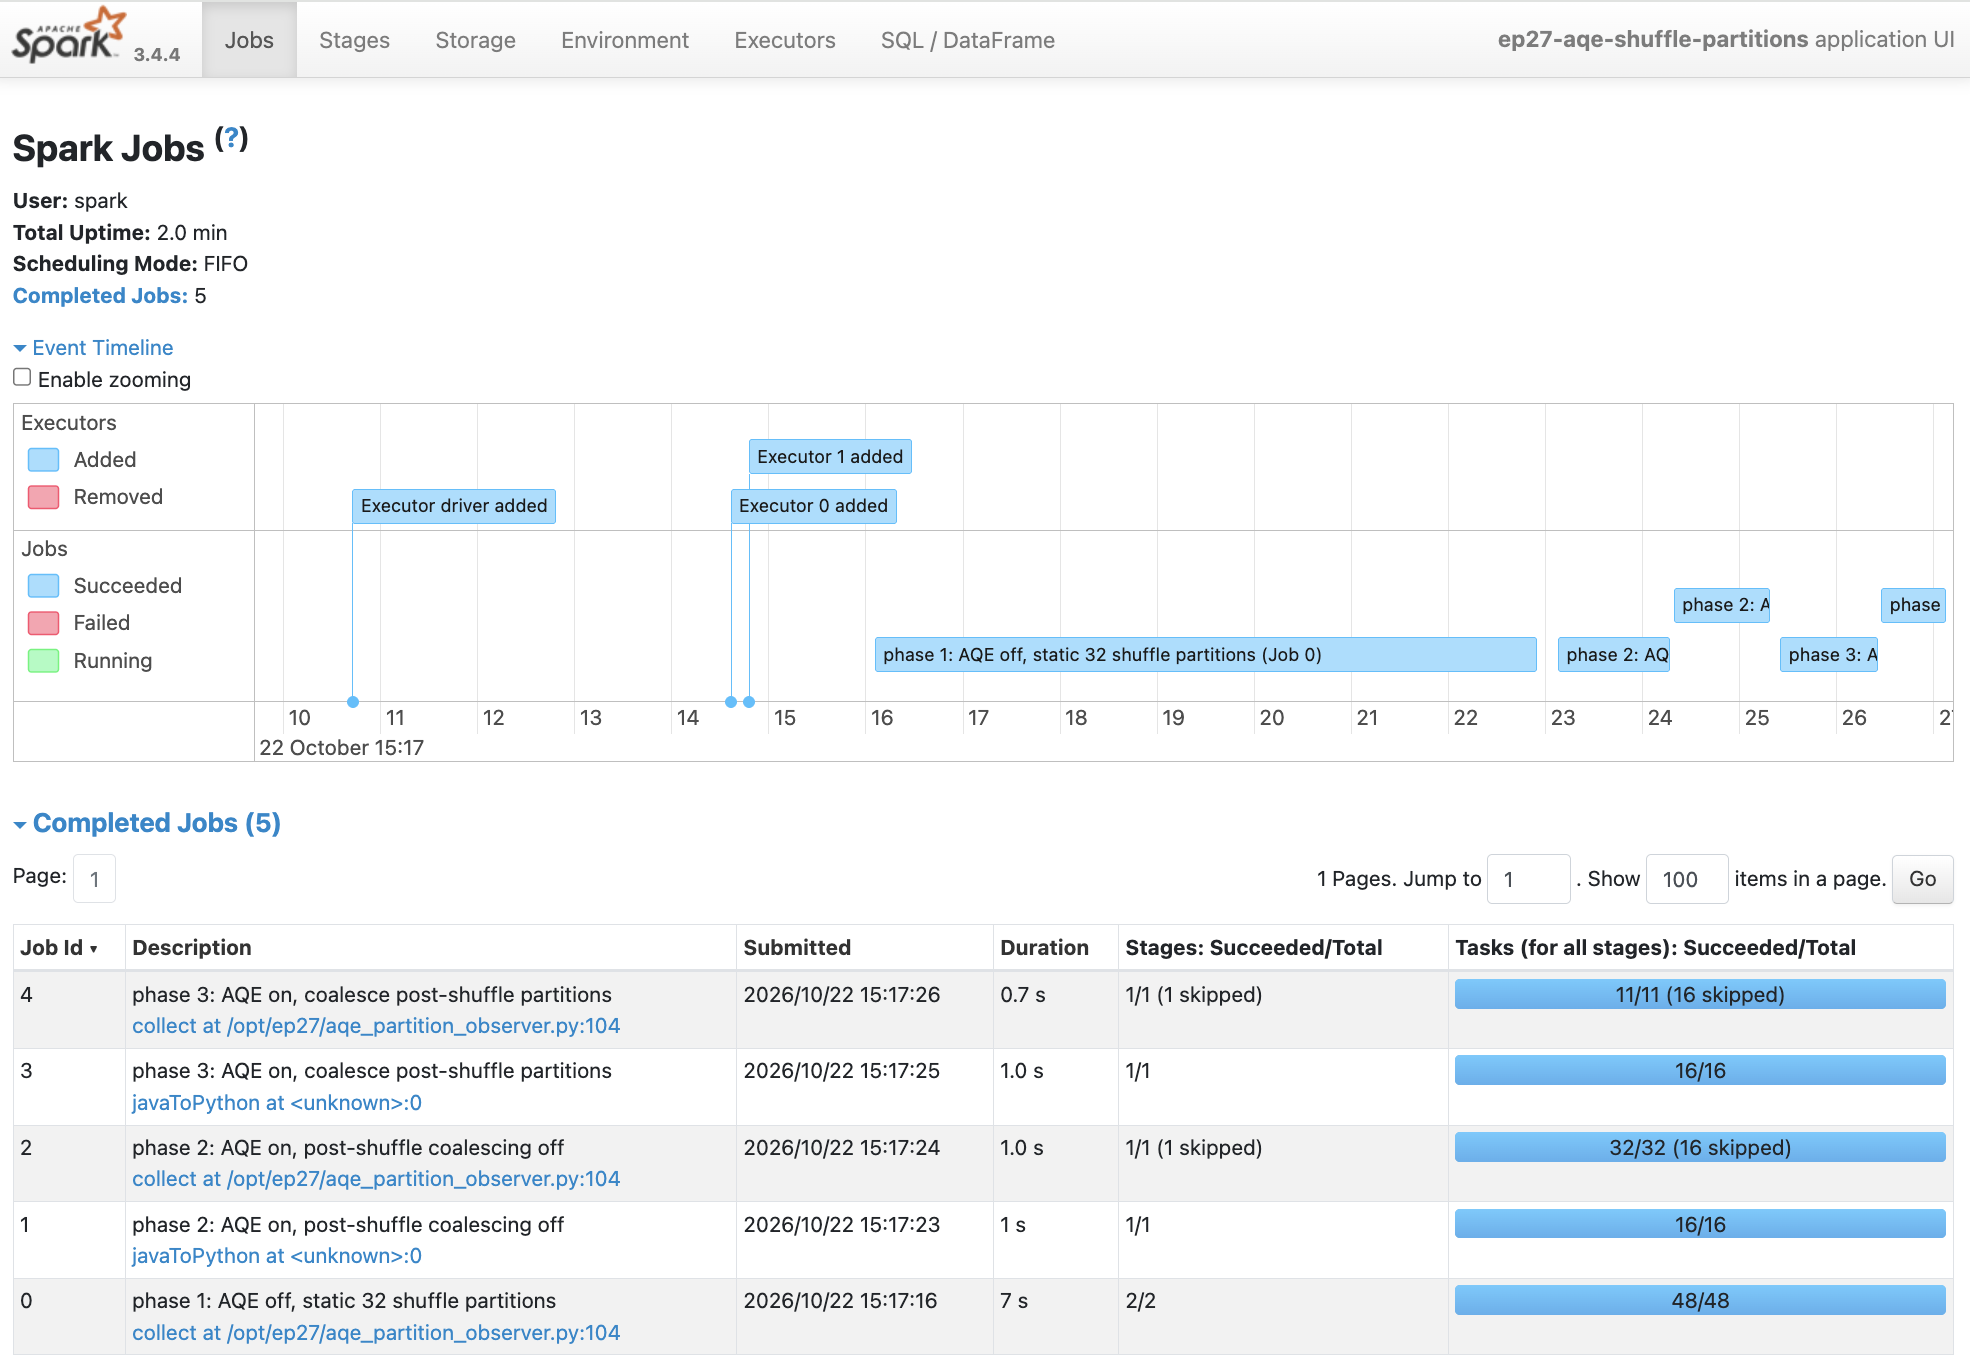
先看 Phase 1。Stage 0 的 16 個 tasks 寫出 151.1 MiB shuffle data;Stage 1 的 32 個 tasks 讀回同樣的 151.1 MiB。這是最直觀的基準:一開始設定 32 份,下游就照 32 份做。
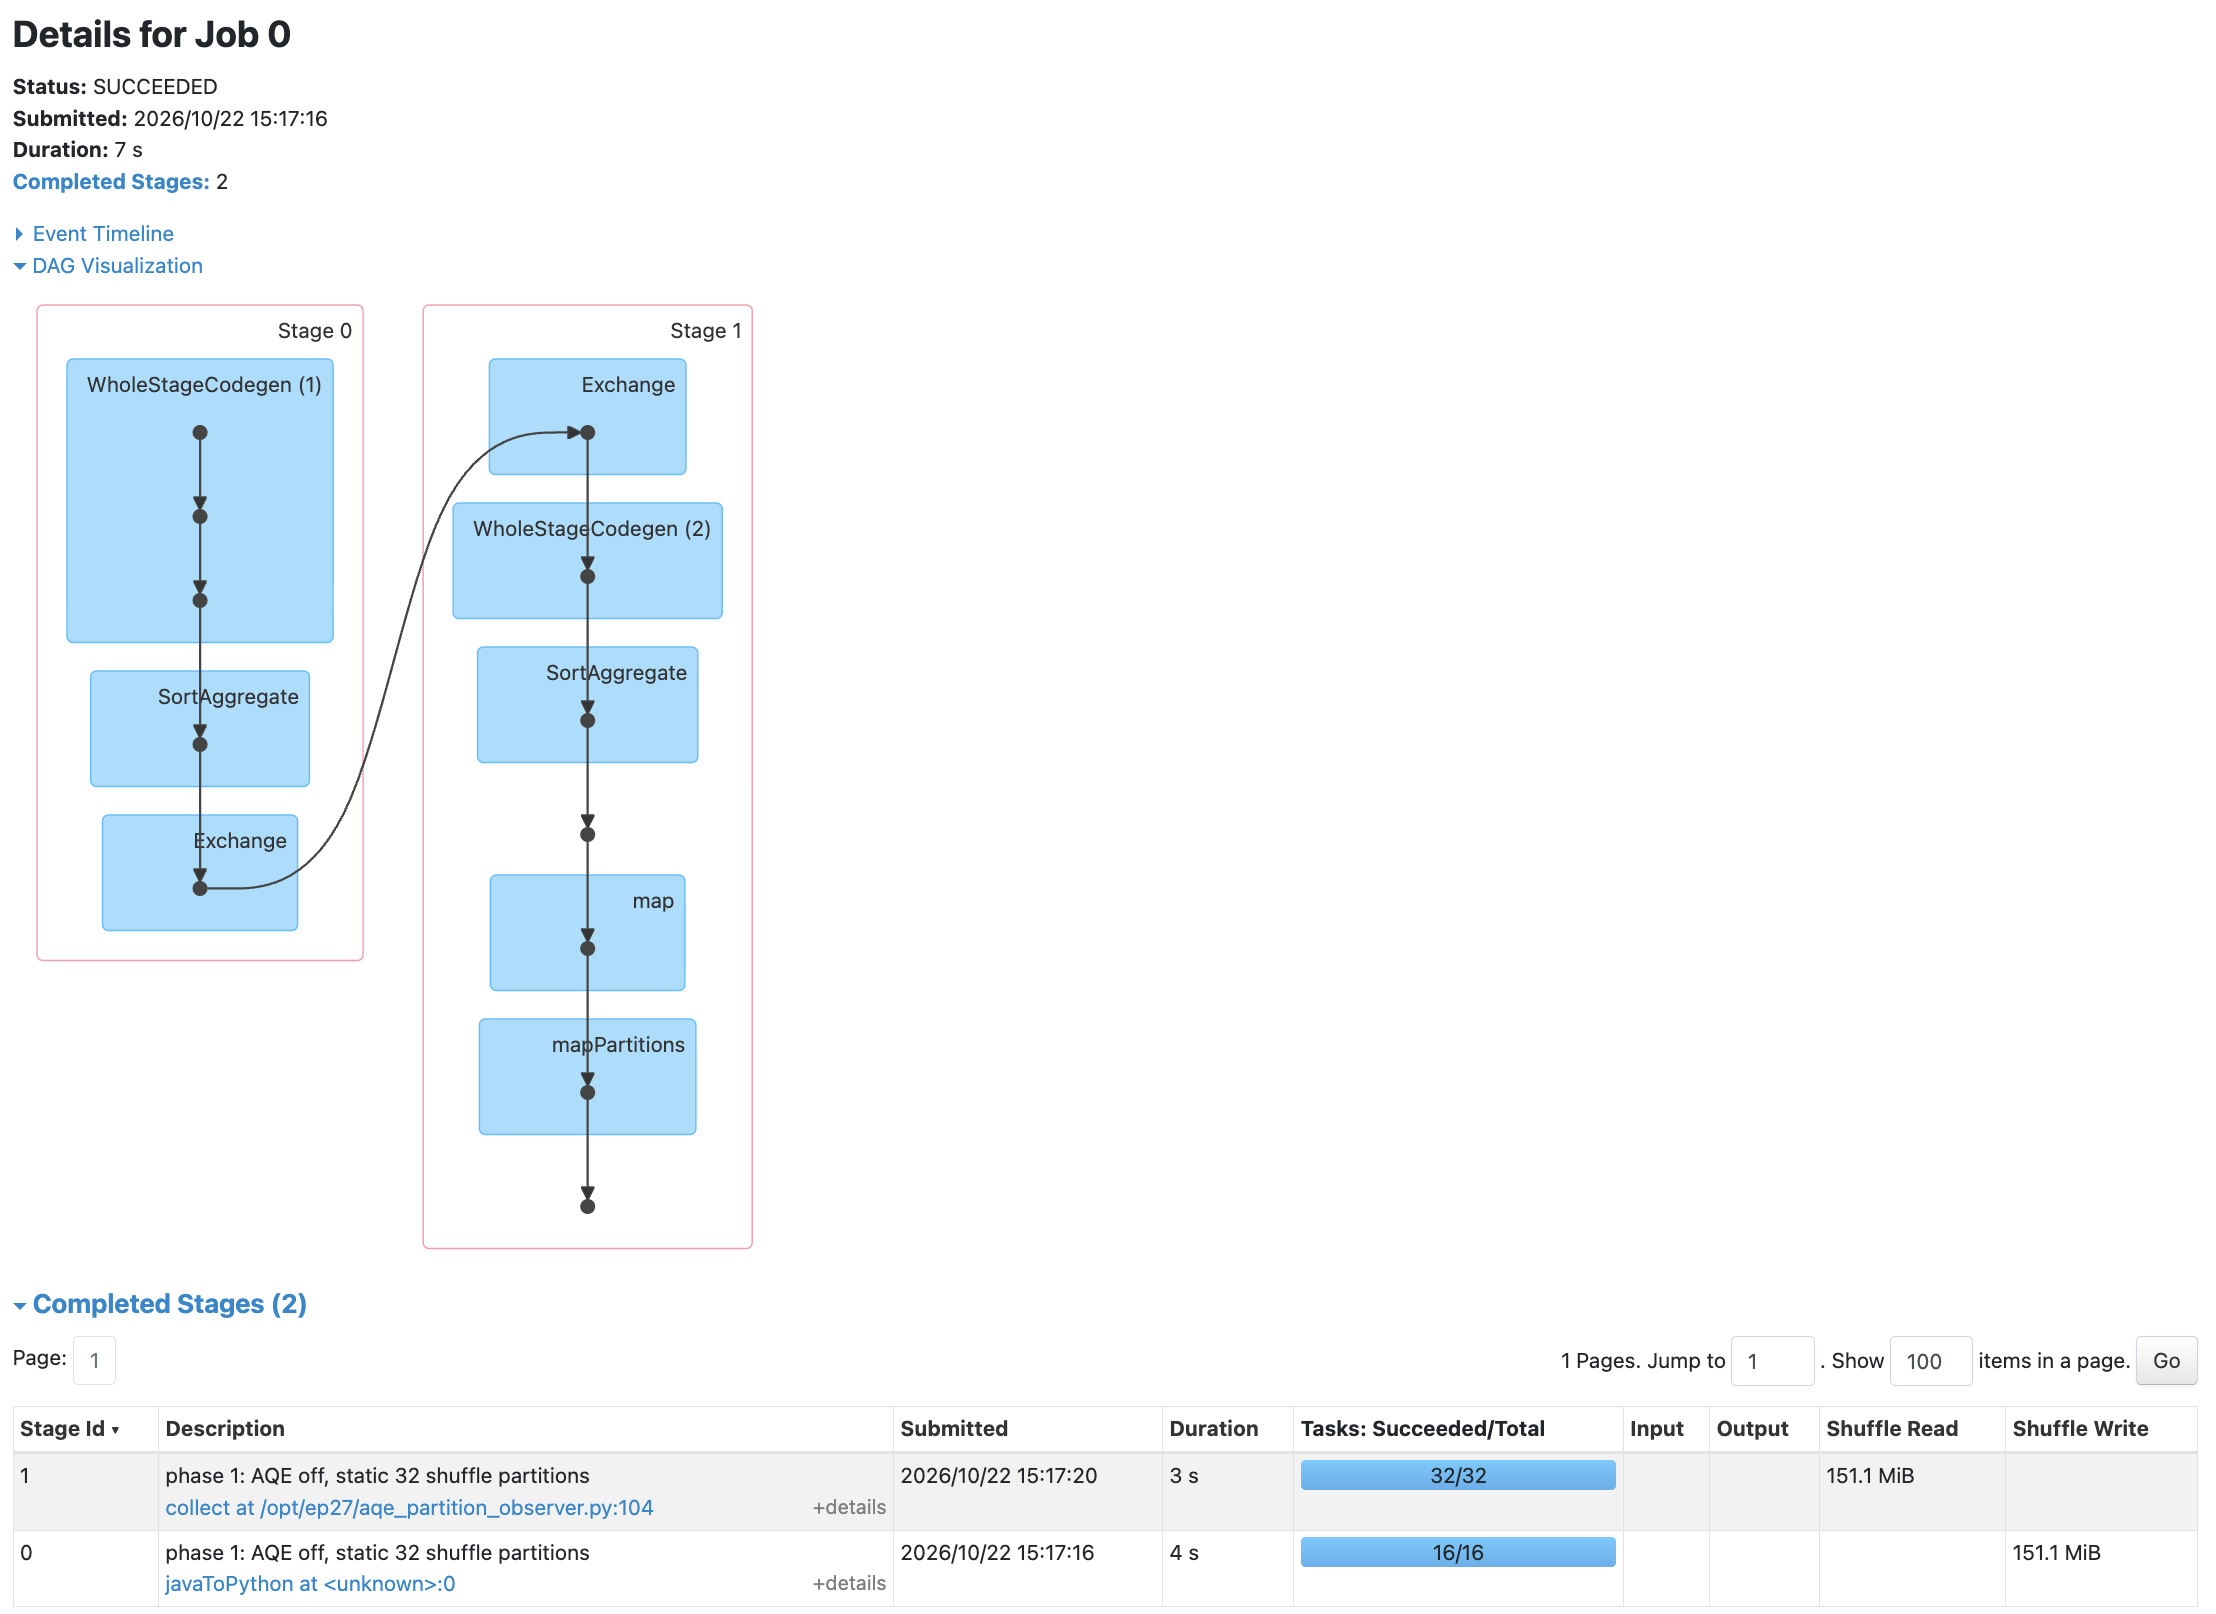
再看 Phase 2。AQE 已經開啟,畫面也出現了 skipped stage,但因為沒有開 partition coalescing,真正完成的下游 Stage 還是 32/32 tasks,也一樣讀取 151.1 MiB。這正好說明:AQE 是 Spark 可以使用的一套能力,不是打開後每一種調整都會自動發生。
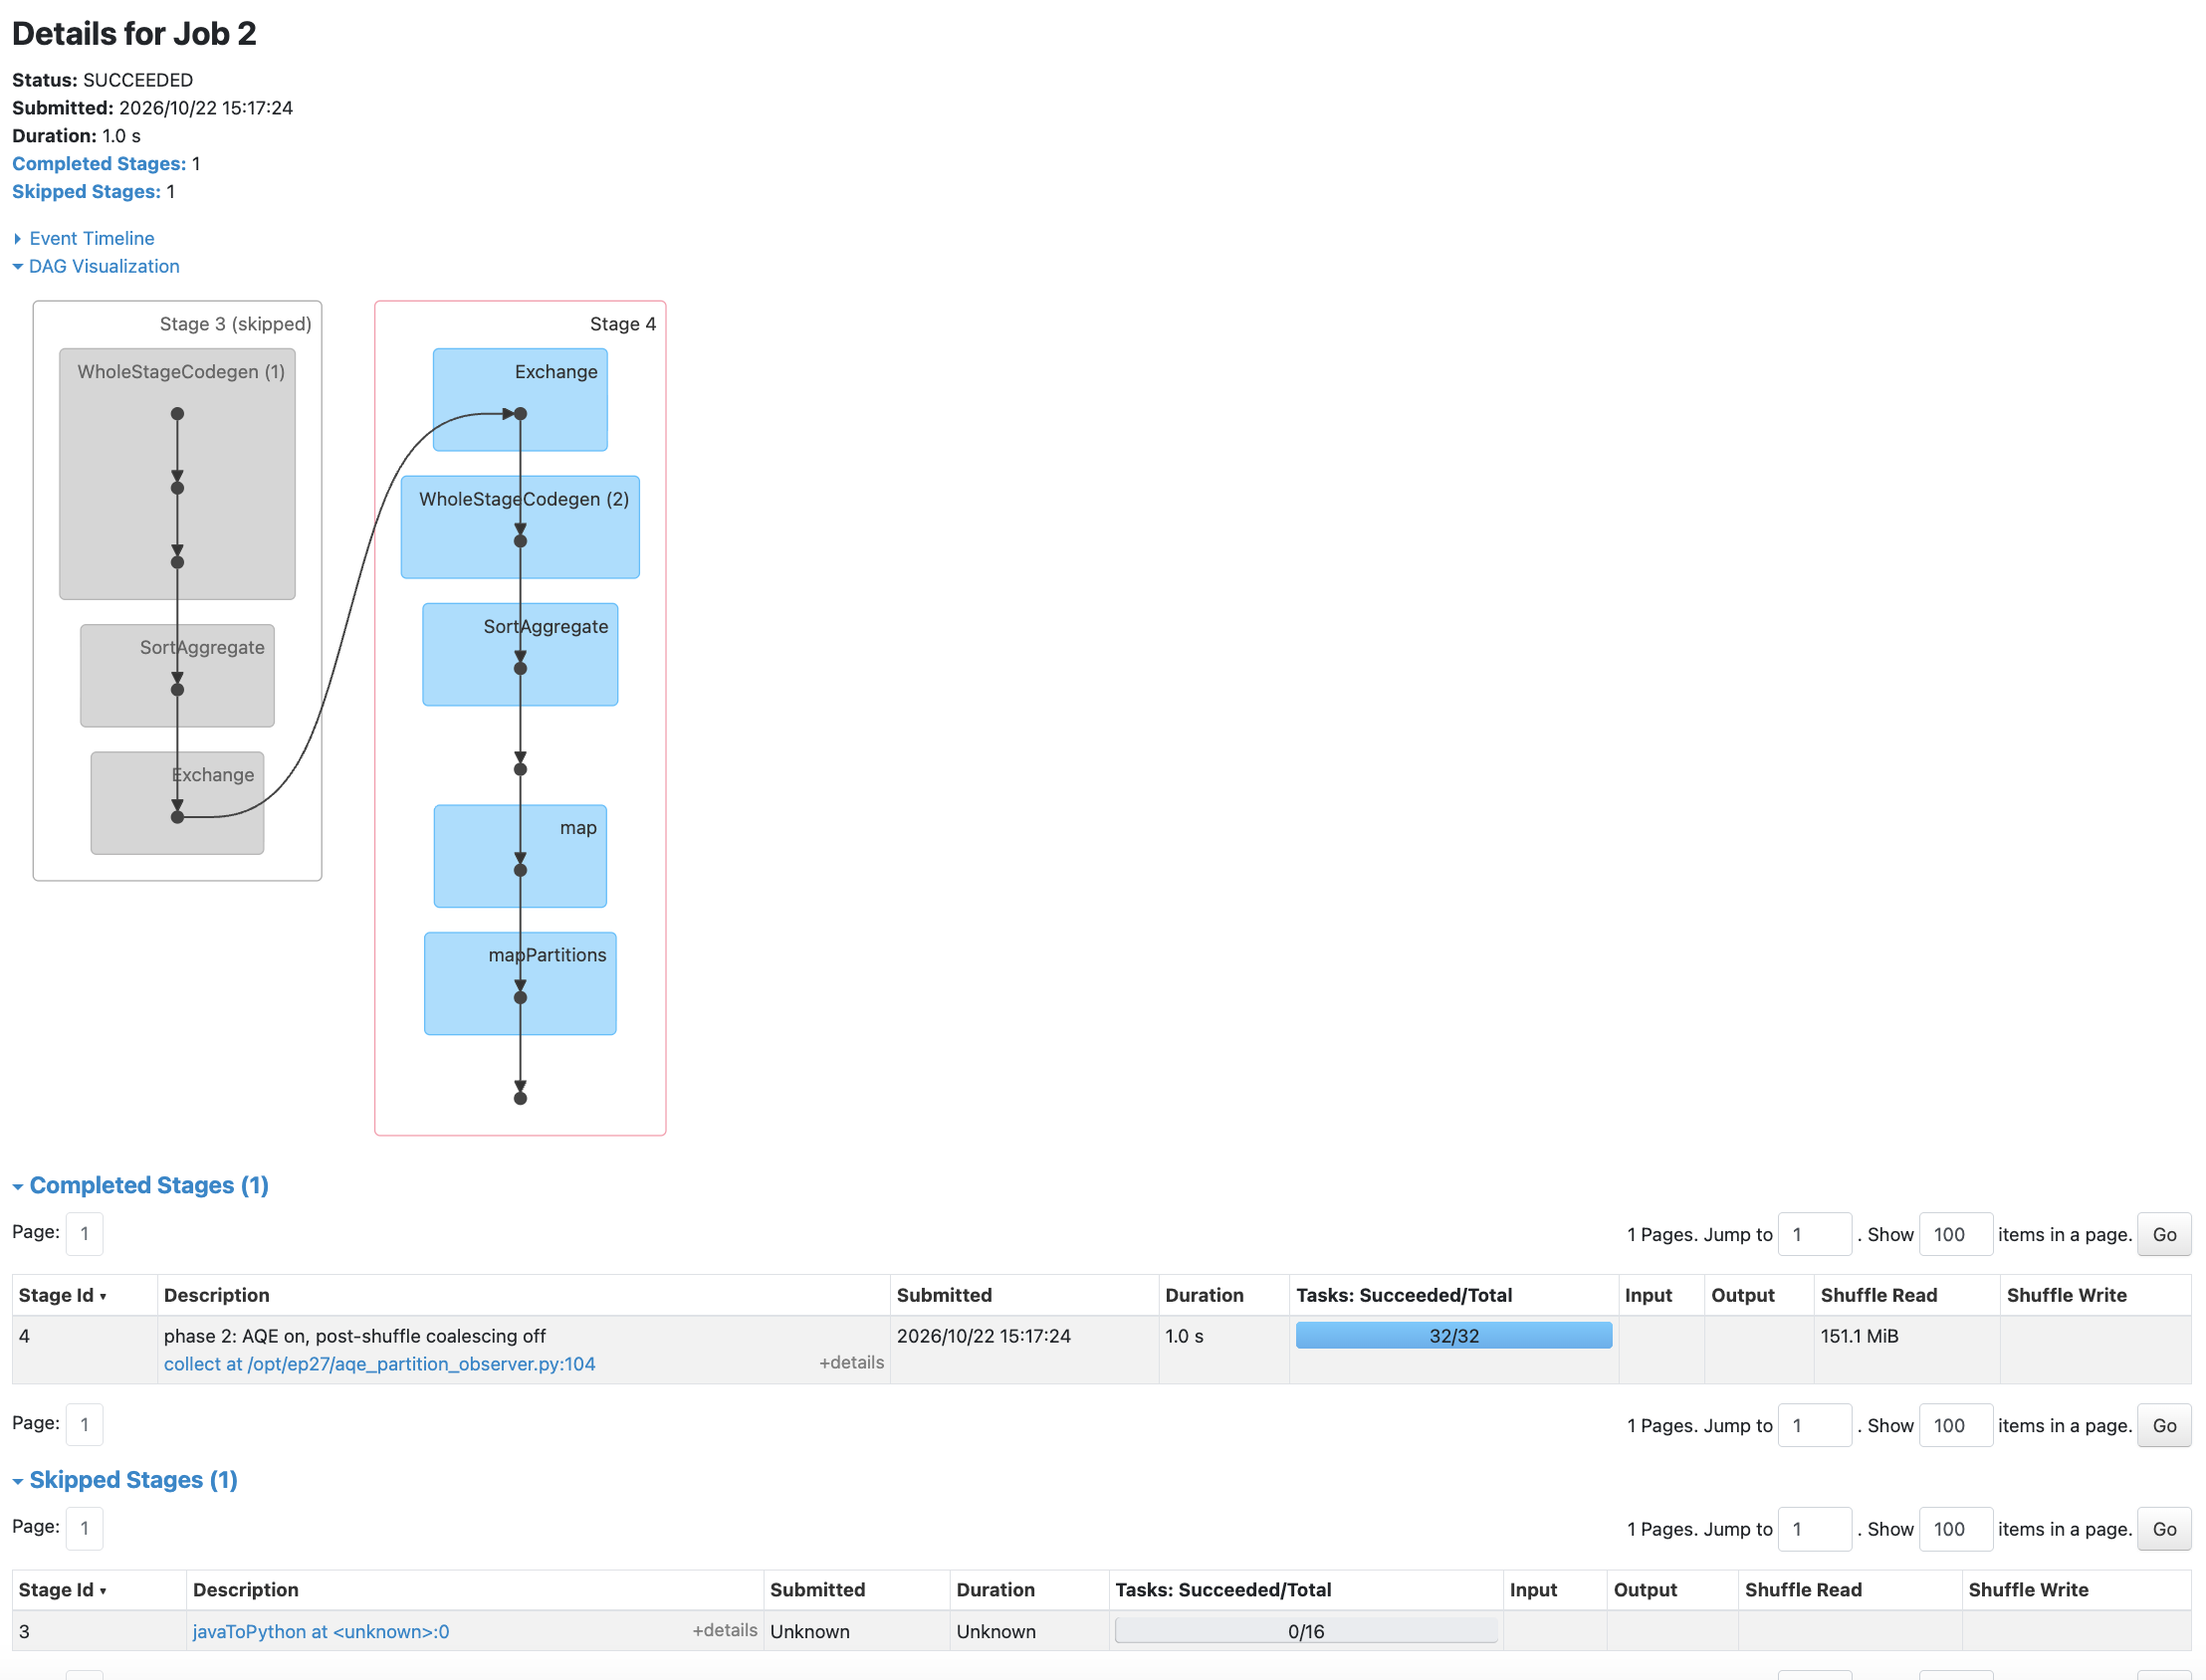
Phase 3 的上游一樣寫出 151.1 MiB shuffle data,差別只在 Spark 這次允許 AQE 合併。等 map-side 的真實資料量出來後,Spark 將原本 32 個 partitions 收斂成 11 個下游 tasks。
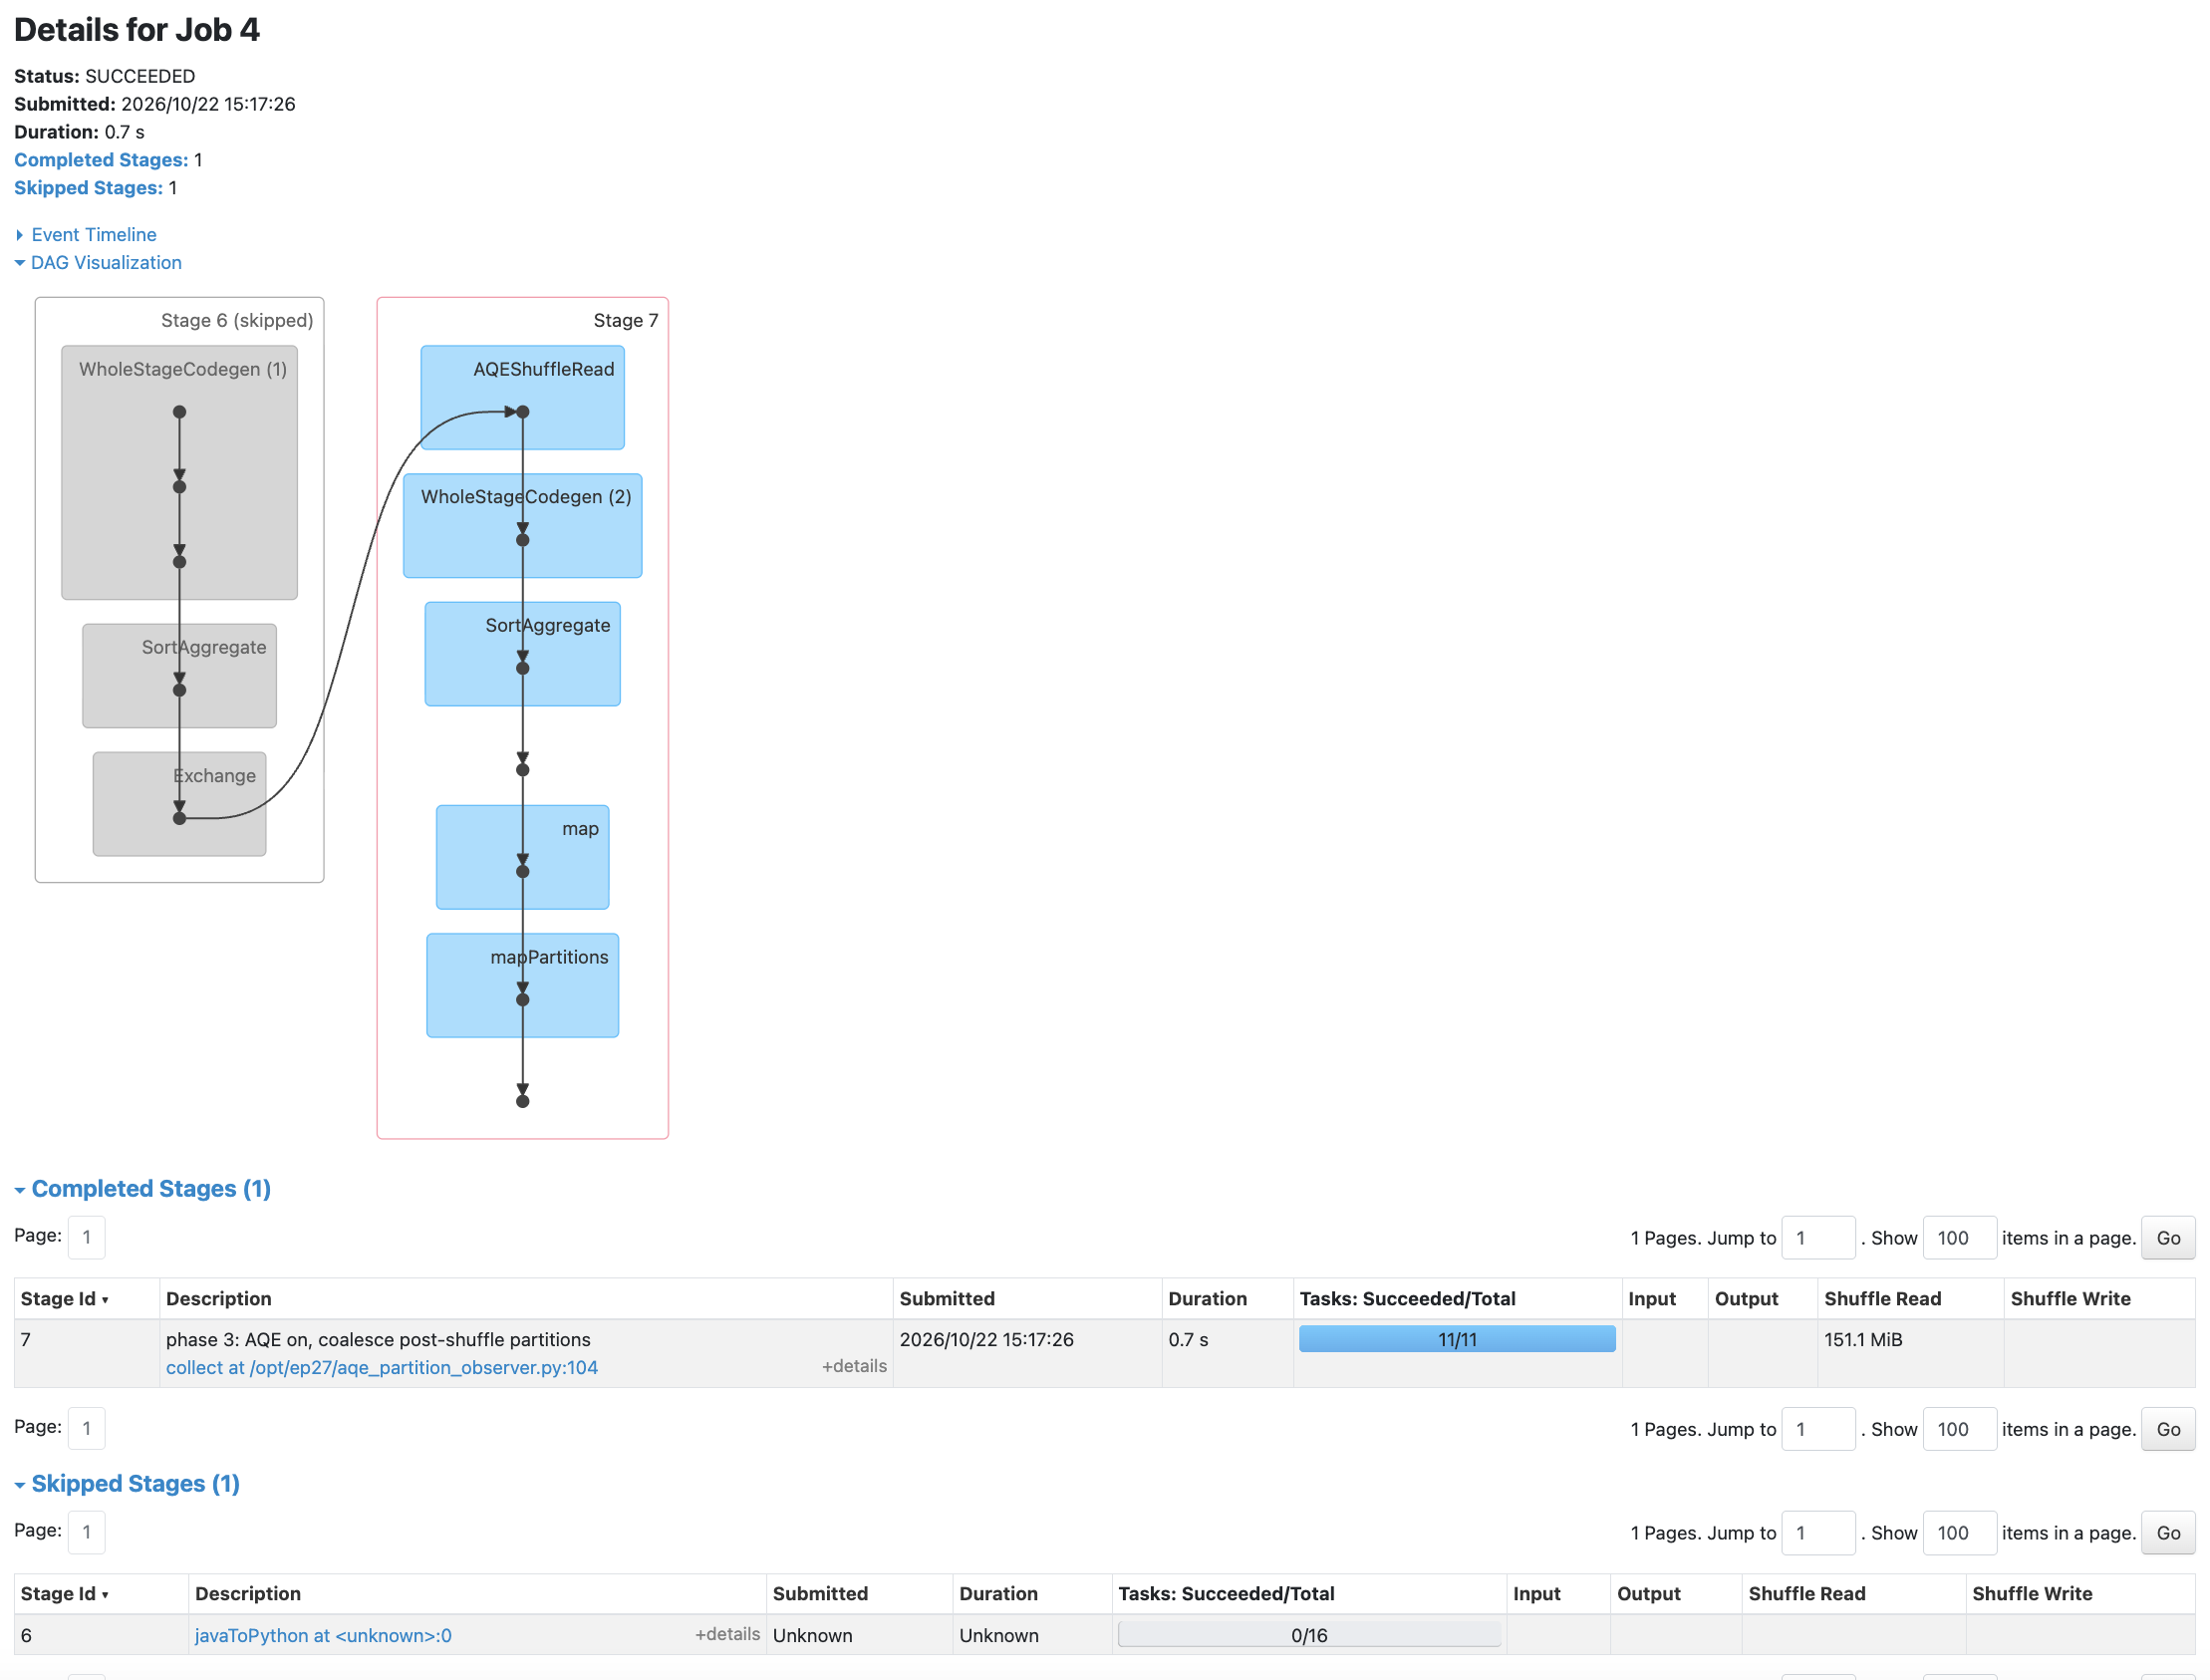
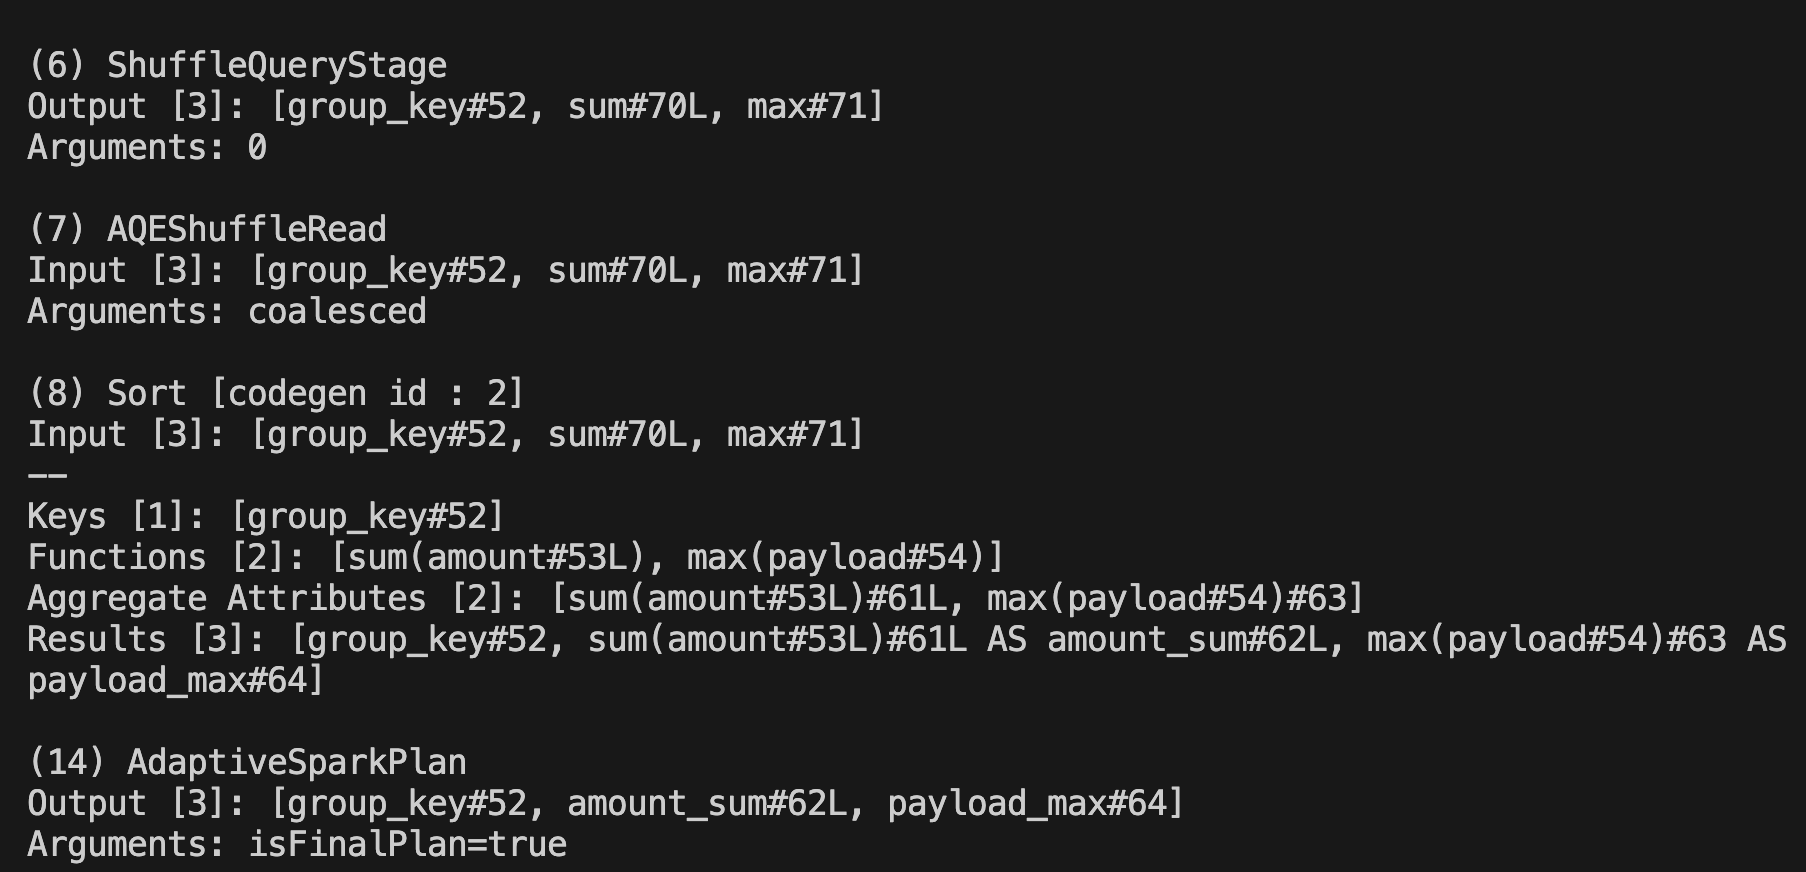
這裡值得注意的不是「11 比 32 小」,而是資料總量並沒有消失。Spark 仍要讀完 151.1 MiB,只是把原本比較零碎的讀取工作重新打包。final physical plan 裡的 AQEShuffleRead 和 coalesced,就是這次重新打包真的生效的證據。
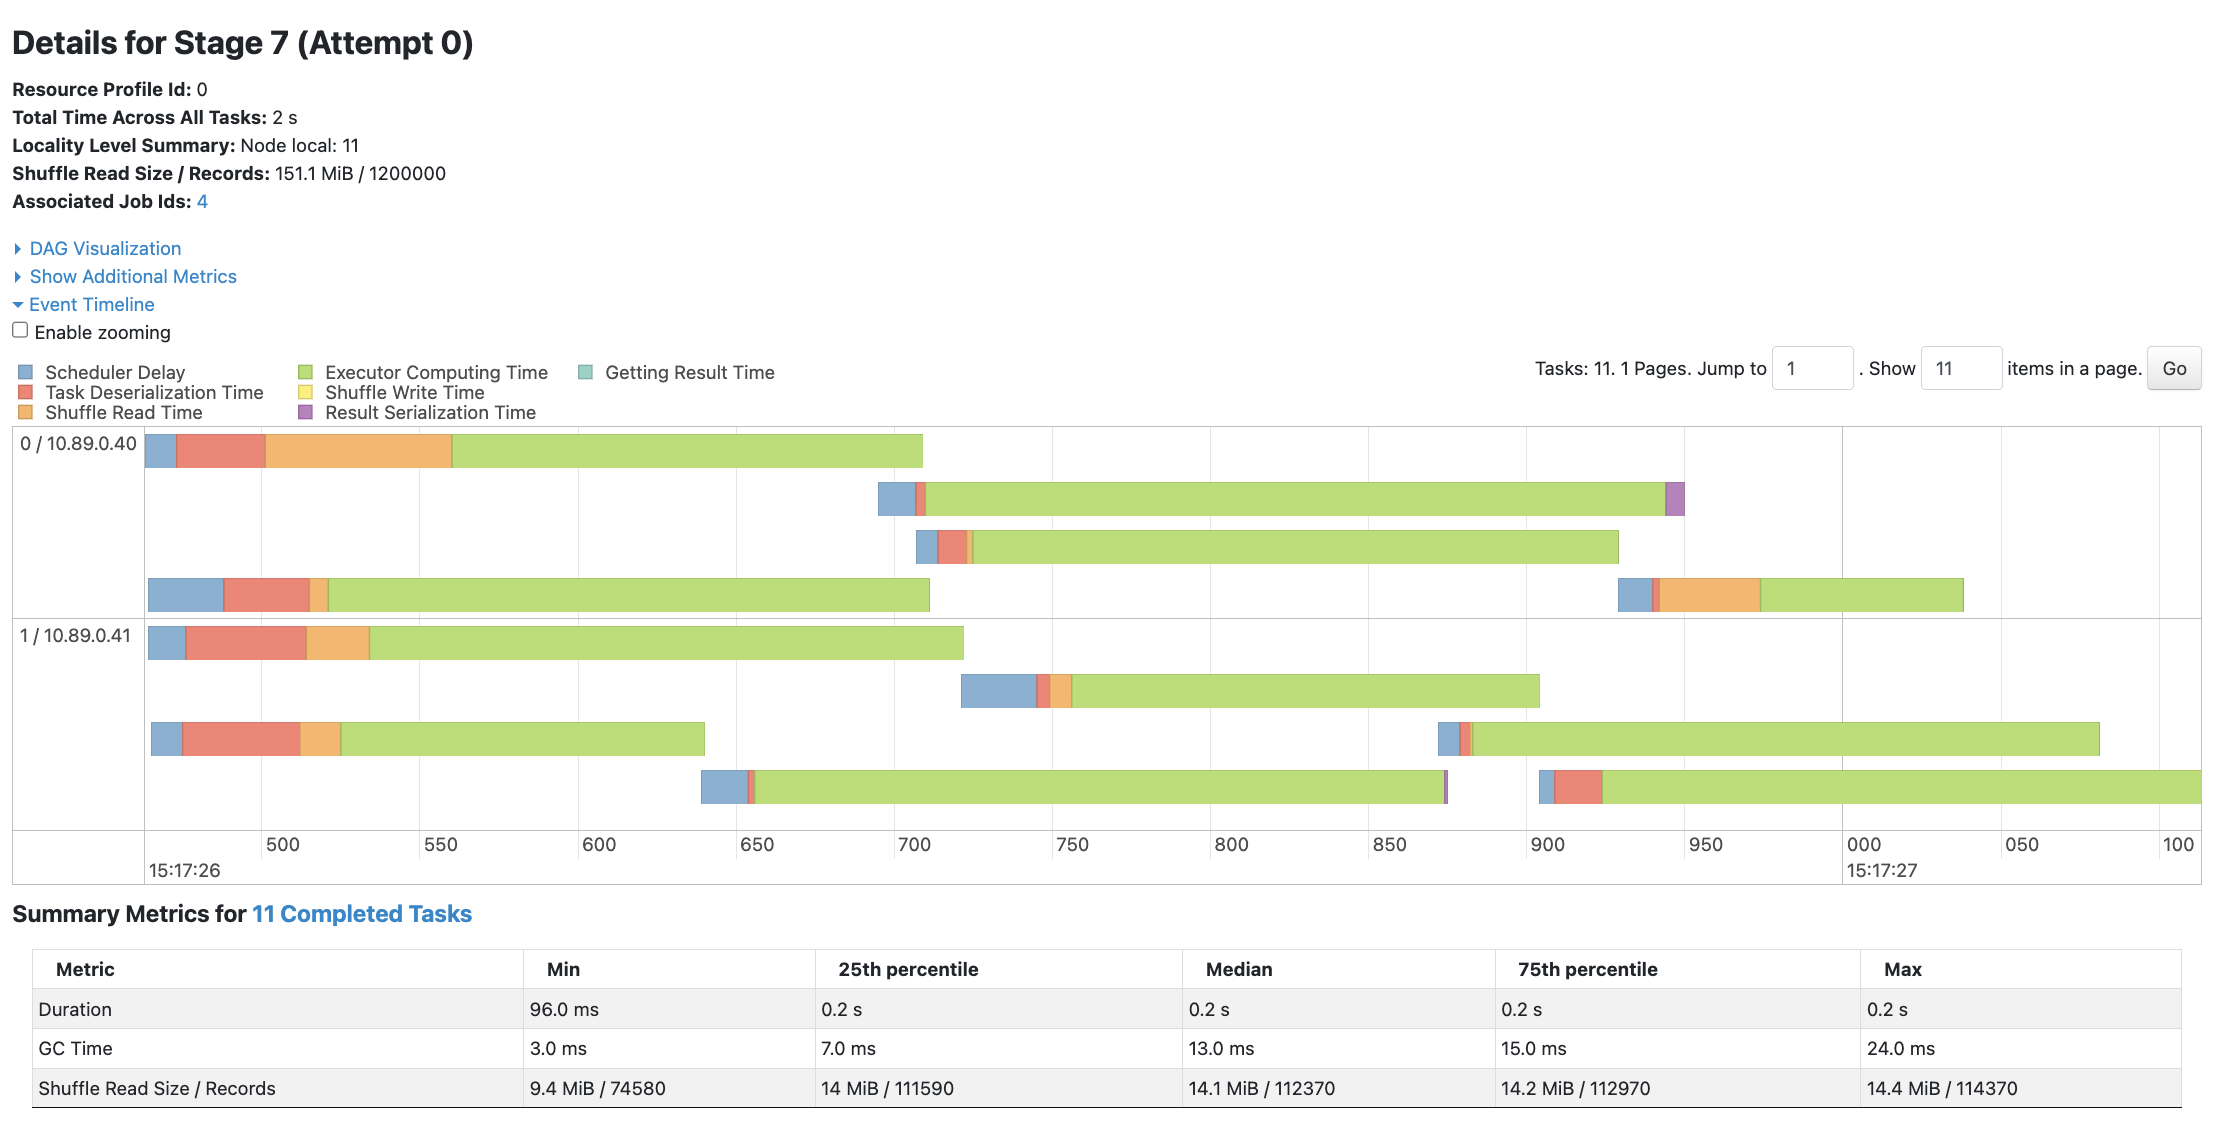
Phase 3 的下游 Stage 最後由 11 個 tasks 讀回 151.1 MiB、共 1,200,000 records。環境只有四個 task slots,所以這 11 個 tasks 還是得分批跑。這也提醒我:coalescing 的目的不是讓 task 數越少越好,而是少掉那些資料很少、卻仍要付 task 啟動與排程成本的工作。
這次是從 32 變成 11,不代表把 16 MiB 設進任何 job 都會得到 11 個 tasks。資料分布、filter 後剩多少資料、聚合縮小多少、cluster 有幾個 cores、設定的最小大小和 Spark 版本,都會影響最後結果。
與其從網路上找一個「最佳 partition 數」,我會先問:現在的 task 是太重,還是太碎?兩種情況的方向剛好不同。
64MB advisory size 當作可回退的起點。task 普遍太重時,再往更多初始 partitions 或較小目標大小測試;task 普遍太碎時,才考慮較大的目標大小。每次只改一組設定,保留前後證據。parallelismFirst=false。這是 Spark 官方文件針對 advisory-size tuning 的建議,但仍必須用自己的 workload 驗證。| 我看到的情況 | 我會先往哪裡查/調 |
|---|---|
| 大多數 task 都讀很多 shuffle 資料,還有 spill 或長 duration | 提高初始 partitions;再確認 Executor memory 與 advisory size 是否合理。AQE coalescing 不會把已經過大的 partition 拆開。 |
| 很多 tasks 很短,每個 task 的資料量都小 | 檢查 coalescing、advisory size 與 parallelismFirst,確認沒有把 task 數誤當成效能本身。 |
| 只有少數 task 特別大、特別慢 | 回看 key 分布與 skew;多切幾個 partitions 不一定能處理 hot key。 |
| AQE 開了,最後 task 數卻沒變 | 看 coalescing 開關、final plan,以及 partitions 是否真的夠小;這不代表 AQE 已失效。 |
AQE coalescing 解的是「shuffle partitions 太小、數量太多」。遇到下面這些情況,我會先往別處找原因:
partition 數沒有萬用答案。真正的目標是讓每個 task 拿到的資料量,和 Executor 的記憶體、可用平行度與這個 query 的工作型態相稱。
這次我真正學到,AQE 不是讓我從此忘記 spark.sql.shuffle.partitions。這個設定仍決定一開始切得多細;AQE 必須等實際 shuffle 資料寫出來,才能判斷哪些小份工作值得合併。這次實驗的 32 → 32 → 11,正好把兩件事拆開:AQE 單獨開啟不會讓 task 自己變少,開啟 coalescing 後才會依實際資料量收斂。
我也學到,調整時不該先背一個 partition 數字。先看 task 是普遍太大、普遍太小,還是只有少數特別大;再決定要增加初始切分、讓 AQE 合併,或回頭處理 skew。把設定、plan 和 task metrics 一起看,才能知道自己是真的減少不必要的工作,還是只是換了一個數字猜看看。
下一篇會處理另一種常見的慢 task:如果少數 task 不是因為資料比較大,而是碰上慢 Executor、GC pause 或節點暫時抖動,Spark 是否值得另外啟動一個副本,搶在原 task 前完成?
🚀 GitHub:\
Ep27|shuffle 的工作切太多、切太少怎麼辦?讓 AQE 幫忙收尾
🚀 spark-learning-lab 系列文章與實作:\
https://github.com/jeffery5bai/spark-learning-lab
Apache Spark 3.4.4 — Configuration:\
https://archive.apache.org/dist/spark/docs/3.4.4/configuration.html
Apache Spark 3.4.4 — SQL Performance Tuning:\
https://archive.apache.org/dist/spark/docs/3.4.4/sql-performance-tuning.html
Apache Spark 3.4.4 — Web UI:\
https://archive.apache.org/dist/spark/docs/3.4.4/web-ui.html

 jeffery5bai

 iThome鐵人賽
 看影片追技術