
Part 4 最後一天。
今天講一個做法,我在別的方法論裡沒看過。它來自另一個進行中的案子,那個案子的版控紀錄裡反覆出現一個詞:
誤診防線。
先講差別,因為這是它的全部價值所在。
一般的事後檢討記的是:發生了什麼、原因是什麼、怎麼修的。誤診防線記的是:下一個遇到這個問題的人,會忍不住相信什麼。而那是錯的。
看一個實際的例子就懂了。
情境:使用者回報「後端成功但前端顯示失敗」。
修好之後,那份筆記裡有一節就叫〈誤診防線(給下一個遇到的人)〉,內容大致是:
「後端成功 + 前端失敗」先查中介層的 log,不要先懷疑後端或交易回滾。
預覽的回滾是設計行為,看到回滾 ≠ 失敗。某個框架的緩衝上限設定對本專案無效——因為兩個中介層的 HTTP client
都是手動建立的 bean,那個屬性只作用於框架自動配置的 builder。
往設定檔加這個 key 不會有任何效果——要調上限只能改程式碼。容器記憶體與 JVM 堆疊不用動:16MB 是「單一回應」的上限、不是常駐配置。
如果未來把單次預覽的筆數上限調到數千以上,回頭重估 16MB 是否仍相稱——
兩個上限是一對,只調一邊就會重演這次的錯位。錯誤轉發函式會把所有非 HTTP 例外一律講成「請稍後再試」,真實例外只在 log 裡。
誤導性訊息是既知的取捨(不對外洩技術細節),查案一律以 log 為準。
注意這五條全部是「不要」和「無效」。
它們不是在告訴你答案,是在攔截你會走的錯路。
現在把它接回 Day 09。
Day 09 我講「AI 用先驗知識補空白」,舉了兩個場景:寫 UI 時補「現代後台該有的」、寫後端時補「一般 .NET 該有的」。這是第三個場景:除錯時補「一般 Spring 專案該有的」。
那個「調緩衝上限設定」的判斷,在一般專案裡是完全正確的。九成的教學會這樣教,九成的 Stack Overflow 答案會這樣回,而 AI 的訓練資料就是那些東西。它錯,只因為這個專案的 client 是手動建的。一個不在任何文件裡、只存在於某個設定類別裡的事實。
所以三個場景的形狀完全一樣:
| 階段 | AI 補什麼 | 為什麼合理但錯 |
|---|---|---|
| 寫 UI | 統計卡、批次操作 | 現代後台確實該有 |
| 寫後端 | 每支控制器包 try-catch | 一般專案確實這樣寫 |
| 除錯 | 調緩衝上限設定 | 一般專案確實有效 |
先驗知識在補空白:寫程式時補、除錯時也補。
而除錯時的補空白更難發現,因為除錯本來就是在猜。你不會覺得「提出一個假設」有什麼問題。
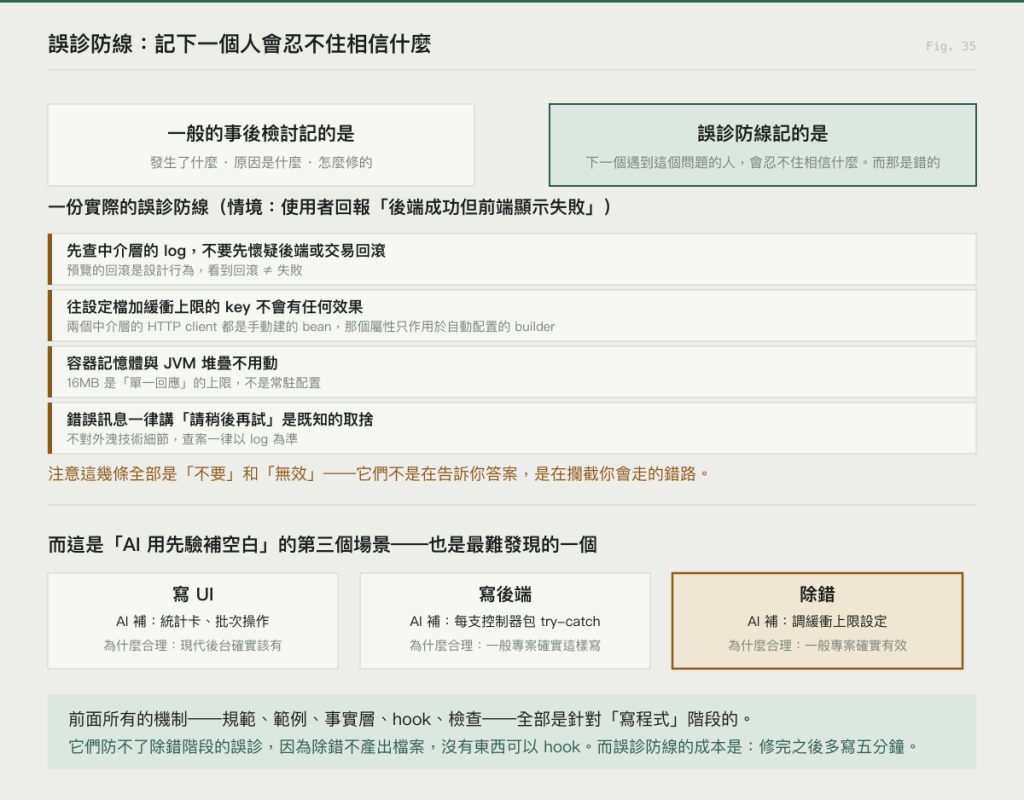
Part 1 到 Part 3 講的所有機制。規範、範例、事實層、hook、檢查。全部是針對「寫程式」階段的。它們防不了除錯階段的誤診,因為除錯不產出檔案,沒有東西可以 hook。
誤診防線是我看過少數幾個針對這個階段的做法。
(「唯一」這個字我原本寫了,後來拿掉。因為 Day 14 那個 code graph MCP 也是針對除錯階段的:讓 AI 查得到「這個 bean 是在哪裡建立的」,它就不會做那個推論。 差別在於一個是給事實、一個是擋詮釋。)
而且它的成本極低:修完問題之後,多寫五分鐘。
我把那個案子的幾份筆記讀過之後,歸納出四種內容。
一、「先查什麼,不要先懷疑什麼」
這一條是在給調查順序。因為誤診通常不是查錯地方,是查的順序錯了。先花三小時懷疑後端,才想到看中介層。
二、「這個做法無效,以及為什麼」
最有價值的一類。它攔截的是「看起來最合理的解法」。
而且要寫為什麼無效。不然下一個人會覺得「你大概沒試對」,然後再試一次。
三、「這個不用動」
反向的排除。告訴下一個人哪些東西不是原因,可以直接跳過。
四、「這個設計是刻意的,不是 bug」
例如上面那條「預覽的回滾是設計行為」「誤導性訊息是既知的取捨」。
這一類特別重要,因為它防的是下一個人「修好」一個本來就對的東西。
上面那份筆記還有一條,我覺得它自成一類:
如果未來把預覽筆數上限調到數千以上,回頭重估 16MB 是否仍相稱——
兩個上限是一對,只調一邊就會重演這次的錯位。
這不是誤診防線,這是未來的地雷預告。
它記錄的是:這次的 bug 是兩個設定值失去相稱造成的,而那個相稱關係沒有寫在任何地方。所以下次有人動其中一個,同樣的問題會再發生。我覺得這一類最難得,因為它需要在修完 bug 之後,多想一層「這個問題的結構是什麼」。
把 Part 4 收在一起看,會發現這七天講的是同一件事的不同切面:
| Day | 失效的位置 |
|---|---|
| 29 截圖盲區 | 驗證的範圍不夠 |
| 30 指標會騙人 | 驗證的指標不對 |
| 31 綠燈三假象 | 驗證的邏輯本身有 bug |
| 32 推論 vs 實測 | 根本沒有驗證,只有推論 |
| 33 官方工具 | 驗證的來源不可靠 |
| 34 安全網不對稱 | 驗證的分布不均勻 |
| 35 誤診防線 | 驗證之前的判斷就走錯路 |
七種失效,全部發生在「以為驗證過了」這一件事上。
而那個案子回顧索引的第一句話,我從 Day 29 引用到現在:
最貴的錯誤都不是技術不會,而是「以為驗證過了,其實沒有」。
如果要濃縮這七天,我會給三個問句。它們可以直接拿去用在任何一次「我驗證過了」的宣稱上:
一、我驗證的範圍,涵蓋了這次改動影響的東西嗎?
(Day 29:拍不到的東西不能宣稱驗證過)
二、我用來判斷的那個訊號,本身可靠嗎?
(Day 30–33:指標會騙人、綠燈是假的、工具會漏讀)
三、我這句話是量到的,還是推論的?
(Day 32:讀原始碼得到的是假設)
而如果三個都答得出來,還有第四個:
四、我沒驗到的部分,有沒有寫下來?
(Day 34:誠實標註盲區)
明天開始 Part 5。前面三十四天都在講「怎麼確認產出是對的」。不管是寫程式、建工廠、還是驗證。接下來要往回走一步,處理一個更早的問題:面對一套沒人看得懂的舊系統,你怎麼把「理解」建立起來。



 iThome鐵人賽
 看影片追技術