

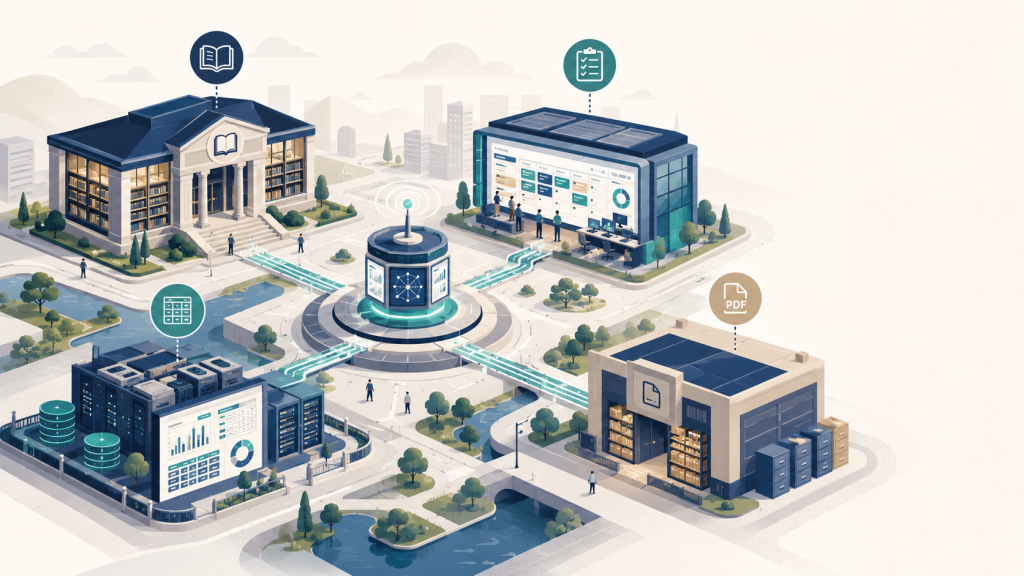
做到 Day 13,我們已經有兩種完全不同的資料取得方式:PDF 檢索增強生成(RAG)負責尋找文件知識,Google Sheets Data Tool 則負責取得與計算結構化數字。這時很容易冒出下一個想法:「既然不同資料可以做成 Tool,那是不是把公司所有系統都接進來就好了?」
技術上當然可以,但真正該先做的不是列出一長串 API 清單,而是先理解:企業知識到底分散在哪些地方?每一個系統保存的是什麼?哪一個來源才是真正的 Source of Truth? 這就是今天要建立的企業知識地圖(Knowledge Map)。
假設主管問:
「最近客服工單上升最多的是哪一類?這個類別的正式定義是什麼?改善專案現在做到哪裡?」
表面上看起來只有一個問題,實際上卻可能需要三個甚至四個不同資料來源才能完整回答。
Google Sheets 可能保存每天的客服工單,因此適合計算哪一種類別成長最多;Confluence 可能保存正式的分類定義與 SOP;Trello 或 Jira 則記錄改善專案目前的進度、負責人與截止日期;PDF 中可能還有過去的分析報告或正式政策。
整體可以理解成:
一個商業問題
      ↓
需要哪些資訊?
      ↓
┌────────────────┬────────────────┐
│ Google Sheets  │ Confluence     │
│ 數字與明細     │ 規範與定義     │
├────────────────┼────────────────┤
│ Trello / Jira  │ PDF RAG        │
│ 任務與進度     │ 報告與文件     │
└────────────────┴────────────────┘
      ↓
整合成回答
這張圖就是最基本的 Knowledge Map。它的價值不在於畫得多漂亮,而是逼我們先回答一個很重要的問題:
哪一種問題,應該去哪一個 Source of Truth 找答案?
如果這件事沒有先定義清楚,即使後面接了十個 Tool,模型也只會面對十個「看起來都可能有答案」的地方。
最簡單的 Knowledge Map 可以只記錄系統名稱和資料類型,但真正放進企業場景後,通常還需要更多資訊。
例如可以整理成:
| 資料來源 | 保存內容 | 更新頻率 | 主要用途 | Source of Truth |
|---|---|---|---|---|
| Google Sheets | 工單、銷售、營運數字 | 每日 | 精確查詢與計算 | 是 |
| Confluence | SOP、名詞定義、流程文件 | 不定期 | 正式知識與規範 | 是 |
| Trello / Jira | 任務、Owner、Deadline | 即時 | 專案狀態 | 是 |
| 政策、歷史報告、簡報 | 低 | 歷史文件與參考資料 | 視文件而定 |
如果要再往企業正式使用的方向走,還可以補上資料負責人、更新時間、權限範圍、正式版本標記,以及來源發生衝突時的處理規則。
因此 Knowledge Map 真正回答的不是單純的:
「資料在哪裡?」
而是:
「什麼資料在哪裡、由誰負責、多久更新,以及發生衝突時應該相信誰?」
跨來源查詢開始出現後,很快就會碰到一個非常真實的問題:不同系統可能同時有答案,而且內容還不一致。
例如 Confluence 寫著差旅住宿費上限是 3,500 元,但某份 PDF 還是舊版的 3,000 元;Google Sheets 的最新銷售額和上週簡報中的數字不同;Trello 顯示任務已延遲,但會議紀錄仍寫著「預計本週完成」。
這時不能讓模型自己挑一個「看起來合理」的版本,而是應該事先定義來源衝突的判斷方式。
至少需要區分兩個概念:Authority(權威性) 與 Freshness(新鮮度)。Authority 代表哪個來源有資格定義這件事情,Freshness 則代表資料最後更新的時間。最新的資料不一定最正式,而最正式的文件也不一定代表目前最新狀態。
| 衝突情境 | 建議判斷方式 |
|---|---|
| PDF 與 Confluence 的政策定義不同 | 比較文件狀態、生效日期與內容負責人,以指定的正式版本為準 |
| Google Sheets 數字與簡報報告不同 | 優先保留原始結構化資料、查詢條件與查詢時間,簡報作為解讀 |
| Trello / Jira 狀態與會議紀錄不同 | 以團隊指定的專案系統與最後更新時間為主要依據 |
| 無法判斷哪個來源較權威 | 並列差異、來源與更新時間,交由內容負責人確認 |
例如 AI 發現兩份文件提供不同答案時,與其自行選擇其中一個,更可靠的回答方式是:
目前找到兩個不同版本:

Confluence:
住宿費上限為 3,500 元
最後更新:2026-07-01
狀態:Current Policy

Travel_Policy_2025.pdf:
住宿費上限為 3,000 元
文件日期:2025-01-01

依目前資料,Confluence 被標記為現行正式政策,
因此優先採用 3,500 元。
如果系統無法確定哪一個才是正式版本,就應該把衝突呈現出來,而不是偷偷替使用者做決定。
既然我們已經會做 RAG,一個看似簡單的方案是:把 Google Sheets、Confluence、Trello、PDF 全部轉成文字,再做 Embedding 丟進同一個向量資料庫。這樣只需要一套 Retrieval,好像最方便。
問題是,這麼做會失去不同資料原本的特性。
結構化數字需要的是精確篩選、Aggregation 與計算;專案進度通常需要查詢目前最新狀態;正式規範適合文件搜尋;權限敏感資料則最好繼續由原始系統控制存取權限。
例如使用者問:
「目前有多少張逾期工單?」
最合理的方式應該是查詢原始資料:
status != completed
due_date < today
→ COUNT()
而不是把每一張工單轉成 Embedding,再用「逾期工單」進行語意搜尋。前者要的是精確條件,後者解決的是語意相似性,本來就是不同問題。
如果硬把所有資料塞進同一個 RAG,最後常會遇到:
因此 Data Machi 的方向不是建立一個「萬能知識庫」,而是:
讓資料留在最適合自己的系統,再透過 Tool Layer 提供一致的存取方式。
知道企業資料散落在不同系統後,下一個問題通常是:「那我是不是應該把 Confluence、Trello、Jira、Notion 全部接起來?」
答案仍然不是越多越好。
是否值得串接一個新系統,應該先問:
這個資料來源是否真的回答了工作流程中不可缺少的一個問題?
如果團隊的正式定義與 SOP 都存在 Confluence,那建立 Confluence Tool 就有明確價值;如果專案進度都在 Trello,那 Project Tool 就應該從 Trello 取得資料。若公司使用 Jira、Notion、SharePoint 或自建資料庫,架構原則完全相同,不需要為了導入 Data Machi 把所有資料搬到新的平台。
可以先建立這種對照:
| 工作問題 | 需要的資料 | 來源 | 是否需要 Tool |
|---|---|---|---|
| KPI 怎麼定義? | KPI 定義文件 | Confluence | 是 |
| 本月 KPI 是多少? | 最新數據 | Google Sheets | 是 |
| 改善任務進度? | Project Status | Trello | 是 |
| 去年分析結論? | 歷史報告 | 已有 RAG | |
| 員工電話是多少? | 與工作流程無關 | HR System | 暫時不要接 |
最後一列其實很重要。企業裡存在的資料,不代表全部都需要接入 AI。只有當資料對目前要完成的工作有明確價值,而且權限與風險可以管理時,才有必要建立 Tool。
如果最後決定接 Trello 或 Confluence,做法仍然延續前面建立的幾個原則:Secret 不放 GitHub、先用匿名測試資料、先建立最低所需權限,確認 API 本身可以正確讀取之後,再把 Tool 交給模型。
例如 Backend 可以使用環境變數保存必要設定:
TRELLO_BOARD_ID=
TRELLO_API_KEY=
TRELLO_TOKEN=

CONFLUENCE_URL=
CONFLUENCE_USERNAME=
CONFLUENCE_API_TOKEN=
Trello 與 Confluence 雖然同屬 Atlassian 生態系,但實際使用的認證方式與 API 仍然不同。因此 Tool Layer 的另一個價值,就是把這些技術差異包起來,讓上層不需要理解各服務的認證與請求細節。
不論實際使用哪一種 API,安全原則都一樣:不要把 Token 放在前端,也不要直接寫進程式碼。Backend 從 Environment Variables 取得 Secret,再代表系統向外部服務發出請求。
這裡有一個很容易被忽略,但非常重要的觀念:Backend 使用哪一個帳號的 Token,它通常就擁有那個帳號可以存取的資料範圍。
例如 Data Machi 使用一個管理者帳號建立的 Confluence API Token。即使一般員工原本只能看到特定幾個 Space,只要 Backend 沒有額外做權限檢查,AI 就可能透過管理者帳號查到更多內容。
流程可能變成:
一般使用者
    ↓
Data Machi
    ↓
使用 Admin Token
    ↓
Confluence
    ↓
取得 Admin 可以看到的內容
問題在於,原始系統的使用者權限在這個過程中被「共用 Backend Account」繞過了。
因此第一版如果所有使用者本來就應該看到相同資料,比較安全的方式通常是建立一個專門的 Integration Account,只給它必要的 Read Permission,並限制可以存取的 Board、Space 或資料範圍。
企業應用常見的認證方式,大致可以分成兩種。
| 模式 | 說明 | 適合情境 |
|---|---|---|
| 固定憑證 | Backend 使用同一組低權限整合帳號,所有使用者共用相同資料範圍 | 個人專案、內部測試、固定 Board 或 Space |
| 個別授權 | 每位使用者使用自己的帳號授權,依原本個人權限取得資料 | 不同使用者應看到不同內容、多組織或 SaaS 產品 |
固定憑證的架構比較簡單,例如:
所有 Data Machi 使用者
        ↓
同一個 Integration Account
        ↓
固定的 Confluence Space / Trello Board
個別授權則可能變成:
User A → User A Token → User A 可看的資料
User B → User B Token → User B 可看的資料
User C → User C Token → User C 可看的資料
後者通常需要 OAuth、使用者登入、Token 儲存、Token Refresh 與撤銷機制,因此複雜度會明顯提高。
如果目前 Data Machi 的使用情境是「所有使用者共用同一批企業資料」,第一版使用固定、低權限、只讀的 Integration Account 通常已經足夠。等未來真的出現「A 使用者不能看到 B 使用者的資料」這類需求,再升級成個別授權會比較合理。
對 Coordinator 來說,它不應該知道 Confluence API 要打哪一個 Endpoint、Trello 怎麼驗證 Token,或 Google Sheets 怎麼取得 Worksheet。
Coordinator 真正需要知道的是:
Tool Name
Tool Description
Input
Output
例如:
| Tool | 負責的能力 |
|---|---|
query_google_sheets |
查詢與計算結構化數據 |
search_documents |
搜尋 PDF 與文件知識 |
search_confluence |
搜尋正式定義、SOP 與知識頁面 |
get_project_status |
查詢專案狀態、Owner 與 Deadline |
這就是 Tool Abstraction(工具抽象層) 的價值。
假設今天專案管理系統使用 Trello,未來公司全面改成 Jira,上層 Workflow 不一定需要整個重寫。我們可以保留:
get_project_status(project_name)
然後只修改底層:
原本:
get_project_status
      ↓
Trello API

未來:
get_project_status
      ↓
Jira API
只要 Tool 對上層提供的功能與輸出結構維持一致,Coordinator 不需要知道底層系統已經換掉。
因此 Tool 不只是「接 API」,它也是把業務能力和技術實作隔開的一層介面。
如果要把 Data Machi 套到自己的工作場景,現在可以先不要急著寫程式,而是拿 Day 05 定義的工作流程重新檢查一次。
至少列出三件事情:
例如:
| 工作資訊 | 現在去哪裡找 | Source of Truth | 是否需要即時 |
|---|---|---|---|
| KPI 定義 | Confluence | Confluence | 否 |
| KPI 數值 | Google Sheets | Google Sheets | 是 |
| 改善計畫 | Trello | Trello | 是 |
| 過去分析 | PDF 報告 | 報告 Archive | 否 |
做到這裡,下一步要接哪些 Tool 往往就會自然浮現。這三個問題通常也比「要不要使用 Multi-Agent」更值得優先處理,因為如果資料來源與責任都沒有定義清楚,再複雜的 Agent 架構也只是在不確定的資料上做更多決策。
知道資料在哪裡,只解決了一半問題。真正開始跨來源查詢之後,系統還需要知道:
先去哪裡找?找不到之後怎麼辦?
這可以整理成一套 Workflow Policy(工作流規則)。
假設使用者只說:
「CDP 改版進度?」
但 Trello 裡根本沒有叫做「CDP 改版」的卡片,正式專案名稱其實是:
Customer Data Platform Dashboard Revamp
如果 Coordinator 直接對 Trello 搜尋「CDP 改版」,可能什麼都找不到。比較可靠的流程可以是:
使用者:
「CDP 改版進度?」
        ↓
先查企業知識
        ↓
CDP =
Customer Data Platform
        ↓
找到正式專案名稱
Customer Data Platform Dashboard Revamp
        ↓
查詢 Trello / Jira
        ↓
取得最新專案狀態
如果連企業知識中都找不到「CDP」代表什麼,這時更適合向使用者追問,而不是自行猜測。
因此可以用一個簡單比喻理解兩者差異:
Knowledge Map 告訴 AI「公司有哪些圖書館」;Workflow Policy 則告訴 AI「這類問題應該先去哪一間,找不到之後再去哪裡」。
到了這一步,企業 AI 才開始從「我有哪些 Tool」進一步走向「我應該按照什麼順序使用這些 Tool」。
跨來源整合還有一個特別需要注意的問題:LLM 很擅長把零散資訊整理成合理解釋,但「合理」不代表來源中真的有這項紀錄。
例如 Trello 顯示:
Task:
Launch dashboard

Status:
Delayed

Due Date:
2026-08-20
但卡片中完全沒有寫延遲原因。
這時回答應該是:
「目前專案紀錄顯示任務已延遲,但現有資料沒有說明延遲原因。」
而不是:
「任務可能因為跨部門溝通或資源不足而延遲。」
後者不是完全沒有可能,但那是推測,不是資料來源中的事實。
如果推測對使用者有幫助,也應該清楚標記,例如:
「目前紀錄沒有說明原因。如果要進一步調查,可以檢查負責人的更新紀錄、相關阻塞任務或會議內容。」
企業 AI 很重要的一項能力,就是把「已知事實」、「合理推論」與「目前未知」分開呈現,而不是用流暢的文字把三者混在一起。
今天的重點:
企業知識不是一個資料庫,而是一張分散在不同系統中的地圖。AI 架構真正要解決的問題,不是把所有資料搬到同一個地方,而是知道哪一種資訊應該去哪裡取得、哪一個來源才是 Source of Truth,以及來源衝突或找不到答案時應該怎麼處理。
下一篇,我們會第一次把這些來源放進同一個問題中,看看一個跨來源商業問題應該怎麼拆解,以及系統如何把不同 Tool 的結果重新組合起來。
我們下集見囉!


 iThome鐵人賽
 看影片追技術