

昨天我們碰到一個很實際的問題:Agent 的能力越多,執行路徑就越難看清楚。當 Tool Selection、Memory、Verification、Retry、Clarification 與 Human Approval 全部塞進同一個 Agent Loop,模型雖然擁有很高的自主性,但開發者也會越來越難回答:「現在執行到哪一步?」「為什麼走這條路?」「失敗後會回去哪裡?」
這時候 LangGraph 才真正開始有價值。它的目的不是讓大型語言模型變得更聰明,而是把原本散落在 Agent Loop 裡的執行邏輯,重新拆成可以觀察與控制的工作流程。
如果把 Agent Loop 想成一位可以自己決定下一步的同事,LangGraph 比較像把他的工作流程畫成一張真正可以執行的流程圖:目前手上有哪些資料、現在應該執行哪一個工作,以及完成之後允許走向哪些下一步,都可以明確表示出來。
LangGraph 最核心的概念其實可以先從三個名詞開始:
State
現在知道什麼?

Node
現在要做什麼?

Edge
接下來去哪裡?
理解這三個概念之後,後面的 Agent Workflow 就會容易很多。
先從 State(狀態) 開始。可以把 State 想成一支在工作流程裡不斷往下傳遞的「接力棒」。每一個 Node 都可以讀取目前需要的資訊,完成自己的工作後,再把新結果寫回 State,交給下一個 Node 使用。
以前在單一 Agent Loop 裡,我們可能把所有資訊都塞進 Prompt:使用者問了什麼、前面查過哪些 Tool、Google Sheets 回傳什麼、RAG 找到哪些文件、目前 Retry 幾次、Verification 是否成功。到了 LangGraph,這些資訊可以被明確整理成 State。例如:
State
├─ current_question
├─ conversation_id
├─ query_conditions
├─ selected_tool
├─ sheets_result
├─ document_result
├─ sources
├─ verification_status
├─ retry_count
├─ missing_information
└─ final_answer
假設使用者問「今年哪一類需求最多?它的正式定義是什麼?」,一開始的 State 可能只有:
current_question:
今年哪一類需求最多?它的正式定義是什麼?

sheets_result:
null

document_result:
null

verification_status:
pending
當 Google Sheets Tool 執行完成後,sheets_result 會更新成 Top Category = Delivery Issue、Count = 328。接著 Document Node 就能從 State 取得 Delivery Issue,再查詢正式定義,把結果寫回去:
document_result:
Delivery Issue 是指配送延遲、缺件或配送狀態異常。

source:
Customer Service Taxonomy.pdf
Page 8
因此每個 Node 不需要重新閱讀一大段對話,再自己猜「上一個步驟發生了什麼」。它可以直接查看 State 中真正需要的欄位。這也是 State 很重要的一個價值:
把 Workflow 已經知道的事情,從模糊的 Prompt Context 變成明確的資料。
前面 Day 21 才介紹過 Memory,所以這裡很容易產生另一個疑問:既然兩者都保存資訊,那 State 和 Memory 有什麼不同?可以先用一個簡單方式理解:Memory 比較關心「哪些過去資訊值得保留下來」;State 則比較關心「目前這一次 Workflow 執行到這裡,手上有哪些資訊」。
例如 Memory 裡可能有 Previous Top Market: Hong Kong 和 Previous Query Time: 2026-09-04 15:00。當新的 Workflow 開始時,Coordinator 可以判斷這份 Memory 是否仍然適用,再把真正需要的內容載入目前 State。因此兩者可能會互相連接:
Memory(過去保存的資訊)→ 挑選目前仍需要的 Context
→ State(這一次 Workflow 正在使用的資訊)
State 不一定需要永久保存所有內容,但如果 Workflow 支援 Human-in-the-loop、Pause / Resume,也可以透過持久化把目前 State 保存下來,稍後繼續執行。
有了 State 之後,第二個概念是 Node(節點)。Node 可以理解成 Workflow 裡的一個工作單元。每一個 Node 最好負責一件相對清楚的事情,讀取 State 中需要的資料,完成工作後再更新 State。例如 Data Machi 可以先拆成五個 Node,每一個的責任都不同:
| Node | 責任 | Input | Output |
|---|---|---|---|
route_request |
理解問題需要哪些資料來源 | current_question |
selected_route |
query_sheets |
執行結構化資料查詢 | query_conditions |
sheets_result |
search_documents |
文件檢索 | document_query |
document_result、sources |
verify_results |
不重新查資料,只檢查目前的證據是否足夠 | sheets_result、document_result |
verification_status、missing_information |
generate_answer |
把已確認的結果整理成使用者看到的自然語言 | 已確認的結果 | final_answer |
這樣的拆法最大的好處,就是責任變得明確,也比較容易測試。 假設最終答案中的數字錯了,我們可以先檢查 query_sheets;如果 Sheets Result 本身正確,問題就不是資料查詢。如果資料正確,但 Verification 判定錯誤,可以再檢查 verify_results。如果所有 State 都正確,只有最後文字寫錯,那問題才可能位於 generate_answer。相較於把所有事情放進一個大型 Agent Prompt,這種方式會容易除錯很多。
這裡還有一個非常重要的觀念:Node 不代表每一步都要呼叫大型語言模型。
例如 route_request 可能需要語意理解,因此可以使用 LLM。但 query_sheets 真正執行的是資料查詢程式;calculate_growth_rate 可以只是 Python 或 SQL;verification_check 裡有些規則甚至可以直接使用 deterministic logic;retry_counter 只需要程式加一。因此一張 Graph 可能同時包含 LLM Node、Tool Node、Rule Node 和 Human Approval Node。例如:
使用者問題 → LLM Node(理解問題)→ Tool Node(查詢 Google Sheets)
→ Rule Node(檢查資料是否有效)→ LLM Node(整理回答)
這再次延續 Day 23 的原則:
需要語意判斷的地方交給模型;不能出錯的流程與計算交給程式。
LangGraph 做的事情,是讓這些不同類型的 Node 可以被放進同一條 Workflow。
第三個核心概念是 Edge(連線)。如果 Node 是流程圖裡的方框,Edge 就是方框之間的箭頭。最簡單的 Edge 是固定的,例如 query_sheets 完成之後,下一個步驟一定是 verify_results。把幾條固定的 Edge 接起來,就是一條沒有分支的流程:
START → route_request → query_sheets
→ verify_results → generate_answer → END
這種流程基本上就是一般 Workflow。真正開始有意思的地方,是 Conditional Edge(條件連線)。
假設 verify_results 完成後,State 中的 verification_status 可能是 passed,也可能是 failed。這時下一步就不能永遠固定,可以設定:
verification_status = passed
→ generate_answer

verification_status = failed
→ retry_or_clarify
整體變成:
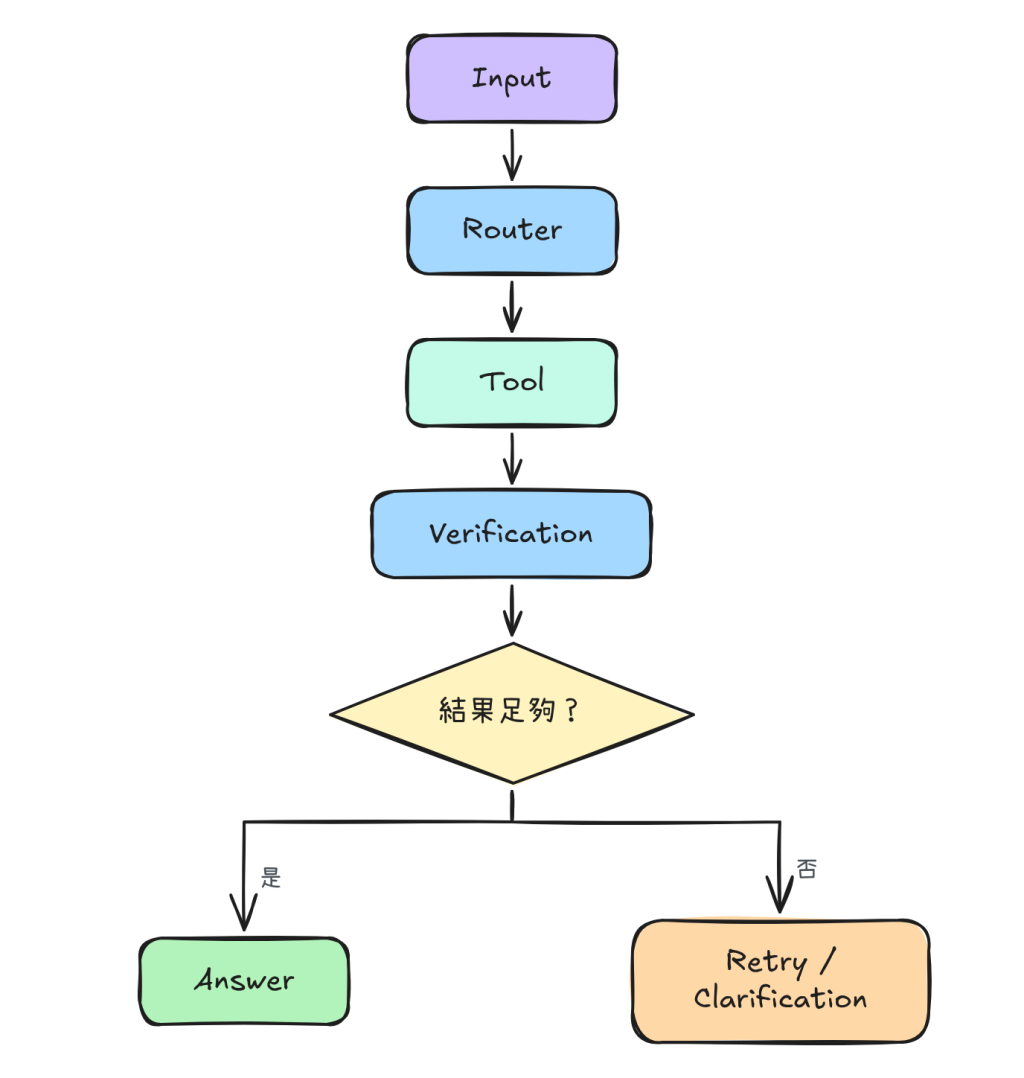
這就是 Conditional Edge。它很重要的地方是:哪些路可以走,是 Workflow 事先定義好的;真正執行哪一條路,則根據目前 State 決定。
這和完全自由的 Agent Loop 有一個重要差異。Agent Loop 比較像由模型自己決定「下一步想做什麼?」;Graph 則比較像先規定「目前允許三條路:A / B / C」,再根據 State 判斷現在應該走哪一條。因此 Agent 還是可以有自主性,但自主性被限制在 Workflow 允許的範圍裡。
昨天我們提過一個企業流程:取得數據 → 驗證 → 產生 Email → 人工確認 → 寄送。如果使用 Graph 表示,可以變成:
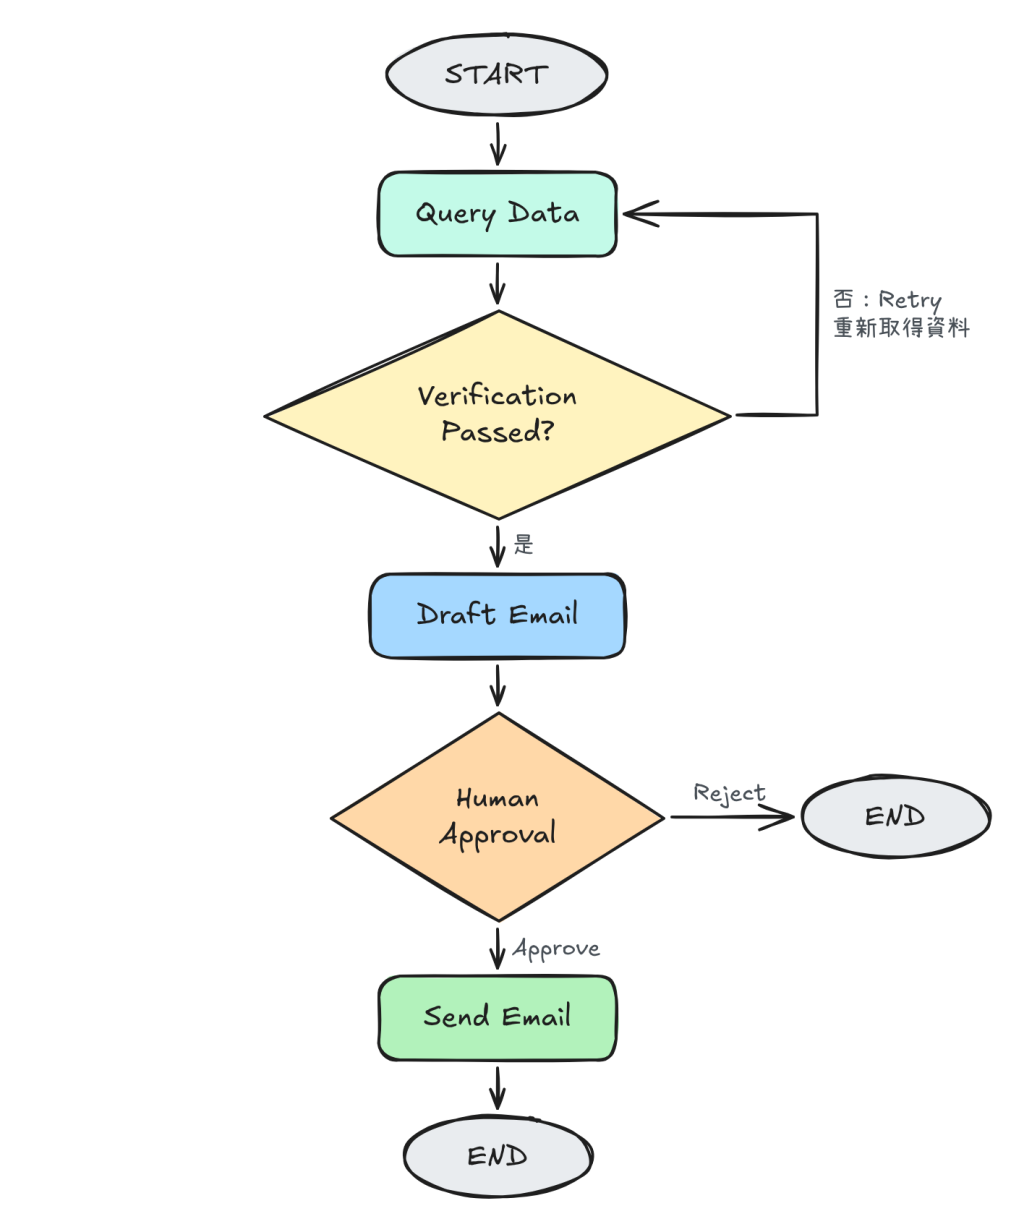
這張 Graph 已經清楚表達幾個不能跳過的規則:
Verification Failed
→ 不能 Draft Email

沒有 Approval
→ 不能 Send Email
模型不需要「記得」這兩條規則,因為 Graph 本身就沒有提供其他路可以走。這正是 Workflow Control 和 Prompt Instruction 最大的差異。
現在可以把三個概念合在一起看。假設流程目前位於 Verification Node,State 是:
verification_status = failed
retry_count = 0
Conditional Edge 讀取 State,發現 verification_status == failed 而且 retry_count < 2,因此下一步走 Retry Node。Retry 完成後 retry_count = 1,再回到 Tool Node。
如果重試兩次之後仍然失敗,State 變成 verification_status = failed、retry_count = 2,Conditional Edge 就可以改走 Clarification / Partial Answer。
完整邏輯是:State 告訴系統目前發生了什麼,Node 執行一項明確工作,Edge 根據 State 決定接下來去哪裡。這就是 LangGraph 最核心的工作方式。
看到 Graph,很容易以為 LangGraph 只是把 Agent Workflow 視覺化。但圖其實不是最重要的部分。真正的價值是:Workflow 的控制邏輯本身變成可以被程式表示與執行的結構。
因此 Graph 把「最好這樣做」慢慢轉成:
系統只能按照被允許的流程執行。
前面 Day 20 已經介紹過 Parallel Execution。例如使用者同時問「今年總工單多少?公司的需求分類怎麼定義?」,兩件事情彼此沒有依賴,可以同時查:
              ┌→ Query Sheets ────┐
START → Split │                    │
              └→ Search Document ──┤
                                   ↓
                              Merge Results
                                   ↓
                              Verification
                                   ↓
                                Answer
Graph 可以清楚表達 Fan-out(平行執行)和 Fan-in(合併結果)。但判斷原則還是和 Day 20 一樣:只要後一步依賴前一步的結果,就不能為了速度硬做 Parallel。例如「先找 Top Category,再查 Top Category 定義」,仍然必須保留 Sequential Execution。
Day 23 另一個重要需求是 Human Approval。在 Graph 裡,可以把它理解成一個明確節點:
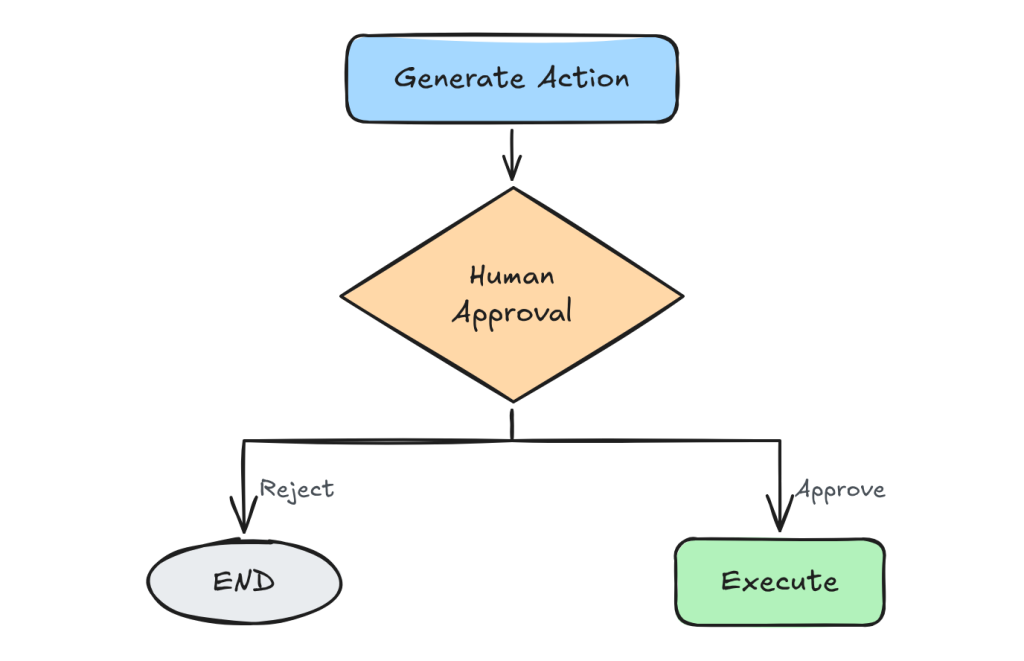
流程走到 Human Approval 時可以暫停,把目前 State 保存下來。在 LangGraph 裡,這件事要搭配 Checkpointer(負責保存 State 的元件)才做得到。例如:
current_node: human_approval
pending_action: send_email
email_draft: ...
verification_status: passed
等使用者確認後,再從保存的 State 繼續執行。這就是 Graph 和前面 Memory、State Persistence 開始真正串起來的地方。
這是 LangGraph 特別容易讓人混淆的一件事。假設一張 Workflow 有 Router Node、Sheets Node、Document Node、Verification Node、Summary Node、Approval Node 和 Action Node,總共有七個 Node。這完全不代表有七個 Agent。
因為 Node 只是工作流程的一個執行單元,其中可能包括 Tool Node、Rule Node、LLM Node、Human Node 和 Agent Node。只有某一個 Node 自己具有比較完整的 Goal、Context、Tools 和 Decision Loop,而且能反覆 Reason → Act → Observe,才比較接近一個獨立 Agent。
例如 Sheets Tool Node 只是執行查詢,不是 Agent;Verification Rule Node 只是檢查條件,也不是 Agent;甚至 LLM Summary Node 雖然使用大型語言模型,但只是執行一次摘要,也不代表它是一個 Agent。因此:
多 Node ≠ Multi-Agent。
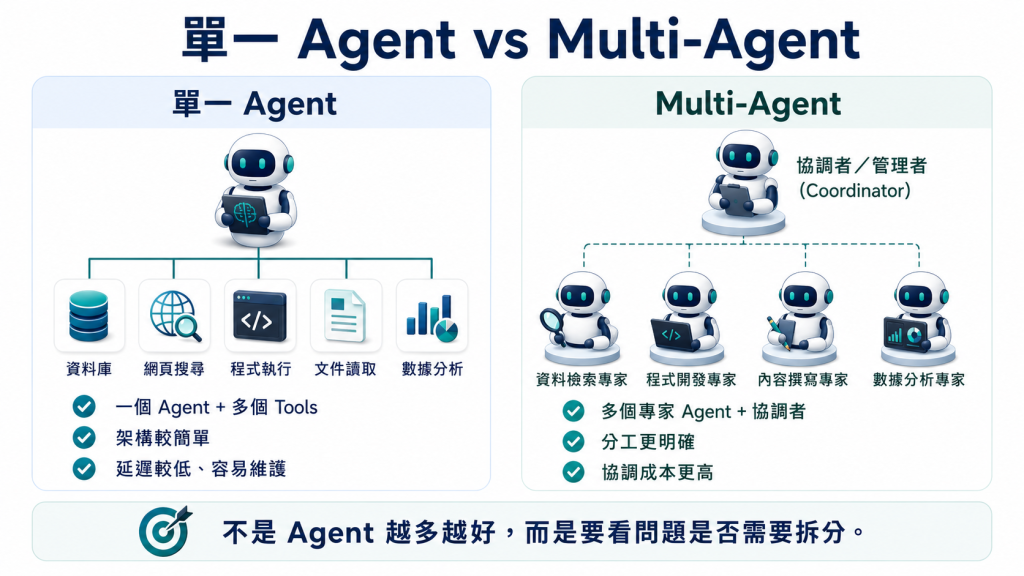
真正值得拆成多個 Agent,通常不是因為 Tool 數量很多,而是不同工作真的需要不同的「角色邊界」。例如下面這兩個 Agent:
| Data Analysis Agent | Compliance Review Agent | |
|---|---|---|
| 目標 | 找出數據異常與可能原因 | 檢查分析結果是否符合規範 |
| Tools | SQL、Python、Analytics Database | Policy RAG、Compliance Database |
| Permissions | — | 不能修改原始資料 |
這兩者有不同 Goal、Context、Tool Set 與 Permission,因此拆開才開始有價值。
另一種適合 Multi-Agent 的情況,是工作本身存在正式角色交接:
Research Agent
      ↓
Draft Agent
      ↓
Review Agent
      ↓
通過?
  /       \
No        Yes
↓          ↓
退回修改  Final Output
這已經不是單純「Tool 很多」,而是業務流程本身存在不同角色。
相反地,如果 Data Machi 目前只有 Google Sheets Tool、PDF Tool、Confluence Tool、Trello Tool、Database Tool 和 Web Tool,並不代表應該做成 Sheets Agent、PDF Agent、Confluence Agent、Trello Agent、Database Agent 和 Web Agent。這樣反而會多出:
如果一個 Coordinator 已經能穩定判斷要使用哪個 Tool,單一 Coordinator 加上多 Tool 往往會更簡單。
一個實用原則:先用「單一 Coordinator + 多個 Tools」解決問題;只有當 Context 必須隔離、權限差異明顯、Tool Selection 已經難以管理,或角色交接本身就是業務流程時,再考慮 Multi-Agent。
反過來也一樣。你完全可以只有 1 個 Coordinator、5 個 Tool、10 個 Node 和 0 個額外 Agent,但仍然非常適合 LangGraph,因為真正需要解決的是 State、Branch、Retry、Verification、Human Approval 和 Failure Path,而不是 Agent 數量。
Data Machi 目前的版本更精簡:一個 Coordinator 綁定所有 Tool,Graph 裡只有 agent 和 action 兩個 Node,同樣沒有額外的 Agent。明天會看到實際的程式。
這也是為什麼 LangGraph 更適合理解成建立 stateful workflow 的方式,而不是「建立 Multi-Agent 的框架。」
講到這裡,也要避免另一個極端:既然 Graph 很清楚,是不是所有 AI Application 都應該使用 LangGraph?答案仍然是否定的。
如果流程只是「Input → SQL → Calculate → Output」,一般程式流程就足夠,而且通常更簡單。如果只是「User → Agent → 2 個 Tools → Answer」,而且沒有複雜分支、Retry、Memory 或 Human Approval,簡單 Agent Loop 可能也完全足夠。
LangGraph 真正開始有價值的訊號通常是:
這時 Graph 才會比單純線性程式或 Agent Loop 更自然。
例如一個很簡單的 RAG,只需要「User Question → Retrieve → Generate Answer」三步。如果硬拆成:
Question Parser
      ↓
Intent Detector
      ↓
Query Rewriter
      ↓
Retriever Selector
      ↓
Retriever
      ↓
Chunk Ranker
      ↓
Verifier
      ↓
Answer Planner
      ↓
Generator
      ↓
Answer Reviewer
技術上當然可以,但不代表這樣比較好。Node 越多,也代表更多 State、更多 Edge、更多測試、更多錯誤處理和更高的維護成本。如果這些步驟沒有真正解決已經存在的問題,就只是把簡單系統複雜化。因此仍然要延續整個系列一直強調的原則:
架構不是越進階越好,而是剛好能承受問題的複雜度就好。
回頭比較 Day 23,可以看到 Agent Loop 比較像「Agent 看目前 Context,自己決定下一步,執行之後再決定」。LangGraph 則變成四件事各司其職:State 記錄目前知道什麼,Node 執行明確工作,Edge 規定下一步允許去哪裡,Conditional Edge 根據 State 選擇路徑。
模型仍然可以參與決策,但它不再需要負責所有控制邏輯。例如:
這就是從「Prompt 裡的規則」走向「可以執行的 Workflow Specification」。
如果想把 LangGraph 套到自己的企業 Agent,第一步其實不需要先打開文件找 API。可以先拿 Day 20 的 Agent 決策邊界,問自己四個問題:
例如:
State
- question
- selected_tool
- tool_result
- verification
- retry_count

Nodes
- coordinator
- tool
- verification
- answer

Edges
START → coordinator
tool → verification
answer → END

Conditional Edges
coordinator → tool A / tool B
verification → answer / retry
做到這裡,就算還沒有寫任何 LangGraph 程式碼,也已經完成一份初步的 Workflow Blueprint。而且真正重要的是:這張 Blueprint 應該先讓人看得懂,再讓程式執行。
今天的重點:
LangGraph 的核心價值不是讓 Agent 變多,也不是讓 LLM 更聰明,而是用 State 明確保存目前資訊、用 Node 拆分工作責任,再用 Edge 與 Conditional Edge 定義流程可以怎麼走。當 Agent 開始出現 Retry、Verification、Human Approval、Parallel Branch 與不同 Failure Path 時,Graph 能讓原本藏在 Agent Loop 裡的控制邏輯變得看得見、控得住,也測得到。
下一篇,我們會把前面做好的 Data Machi Coordinator 真正放進 LangGraph,建立第一條 Coordinator → Tool → Verification → Answer 的可控 Workflow,並把失敗時該 Retry、Clarify 還是停止也一起畫進流程。
我們下集見囉!


 iThome鐵人賽
 看影片追技術