
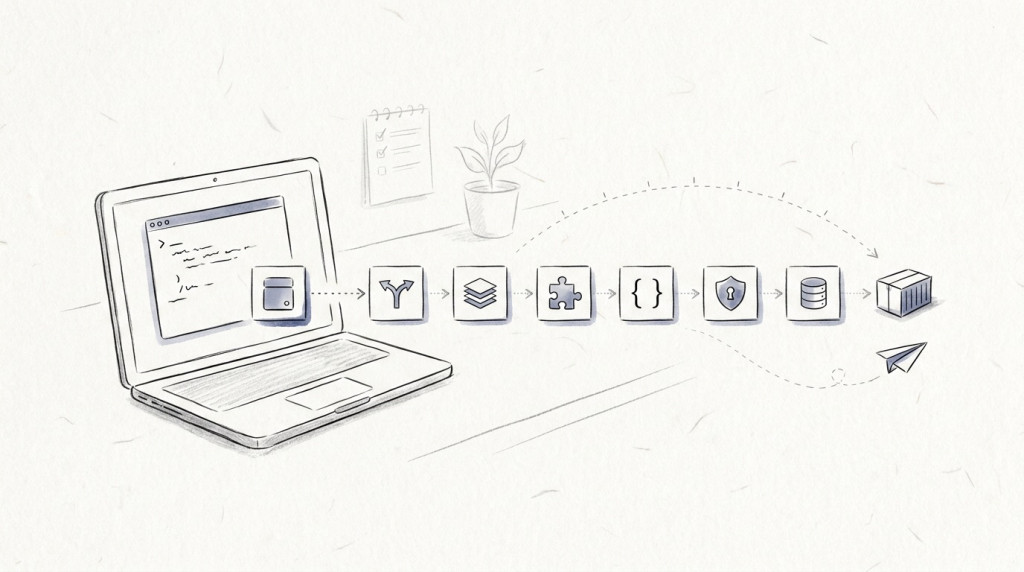
前面都在本機跑 ./gradlew run,這篇要把它打包成別人可以部署的東西,fat jar 一個檔案、Docker image 一包,然後在容器裡把它弄壞,看它怎麼反應
弄壞的方式是把資料庫那個容器 docker stop 掉,然後看 app 這一側還剩下什麼、健康檢查該回什麼、關機又要花多久
buildFatJar 產出單一一個檔案,直接 java -jar 跑得起來,啟動時間跟 ./gradlew run 是同一個量級JWT_SECRET 連 port 都不會開docker exec ... id 是 uid=0(root),換 base image 加一行設定才變成 uid=1000
/、/health/live、/health/ready 3 條路由在資料庫死掉的時候給 3 種答案,而 liveness 回 200 是刻意的connectionTimeout 決定的build.gradle.kts 的 plugins { } 多一行
 plugins {
     kotlin("jvm") version "2.2.20"
     kotlin("plugin.serialization") version "2.2.20"
+    alias(ktorLibs.plugins.ktor)
     application
 }
application plugin 本來就有 jar、installDist、distTar 3 個 task,加上 Ktor plugin 帶來的 buildFatJar,同一輪一起跑,4 個產出各是一種形狀,day 29 曾經因為 runtime routing 不需要 OpenAPI compiler plugin 而把 Ktor plugin 拿掉,這次為了 fat JAR 與容器工作才重新加回來
jar 給的 thin jar 只有自己的 class,跑不起來,因為相依一個都不在裡面,完整的東西是 installDist 底下那個 lib 目錄,要搬到別台機器上得整個目錄一起搬,distTar 則把它們包成一個檔
buildFatJar 給的是另一種形狀,把自己的 class 跟所有相依壓進單一一個檔案
打包出來的檔案是 build/libs/todo-api-all.jar,直接 java -jar 跑得起來
./gradlew buildFatJar
JWT_SECRET=local-dev-secret-32-bytes-minimum \
ALICE_PASSWORD=alice-secret BOB_PASSWORD=bob-secret \
DB_URL="jdbc:h2:mem:todo" DB_DRIVER=org.h2.Driver DB_PASSWORD= \
java -jar build/libs/todo-api-all.jar
另一個視窗打一次首頁
curl -s localhost:8080/
Hello, Ktor!
server 那一側的啟動 log
Application started in 0.654 seconds
0.654 秒,先前拿 ./gradlew run 差不多也是 0.67 秒左右,換成 fat jar 之後落在同一個量級,打包這件事本身沒有讓啟動變慢
要比較這 2 個數字,資料庫得是同一種,上面那串環境變數裡的 DB_URL="jdbc:h2:mem:todo",跟前面那 3 次一樣都是接 H2 in-memory,不是 PostgreSQL,接 PostgreSQL 會是另一組數字,這一輪沒有量,這裡只是把兩邊維持在同一個條件底下比
DB_DRIVER 跟 DB_PASSWORD 要跟著一起改,前者的預設值是 org.postgresql.Driver,只換 DB_URL 等於拿 PostgreSQL 的 driver 去接 H2 的網址,後者在 application.yaml 裡沒有預設值,少給就直接死在啟動
day 27 定的規矩是憑證不給版控預設值,這條規矩會不會在打包之後被繞過去,是一件要親自試的事,因為 fat jar 的 application.yaml 已經被封進去了,少給 JWT_SECRET 再跑一次
DB_URL="jdbc:h2:mem:todo" DB_DRIVER=org.h2.Driver DB_PASSWORD= \
ALICE_PASSWORD=alice-secret BOB_PASSWORD=bob-secret \
java -jar build/libs/todo-api-all.jar
Exception in thread "main" io.ktor.server.config.ApplicationConfigurationException: Required environment variable "JWT_SECRET" not found and no default value is present
啟動就會有問題,連 port 都沒開,curl 回的是連不上,這是要的行為,一台設定不完整的機器不應該進到負載平衡器後面,不過,設定錯了就有問題,比設定錯了還撐著回 200 好處理太多
Ktor plugin 底下接的是 jib,不用寫 Dockerfile,build.gradle.kts 裡先寫一段 jib 自己的設定區塊,第 1 版只指定 base image 跟 tag
+jib {
+    from { image = "eclipse-temurin:21-jre-jammy" }
+    to { image = "todo-api"; tags = setOf("jammy") }
+}
一個 task 就把 image 建進本機的 Docker daemon
./gradlew jibDockerBuild
docker images todo-api:jammy --format '{{.Repository}}:{{.Tag}} {{.Size}}'
todo-api:jammy 324MB
jammy 這個 tag 是為了跟等一下 alpine 那版並排比較才打的,改完之後建出來的 tag 是 slim,base image eclipse-temurin:21-jre-jammy 自己是 286MB,324 減 286 是 38MB,那 38MB 就是我們加上去的東西,jib 把它分成 4 層,docker history 的 COMMENT 欄直接寫出哪層是哪層
docker history todo-api:jammy --format '{{.Size}}\t{{.Comment}}' | head -4
4.3kB	jvm arg files
770kB	classes
1.94kB	resources
37.4MB	dependencies
dependencies 那層 37.4MB,classes、resources、jvm arg files 3 層加起來不到 1MB,分這樣是有用的,改自己的程式碼只會動到 770kB 那層,37.4MB 的相依在 build.gradle.kts 沒動的時候不用重新推上去
第 1 次建整個花
bash -c "TIMEFORMAT='real %2R'; time ./gradlew jibDockerBuild"
real 7.55
這是 Gradle daemon 還沒起來、base image 也還沒進本機 cache 的那一次,兩者都熱了之後同一個指令是 4 秒上下
要起容器就得有資料庫,day 23 那份 compose.yaml 裡已經有一個 PostgreSQL 了,把 app 加成同一份檔案裡的第 2 個 service,網路跟啟動順序都不用自己接
+  api:
+    image: todo-api:${TAG:-slim}
+    depends_on:
+      db:
+        condition: service_healthy
+    ports:
+      - '8080:8080'
+    environment:
+      DB_URL: jdbc:postgresql://db:5432/todo
+      DB_PASSWORD: todo
+      JWT_SECRET:
+      ALICE_PASSWORD:
+      BOB_PASSWORD:
下面那 3 個環境變數只寫名字不給值,這是 compose 的傳遞寫法,值從外面的 shell 帶進去,compose.yaml 裡就不會躺著憑證,外面沒給就是容器裡沒有這個變數,接的正是 day 27 那條規矩
image 那行留一個 TAG,等一下換 alpine 那版才不用改檔案。先起 jammy 這版,查一下容器裡的身分
export JWT_SECRET=local-dev-secret-32-bytes-minimum
export ALICE_PASSWORD=alice-secret BOB_PASSWORD=bob-secret

TAG=jammy docker compose up -d api
docker compose exec api id
uid=0(root) gid=0(root) groups=0(root)
root, 這不是 jib 的錯,是那個 base image 的預設,一個只會回 JSON 的 todo API 沒有任何理由用 root 跑,容器逃逸這種事先不談,光是掛進來的 volume 被寫壞就夠煩了
改法是在同一個 jib { } 裡換掉 base image,再補上執行身分
 jib {
-    from { image = "eclipse-temurin:21-jre-jammy" }
-    to { image = "todo-api"; tags = setOf("jammy") }
+    from { image = "eclipse-temurin:21-jre-alpine" }
+    to { image = "todo-api"; tags = setOf("slim") }
+    container { user = "1000:1000" }
 }
這裡用的是 jib { } 不是 Ktor plugin 的 ktor { docker { } },我一開始在後者設定 customBaseImage,再直接跑 Jib 原生的 jibDockerBuild,建出來的 base image 還是 eclipse-temurin:21-jre
原因在 task 的相依關係,Ktor plugin 會在 setupJibLocal 才把 customBaseImage 寫進 Jib,而 buildImage、runDocker、publishImageToLocalRegistry 這幾個 Ktor task 會先跑它,原生的 jibDockerBuild 只有 mustRunAfter 的順序限制,單獨執行不會把 setupJibLocal 一起帶進來,我既然選擇直接跑 Jib 的 task,設定也改成 Jib 自己的 jib { },不要混用 2 條入口
改完之後
./gradlew jibDockerBuild
docker images todo-api:slim --format '{{.Repository}}:{{.Tag}} {{.Size}}'
todo-api:slim 246MB
324MB 變 246MB,少 78MB,這 78MB 全部來自 base image,把 2 個 image 各自拆開看就清楚了
前 4 層是 jib 加上去的,其餘都是 base image,照這個界線把 docker history 的 SIZE 欄加總
docker history todo-api:slim --format '{{.Size}}\t{{.Comment}}' | awk -F'\t' '
function b(s){ if(s~/MB$/) return substr(s,1,length(s)-2)*1e6;
 if(s~/kB$/) return substr(s,1,length(s)-2)*1e3;
 return s+0 }
NR<=4{jib+=b($1); next}{base+=b($1)}
END{printf "jib 四層 %.1f MB\nalpine base %.1f MB\n合計 %.1f MB\n", jib/1e6, base/1e6, (jib+base)/1e6}'
jib 四層 38.2 MB
alpine base 207.3 MB
合計 245.5 MB
jib 那 4 層兩邊一模一樣,都是 38.2MB,差的是 alpine base 的 207.3MB 對 jammy base 的 286MB,也就是說這一步省下來的不是我們的程式碼,是 base image 裡那些一個 Java 服務用不到的東西,不帶 TAG 就是 slim,換這版再起一次,使用者也對了
docker compose up -d --force-recreate api
docker compose exec api id
uid=1000 gid=1000 groups=1000
容器裡的啟動時間
docker compose logs --no-log-prefix api | grep 'started in'
Application started in 2.674 seconds
本機是 0.654 秒,容器裡是 2.674 秒,這中間差在哪,這一輪沒有量,同時改變的變數不只一個,容器的 CPU 配額、alpine 用的是 musl 而不是 glibc、連的資料庫也換了,沒有分開量就無從歸因,所以這裡只留數字不下結論
/ 不是健康檢查健康檢查寫在新檔案 src/main/kotlin/com/cashwu/todo/Health.kt,2 條路由
@OptIn(ExperimentalKtorApi::class)
fun Route.healthRoutes() {
    get(LIVE_PATH) {
        call.respond(HealthResponse("up"))
    }.hide()

    get(READY_PATH) {
        val dataSource = call.application.dependencies.resolve<DataSource>()
        if (dataSource.reachable()) {
            call.respond(HealthResponse("up", "up"))
        } else {
            call.respond(HttpStatusCode.ServiceUnavailable, HealthResponse("down", "down"))
        }
    }.hide()
}
LIVE_PATH 是 /health/live,READY_PATH 是 /health/ready,真正去問資料庫的是同一個檔案裡的這個擴充函式
import java.sql.SQLException

private suspend fun DataSource.reachable(): Boolean = withContext(Dispatchers.IO) {
    try {
        connection.use { it.isValid(1) }
    } catch (_: SQLException) {
        false
    }
}
這裡只接 SQLException,runCatching 會把所有 Throwable 都包起來,但 readiness 要轉成 false 的只有連線失敗,不該順手把取消訊號或 JVM 的 Error 也當成資料庫離線
2 條都接 hide(),理由跟 day 30 的 WebSocket、day 29 的 Swagger UI 一樣,它們是給機器看的不是給 API 使用者看的,掛在 paths 底下只會讓讀規格的人多困惑一次,不過 hide() 只是不寫進 OpenAPI,不是存取控制,正式環境還是要由 ingress 或網路層限制誰能打健康檢查,否則一條會等資料庫 5 秒的公開路由也能被拿來消耗連線池
src/main/kotlin/com/cashwu/todo/Application.kt 的 routing { } 只加一行
      get("/") {
          call.respondText("Hello, Ktor!")
      }
+     healthRoutes()
      docsRoutes(config.openapi)
容器還連著上面那個 PostgreSQL,資料庫活著的時候
printf '/             -> %s\n' "$(curl -s -o /dev/null -w '%{http_code}' localhost:8080/)"
printf '/health/live  -> %s %s\n' "$(curl -s localhost:8080/health/live)" "$(curl -s -o /dev/null -w '%{http_code}' localhost:8080/health/live)"
printf '/health/ready -> %s %s\n' "$(curl -s localhost:8080/health/ready)" "$(curl -s -o /dev/null -w '%{http_code}' localhost:8080/health/ready)"
/             -> 200
/health/live  -> {"status":"up","database":null} 200
/health/ready -> {"status":"up","database":"up"} 200
把資料庫停掉,同樣 3 條路由再打一次,給的是 3 種答案
docker compose stop db
/             -> 200
/health/live  -> {"status":"up","database":null} 200
/health/ready -> {"status":"down","database":"down"} 503
/ 還是 200,day 02 那行 respondText("Hello, Ktor!") 從來沒有碰過資料庫,它只證明 JVM 還活著、Netty 還在收連線,所以負載平衡器如果盯著 / 當健康檢查,它會一直把流量送進一台連不到資料庫的機器,而且面板上一片正常,/health/live 也是 200,只有 /health/ready 是 503
/health/live 回 200 是刻意的,不是漏寫,liveness 探測要回答的問題是「要不要重新啟動這個 process」,而資料庫掛掉重新啟動 app 一點用都沒有,重新啟動完還是連不上,只是多送一輪冷啟動,readiness 探測回答的是另一個問題,「現在該不該把流量送進來」,這個問題的答案在資料庫死掉的時候就是不該,2 個問題混成同一條路由,你會拿到一個資料庫一抖整組 pod 就開始輪流重新啟動的系統
/health/live body 裡那個 "database":null 不是刻意寫的,是 day 13 那個 encodeDefaults = true 的結果,HealthResponse 的 database 有預設值 null,欄位是 null 也會被序列化出來
上面那個 503 不是馬上回的
docker compose logs --no-log-prefix api | grep 'health/ready' | tail -1
01:48:32.740 INFO [dw3z6sziqi2p] Application -- 503 GET /health/ready 5028ms
5028 毫秒,出處是 src/main/resources/application.yaml 那行
connectionTimeout: "$DB_CONNECTION_TIMEOUT:5000"
isValid(1) 那個 1 秒是拿到連線之後的查詢逾時,而連線本身要先從池子裡拿,池子拿不到就等滿 5 秒,Kubernetes probe 的 timeoutSeconds 預設只有 1 秒,照現在這份設定,探測會在 app 回 503 之前先 timeout
正式環境不該只把 probe timeout 拉到 5 秒以上,那會讓失敗判定一起變慢,比較合理的順序是先替 readiness 的資料庫檢查設一個更短的上限,再把 probe timeout 設得稍微比它長,這一輪沒有把健康檢查跟一般請求的連線等待拆開,文末會留一筆
Kubernetes 還沒上,compose.yaml 裡的 api 就先接一個 healthcheck,探測的正是剛才那條 /health/ready,2 個 image 裡都有 wget,不用另外裝東西
       ALICE_PASSWORD:
       BOB_PASSWORD:
+    healthcheck:
+      test: ['CMD', 'wget', '-qO-', 'http://localhost:8080/health/ready']
+      interval: 5s
+      timeout: 6s
+      retries: 3
+      start_period: 15s
timeout 這裡是 6 秒,比 db 那個 service 的 3 秒長,理由就是上面那 5028 毫秒,照抄 db 的設定會在 app 回 503 之前先 timeout,拿到的是「探測逾時」而不是「資料庫連不上」,兩者在面板上長得不一樣。start_period 15 秒是給容器裡那 2.674 秒的啟動再加上一輪重試的餘裕,這段時間內失敗不算進 retries
資料庫活著的時候
docker compose ps --format '{{.Service}} {{.Status}}'
api Up 22 seconds (healthy)
db Up 27 seconds (healthy)
docker compose stop db 之後過 3 輪探測
api Up About a minute (unhealthy)
docker compose ps 裡 db 已經不在了,而 api 還活著,只是被標成 unhealthy,這正是 liveness 跟 readiness 分開的那個差別在 compose 這一側的樣子,容器沒有被重新啟動,它只是不再被當成可以收流量的那一個
接上去之後 app 的 log 會多一條固定節奏的線
docker compose logs --no-log-prefix api | grep 'health/ready' | head -5
05:36:23.039 INFO  [0mo88-192evf] Application -- 200 GET /health/ready 78ms
05:36:28.096 INFO  [cxutp/w6q+hu] Application -- 200 GET /health/ready 8ms
05:36:33.157 INFO  [bb29mvsqr1/j] Application -- 200 GET /health/ready 5ms
05:36:38.220 INFO  [dgzklb-2vesx] Application -- 200 GET /health/ready 10ms
05:36:43.283 INFO  [6ijrek2x8mwt] Application -- 200 GET /health/ready 7ms
時間戳每 5 秒一個,就是 interval 那行,第 1 次 78 毫秒、之後掉到個位數,差別在 JIT 跟連線池熱起來沒有
這條線有一個代價要記在帳上,每 5 秒一次的探測,每一次都會從池子裡拿一個連線。資料庫正常時只佔幾毫秒,看不出來,資料庫掛掉的時候每一次探測都會佔滿 5 秒才放掉,這就是前面講 hide() 時那句「一條會等資料庫 5 秒的公開路由也能被拿來消耗連線池」的實際樣子,只是現在打它的是自己的 healthcheck,poolSize 預設 10、探測 5 秒一次,撞不到上限,但 interval 調短或 poolSize 調小的時候,這 2 個數字要一起看
資料庫接回來,app 也重起一次,這次量 docker stop 花多久
docker compose start db
docker compose up -d --force-recreate api

S=$(date +%s.%N); docker compose stop api; E=$(date +%s.%N)
echo "STOP_SECONDS=$(echo "$E - $S" | bc | xargs printf "%.2f\n")"
STOP_SECONDS=0.21
log 的收尾
docker compose logs --no-log-prefix api | grep Shutdown
01:40:47.409 INFO  [no-call-id] c.z.h.HikariDataSource -- todo-pool - Shutdown initiated...
01:40:47.416 INFO  [no-call-id] c.z.h.HikariDataSource -- todo-pool - Shutdown completed.
那 2 行是 day 18 那個 DI 容器在 ApplicationStopping 把 AutoCloseable 關掉的結果,HikariDataSource 就是其中一個,那篇留了一句話說連線池是最典型的 AutoCloseable,16 天後在容器裡看到的就是這 2 行,從 Shutdown initiated 到 Shutdown completed 是 7 毫秒,退出碼
docker inspect ktor-api-1 --format 'exit code: {{.State.ExitCode}}'
exit code: 143
143 是 128 加 15,代表容器收到 SIGTERM,並且在 Docker 改送 SIGKILL 前退出,這個數字不能證明當時還在飛的請求都有處理完,graceful drain 要用一個尚未完成的請求另外測
資料庫先死掉再關機就不一樣了,同一組指令,中間多一步把資料庫停掉
docker compose start api
docker compose stop db

S=$(date +%s.%N); docker compose stop api; E=$(date +%s.%N)
echo "STOP_SECONDS=$(echo "$E - $S" | bc | xargs printf "%.2f\n")"
STOP_SECONDS=5.20
01:48:33.798 INFO  [no-call-id] c.z.h.HikariDataSource -- todo-pool - Shutdown initiated...
01:48:37.776 INFO  [no-call-id] c.z.h.HikariDataSource -- todo-pool - Shutdown completed.
同樣 2 行 log,中間從 7 毫秒變成將近 4 秒,慢在哪,log 本身沒有講,這裡只有頭尾 2 個時間戳,中間那段是黑的,看起來是池子在等那些已經連不到對面的連線放棄,但這是從時間差反推的,不是量出來的
docker stop 預設等 10 秒才送 SIGKILL,5.20 秒還在裡面,但這個餘裕不大,連線池設得更大或逾時設得更長,就有機會撞到那個 10 秒,撞到之後拿到的是 SIGKILL,那時候手上還沒處理完的請求會怎樣,沒有人保證
換句話說,關機時間不是一個由程式碼決定的常數,它由連線池設定跟資料庫狀態一起決定,而你會需要它的那一刻,通常就是資料庫出事的那一刻
第 1 版的 healthRoutes 收一個 DataSource 參數,在 routing { } 裡面就把它解出來傳進去,寫成 healthRoutes(dataSource),看起來比每次請求都去容器裡拿一次乾淨,整套測試跑下來,數字是把 build/test-results/test/ 底下那些 XML 的 testsuite 屬性加總來的
./gradlew test

grep -h '<testsuite ' build/test-results/test/*.xml | awk '
match($0, /tests="[0-9]+"/){t=substr($0,RSTART+7,RLENGTH-8)}
match($0, /failures="[0-9]+"/){f=substr($0,RSTART+10,RLENGTH-11)}
{c++; tests+=t; fails+=f}
END{print "classes " c " tests " tests " failures " fails}'
classes 29 tests 278 failures 1
  TestApplicationTest | a provided repository keeps the database out of the test()
失敗訊息
java.lang.RuntimeException: Driver org.h2.Driver claims to not accept jdbcUrl, jdbc:nowhere:boom
那個測試是 day 24 寫的,它故意把資料庫網址設成 jdbc:nowhere:boom,然後提供一個假的 TodoRepository,用來證明假 repository 一放進去,真的資料庫連建都不會被建出來
我那一行 healthRoutes(dataSource) 把這個保證打破了,因為它在建路由樹的當下就要求容器把 DataSource 做出來,改成在 handler 裡面才解析
val dataSource = call.application.dependencies.resolve<DataSource>()
278 個測試就全部通過了,這個改法本身也比較對,readiness 探測要問的是「現在」連不連得上,不是「啟動的時候」連不連得上,在 handler 裡解析剛好就是這個語意
這件事的形狀比它的修法有意思,一行新程式碼,寫的時候腦子裡想的是「早點拿到相依比較乾淨」,而它動到的是 10 天前某個測試賴以成立的前提,那個前提沒有寫在任何介面上,它是「路由樹建起來的過程中不要碰資料庫」這種隱形的合約,只有那個測試會抓到,要不是它,這一行會安安靜靜地進到 main,然後在某個沒有資料庫的環境裡才爆
新增一個檔案 src/test/kotlin/com/cashwu/todo/HealthTest.kt,5 個測試,全套跑的時候這個 class 花 0.232 秒
最重要的那個是把資料庫弄死,再看 3 條路由的差別
@Test
fun `a dead database makes ready fail but leaves live and root alone`() = testApplication {
    lateinit var flaky: FlakyDataSource
    configure(overrides = {
        h2Database()
        put("ktor.application.modules.size", "0")
    })
    application {
        val url = environment.config.property("todo.database.url").getString()
        dependencies.provide<DataSource> {
            FlakyDataSource(todoDataSource(DatabaseConfig(url, "org.h2.Driver", "sa", "", 3, 5_000)))
                .also { flaky = it }
        }
    }
    application { module() }
    serverConfig { developmentMode = false }
    val client = bearerClient()

    assertEquals(HttpStatusCode.OK, client.get(READY_PATH).status)
    flaky.alive = false

    val ready = client.get(READY_PATH)

    assertEquals(HttpStatusCode.ServiceUnavailable, ready.status)
    assertEquals("""{"status":"down","database":"down"}""", ready.bodyAsText())
    assertEquals(HttpStatusCode.OK, client.get(LIVE_PATH).status)
    assertEquals(HttpStatusCode.OK, client.get("/").status)
}
FlakyDataSource 放在同一個測試檔的最上面,是一個 delegate,一開始是活的所以 Flyway 跑得完,之後才翻旗標
private class FlakyDataSource(private val real: DataSource) : DataSource by real {
    @Volatile
    var alive: Boolean = true

    override fun getConnection(): java.sql.Connection =
        if (alive) real.connection else throw java.sql.SQLException("資料庫連不上")
}
最後那 3 個斷言就是前面那 3 行輸出,/health/ready 是 503、/health/live 是 200、/ 也是 200,3 種答案寫成 3 個斷言,哪天有人「順手」把 / 拿去當 readiness 探測,這個測試不會抓到他,它驗的是 app 這一側的行為,不是 Kubernetes 設定檔那一側,但至少這 3 行的意思寫在原始碼裡,不是寫在某個人的腦子裡
另外 3 個沒貼原文,ready reports the database it actually reached 斷言 body 是 {"status":"up","database":"up"},live says nothing about the database 斷言 body 是 {"status":"up","database":null},neither health route shows up in the spec 斷言 hide() 有效
剩下那個要單獨講,因為它第 1 版根本沒有在測它宣稱的東西,名字叫 both health endpoints are open without a token,內容是拿 todoApplication() 回傳的 client 去打 2 條健康檢查,斷言都是 200
問題出在那個 client,它每個請求都自動帶 bearerAuth(TEST_TOKEN),所以這個測試證明的是「帶著 token 打健康檢查會 200」,而那句話對這個 app 裡幾乎每一條路由都成立,把 healthRoutes() 整個搬進 authenticate { } 裡面,探測從此全部被擋在 401 外面,這個測試照樣通過
改成這樣
@Test
fun `both health endpoints answer without a token`() = testApplication {
    todoApplication()
    val anonymous = createClient { }

    assertEquals(HttpStatusCode.OK, anonymous.get(LIVE_PATH).status)
    assertEquals(HttpStatusCode.OK, anonymous.get(READY_PATH).status)
    assertEquals(HttpStatusCode.Unauthorized, anonymous.get("/todos").status)
}
todoApplication() 的回傳值丟掉不用,只取它建 application 的副作用,client 換成 createClient { } 這個不帶任何 header 的,3 個斷言裡最關鍵的是最後那行,/todos 回 401 是對照組,證明這個 client 真的沒有 token,不然前 2 行的 200 一樣說明不了事情,改完 5 個測試仍然全部通過,全套 278 個也全部通過
這跟前面那個 day 24 的失敗剛好是一體兩面,那次是新程式碼踩到舊測試畫下的界線,被抓到了,這次是新測試自己什麼都沒驗,而它不會失敗,所以沒有東西會來抓它
Relix 那個系列沒有做打包、Docker 或健康檢查,main() 就是 app.start(),跑在 IDE 裡
能講的只有一點,手刻框架到 app.start() 就算完成了,因為它要證明的是機制,而這一篇做的每一件事,打包、非 root、健康檢查、關機順序,都不是框架給的,是部署這件事本身要求的,換成任何語言任何框架都要面對同一份清單,Ktor 在這裡給的只有 buildFatJar 跟 jib 那層包裝,至於 /health/ready 該回什麼、關機要等多久,它一個字都沒有替你決定
這篇把同一個 todo-api 換成 fat JAR 與 Docker image 跑了一次,Ktor plugin 補上打包與容器工作的入口,Jib 把相依、class 和資源拆成不同 layer,再把執行身分從 root 改成 uid 1000
部署之後,健康檢查決定服務會不會收到流量,/health/live 只回答 process 還活著沒有,/health/ready 才碰資料庫,資料庫失聯時一條維持 200、另一條等滿連線池的 5 秒後回 503,打包這件事完成了,能不能安全部署仍然取決於外圍那些設定
這篇留下的問題有 5 個,沒有 graceful drain,SIGTERM 之後 Ktor 有沒有把手上的請求處理完才關,這一輪只量了關機總時間,證明得了容器在 SIGKILL 前退出,證明不了飛行中的請求已經排空,readiness 那 5 秒是連線池逾時決定的,沒有替探測單獨設一個更短的上限,Kubernetes probe 的 timeoutSeconds 預設只有 1 秒,會在 app 回 503 之前先 timeout,正式環境的設定也還沒完成,資料庫密碼仍靠環境變數傳進容器,沒有接 secret manager,day 32 那個 cookie.secure 也還沒打開,健康檢查以外什麼都沒有,沒有 metrics 也沒有 tracing,最後是容器裡的 2.674 秒對本機的 0.654 秒,差在哪沒有量,同時改變的變數不只一個,沒有分開量就無從歸因
上面那 5 個問題裡有一個下一篇會還,就是 graceful drain,要量「還在飛的請求會怎樣」,前提是得有一條真的連線,而這個系列到目前為止的測試全部跑在 TestEngine 上,一次都沒有走過真的 socket,下一篇補上 2 層 end to end,一層在同一個 process 裡起真的 Netty,一層用 Testcontainers 從外面打這篇剛建好的 image,順便把上面那個 5 秒的 503 量完整
同步刊登於 Blog
圖片來源:AI 產生


 iThome鐵人賽
 看影片追技術