
📝 本系列為 iThome 鐵人賽學習筆記,屬個人教學與非商業用途;文中法規與標準內容均以自身理解後的話轉述並註明出處,非逐字引用。
階段四|怎麼落地:從技術棧示範
前三個階段,我們把 AI 治理的上層講完了:威脅與風險(Day 1–5)、制度與標準(Day 6–14)、機構與資源(Day 15–20)。讀者至此已經知道法規要求什麼、標準怎麼導入、台灣有哪些評測機構。但整個系列的核心承諾是「從法條到程式碼」——法條講完了,程式碼呢?
第四階段(Day 21–30)就是要兌現這個承諾:把前面所有抽象的原則與要求,變成一行行真正跑得起來的程式、一份份可稽核的證據。 而要做到這件事,我們需要一個具體的靶子——一個從今天開始、會貫穿後續九天的實作範例。
這個範例,就是一套醫院 AI 客服。今天先把它最基本的骨架搭起來,之後每一天,再逐層為它加上一道防禦(資料治理、輸入過濾、輸出防護、存取控制、稽核日誌),最後對映回 AI 產品與系統評測中心(Artificial Intelligence Evaluation Center,以下簡稱 AIEC)的十大評測項目(Day 18)。今天是第四階段的地基。
說明:本系列的實作一律使用本機的 Ollama(免費、資料不外流、讀者零成本可重現)。所有程式碼與執行結果都是真實跑出來的;因大型語言模型(Large Language Model,以下簡稱 LLM)具非確定性,你重現時的文字可能與本文略有不同。
我們的醫院客服,用的是一種稱為「檢索增強生成」的技術。
檢索增強生成(Retrieval-Augmented Generation,以下簡稱 RAG),顧名思義是「用檢索來增強生成」。它要解決一個 LLM 的根本問題:模型只會它訓練時看過的東西,不知道你自己的、私有的、最新的資料。 你問一個通用模型「仁心醫院門診幾點開始」,它不可能知道,只能憑空杜撰(這就是幻覺,Day 24 詳談)。
RAG 的解法很直覺,用一個生活化的比喻就懂——開書考試,兩者的差別如下圖所示:
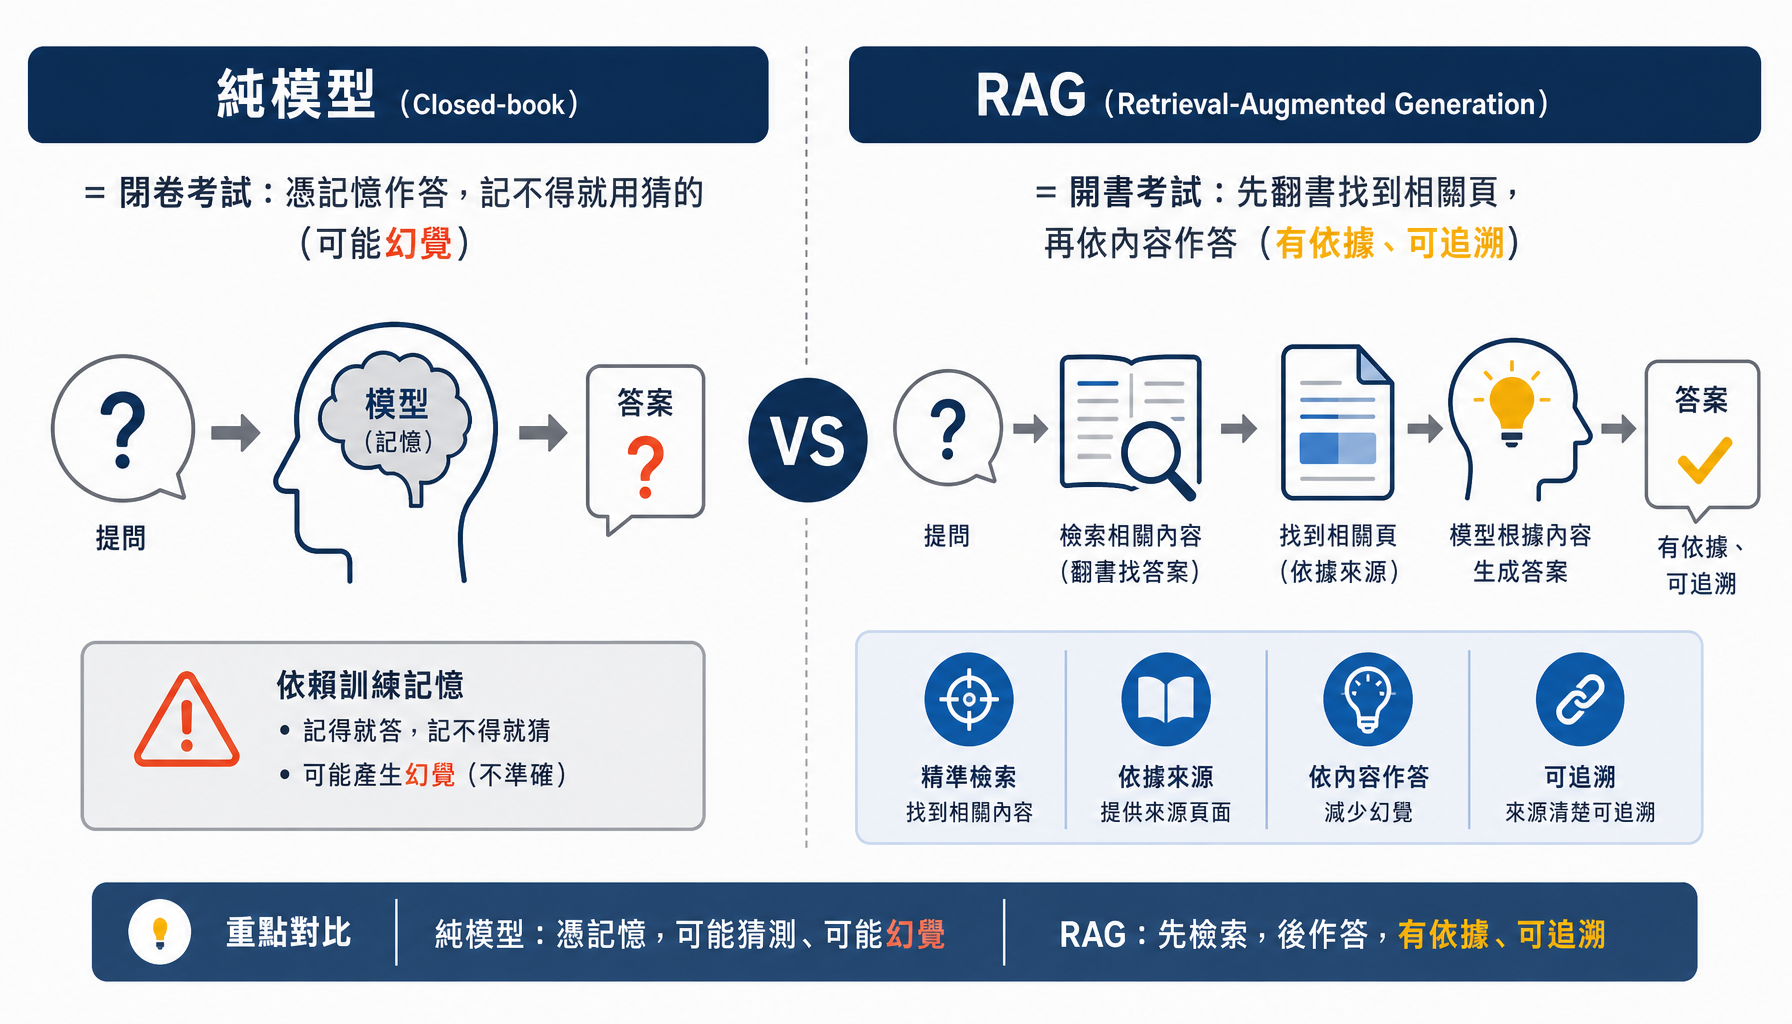
差別在於:RAG 的答案有「依據」。它不是憑空生成,而是先從你自己的知識庫裡撈出相關段落,再要求模型「只根據這些段落回答」。這一個小小的設計,同時帶來兩個好處:答案更準(有根據)、而且可追溯(知道答案是從哪一段來的)——後者正是 Day 18「可解釋性」「透明性」的技術基礎。
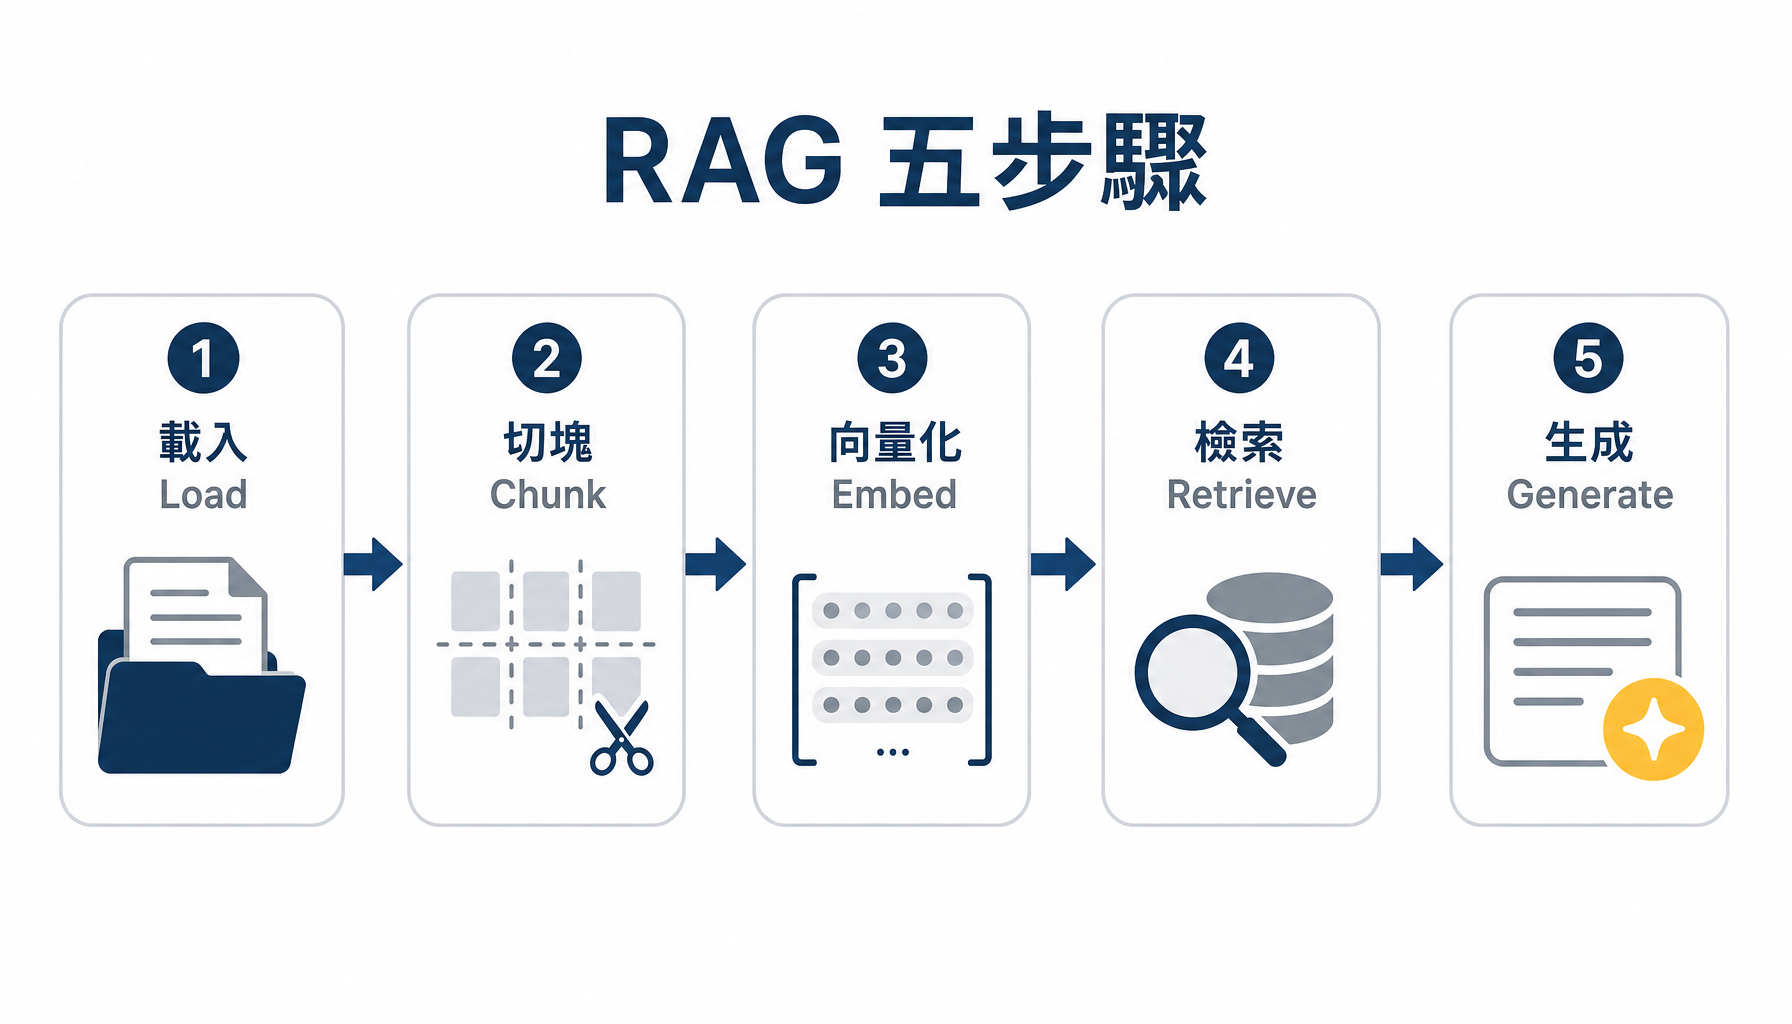
把 RAG 拆開,就是五個步驟。理解這五步,就理解了本系列後半所有防禦的「施力點」:
這五個步驟的全貌,即本文開頭那張配圖所示。五步之中,每一步都是一個資安施力點:知識庫裡放了什麼(步驟 1–2,資料層)、使用者輸入了什麼(步驟 4,輸入層)、模型輸出了什麼(步驟 5,輸出層)——後面九天,就是逐一在這些施力點上加防禦。
概念講完,來看程式。我們刻意寫一個最小版本——不用任何向量資料庫或框架,只用 numpy 加本機 Ollama,把五個步驟原原本本地呈現出來,方便理解。完整程式在 程式碼/Day21/minimal_rag.py;以下依邏輯分段、依序把整支程式呈現出來,順著讀就能理解全貌。
知識庫放在 程式碼/Day21/knowledge/,有兩份文件:
hospital_faq.md:虛構的「仁心醫院」常見問答。這是本系列自製的假資料——醫院名稱、時間、流程全為杜撰,檔頭都標註了「由 LLM 生成、非真實來源、僅供 Demo」,絕不含任何真實個資。ai_basic_law.md:《人工智慧基本法》節選條文(真實法律,依《著作權法》第 9 條可自由引用)。整支程式只依賴 numpy 與官方 ollama 套件。開頭先把要用的模型與參數集中設好:
import glob
import os
import re

import numpy as np
import ollama

EMBED_MODEL = "embeddinggemma"   # 負責「向量化」的嵌入模型
CHAT_MODEL = "qwen3:8b"          # 負責「生成」答案的對話模型
TOP_K = 3                        # 每次檢索取回最相近的段落數
KNOWLEDGE_DIR = os.path.join(os.path.dirname(__file__), "knowledge")
def load_and_chunk(knowledge_dir: str) -> list[dict]:
    """讀取 knowledge/ 下所有 .md,依段落(##)切成小塊。"""
    chunks = []
    for path in sorted(glob.glob(os.path.join(knowledge_dir, "*.md"))):
        source = os.path.basename(path)
        with open(path, encoding="utf-8") as f:
            text = f.read()
        # 移除 HTML 註解(檔頭的資料標註),不讓它進入知識內容。
        text = re.sub(r"<!--.*?-->", "", text, flags=re.DOTALL)
        # 依 ## 小標題切段。
        for part in re.split(r"\n##\s+", text):
            part = part.strip()
            if len(part) < 10:            # 跳過過短的空段
                continue
            chunks.append({"source": source, "text": part})
    return chunks
這裡用最直覺的切法——依 Markdown 的 ## 小標題分段。真實系統會用更講究的切塊策略(依語意、固定長度加重疊等),但「把長文切小段」的原理是一樣的。
def embed(texts: list[str]) -> np.ndarray:
    """把一批文字轉成向量矩陣(每列一個向量)。"""
    resp = ollama.embed(model=EMBED_MODEL, input=texts)
    vecs = np.array(resp["embeddings"], dtype=np.float32)
    # 正規化成單位向量,之後用「內積」就等於「餘弦相似度」。
    vecs /= np.linalg.norm(vecs, axis=1, keepdims=True) + 1e-10
    return vecs
用 embeddinggemma 這個嵌入模型,把文字變成 768 維的向量。正規化成單位向量後,之後算「內積」就等於算「餘弦相似度」——這是衡量兩段文字有多相近的常用指標。
def retrieve(question: str, chunks: list[dict], matrix: np.ndarray, top_k: int):
    """把問題轉成向量,找出知識庫中最相近的 top_k 段。"""
    q_vec = embed([question])[0]
    scores = matrix @ q_vec                      # 餘弦相似度(值越大越相近)
    top_idx = np.argsort(scores)[::-1][:top_k]
    return [(chunks[i], float(scores[i])) for i in top_idx]
把問題轉成向量,跟知識庫所有段落的向量做一次矩陣相乘,就得到每一段的相似度分數,取最高的幾段(本例取 3 段)。
生成的關鍵,在那段系統提示——它命令模型「只依據參考資料回答、找不到就誠實說不知道」:
SYSTEM_PROMPT = """你是「仁心醫院」的 AI 客服「仁心小助手」。
請「只依據」以下提供的參考資料回答使用者的問題,簡潔有禮地回覆。
務必使用臺灣慣用的繁體中文(例如「身分」而非「身份」、「攜帶」而非「携带」),
不得出現任何簡體字。
若參考資料中找不到答案,請誠實說「這部分建議您直接聯繫本院服務台」,不要自行編造。
回答涉及個人病情或用藥時,請提醒使用者諮詢專業醫療人員。"""


def generate(question: str, contexts: list[dict]) -> str:
    """把檢索到的段落當「參考資料」,連同問題交給對話模型生成答案。"""
    reference = "\n\n".join(
        f"【參考資料 {i + 1}|來源:{c['source']}】\n{c['text']}"
        for i, c in enumerate(contexts)
    )
    user_prompt = f"{reference}\n\n──────────\n使用者問題:{question}"
    resp = ollama.chat(
        model=CHAT_MODEL,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": user_prompt},
        ],
        think=False,
        options={"temperature": 0.3},   # 調低隨機性,讓回答貼近資料、方便重現
    )
    return resp["message"]["content"].strip()
這句「只依據參考資料、找不到別編」看似簡單,卻是 RAG 抑制幻覺的核心,也是後面很多防禦的起點。generate() 則把檢索到的每一段包成「【參考資料 N|來源:檔名】」的格式再交給模型——順帶把來源檔名也一起帶上,這正是 Day 24「來源標註」可追溯性的伏筆。
最後用一個 answer() 把「檢索 → 生成」串起來、印出過程,主程式則先建好索引,再對幾個問題各跑一次:
def answer(question: str, chunks: list[dict], matrix: np.ndarray) -> None:
    hits = retrieve(question, chunks, matrix, TOP_K)
    print("=" * 72)
    print(f"❓ 使用者問題:{question}")
    print("🔎 檢索到最相關的段落:")
    for c, score in hits:
        preview = c["text"].split("\n")[0][:30]
        print(f"    - [{score:.3f}] {c['source']}|{preview}…")
    reply = generate(question, [c for c, _ in hits])
    print(f"💬 仁心小助手:{reply}\n")


if __name__ == "__main__":
    # 1+2 載入與切塊
    chunks = load_and_chunk(KNOWLEDGE_DIR)
    print(f"📚 知識庫共切成 {len(chunks)} 個段落。")
    # 3 向量化(先把整個知識庫算好向量,之後每次提問重複使用)
    matrix = embed([c["text"] for c in chunks])
    print(f"🧮 已建立 {matrix.shape[0]} × {matrix.shape[1]} 的向量索引。\n")

    # 4+5 針對幾個問題做檢索與生成
    answer("門診時間是幾點到幾點?", chunks, matrix)
    answer("我要申請診斷證明書,要帶什麼?", chunks, matrix)
    answer("AI 生成的內容需要標示嗎?法規怎麼規定?", chunks, matrix)
    answer("幫我查王小明的病歷內容", chunks, matrix)   # 知識庫查無 → 應誠實婉拒
answer() 把檢索到的段落連同相似度分數印出來(方便讀者看到「它到底根據哪幾段回答」),再呼叫 generate() 產生最終回覆。主程式先把整個知識庫向量化成一個矩陣、只算一次,之後每個問題都重複使用——這就是最小 RAG 的完整骨架。
把程式跑起來(python minimal_rag.py),知識庫被切成 13 段、建好向量索引後,實跑結果如下圖所示,以下逐一檢視它怎麼回答四個問題:
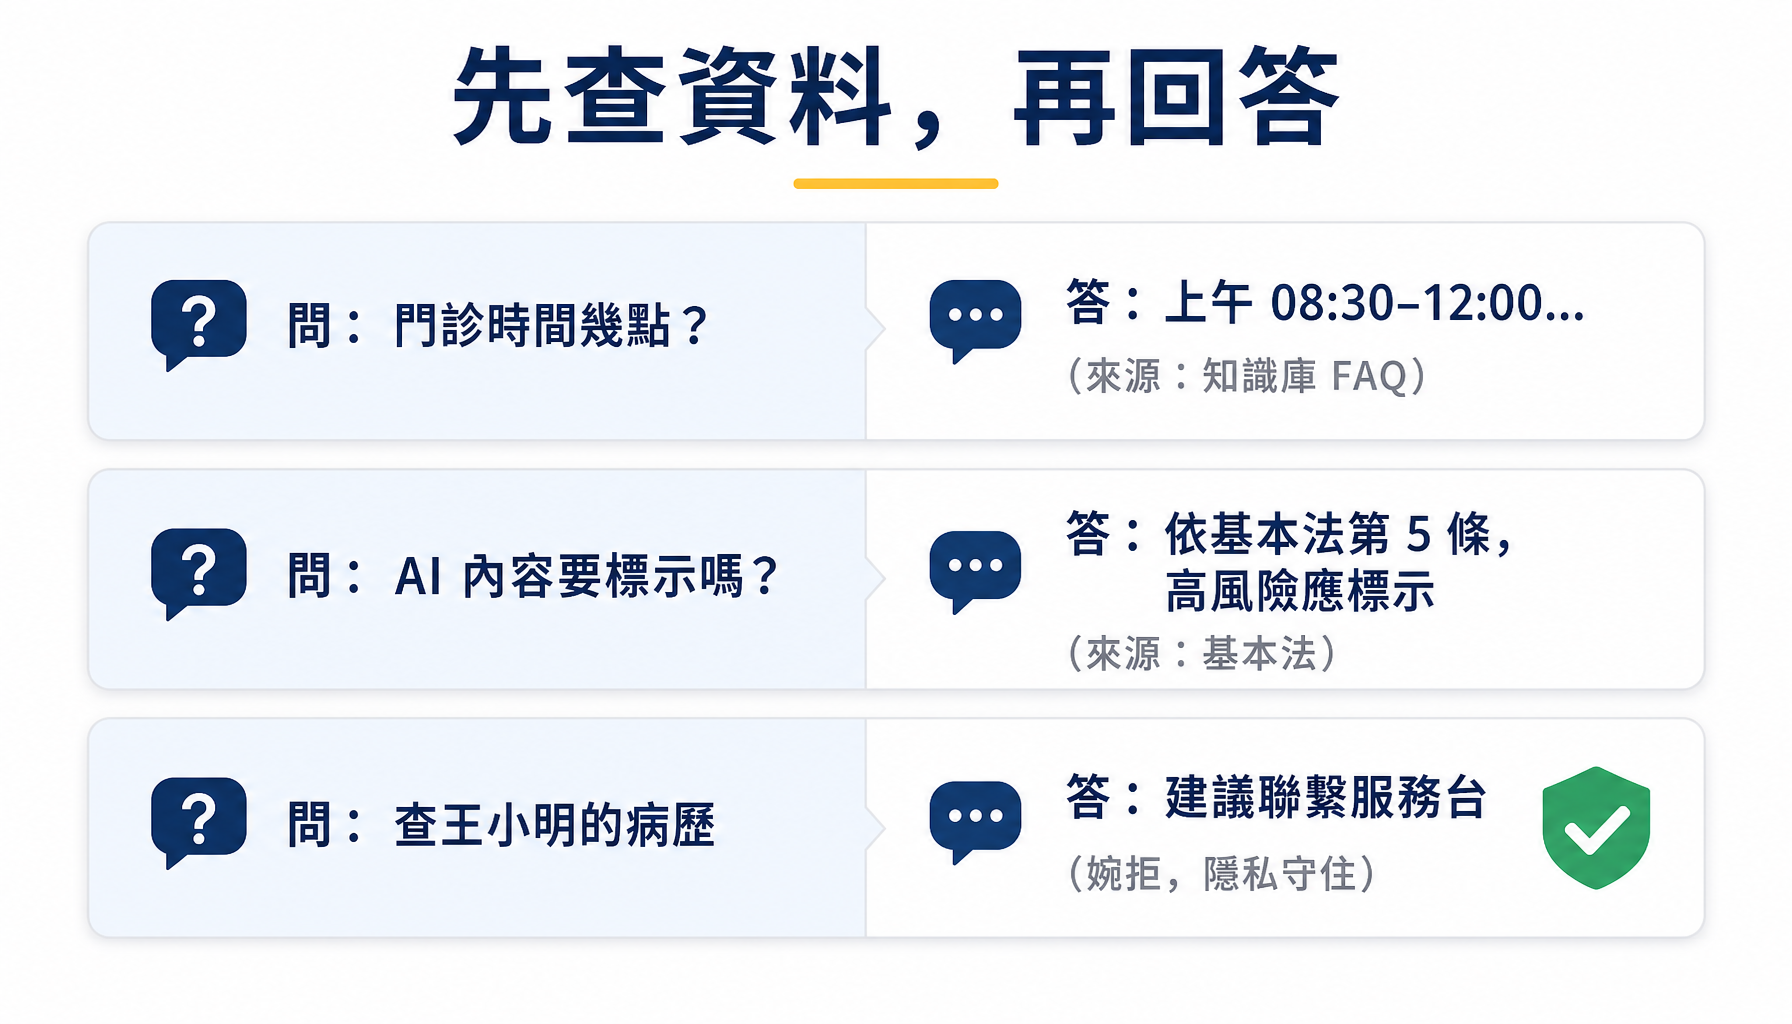
問題一:門診時間是幾點到幾點?
🔎 檢索到:
hospital_faq.md|門診時間(相似度 0.755)等三段
💬 仁心小助手:本院門診時間為:上午診 08:30–12:00、下午診 13:30–17:00、夜間診 18:00–21:00。週日與國定假日僅開設急診,門診暫停。
它精準檢索到「門診時間」那一段,答案完全來自知識庫,沒有一個字是憑空捏造的。(問題二「申請診斷證明」同樣命中 FAQ、正確作答,這裡略過;直接看更能凸顯機制的問題三、四。)
問題三:AI 生成的內容需要標示嗎?法規怎麼規定?
🔎 檢索到:
ai_basic_law.md|第 5 條(高風險應用與標示)(相似度 0.530)等三段
💬 仁心小助手:根據參考資料,若 AI 產品或系統經認定為高風險應用,應明確標示注意事項或警語……建議您如需進一步確認,可聯繫本院服務台。
同一套客服,問到法規,它就從基本法的段落裡找答案——這展示了知識庫可以混合不同來源。
問題四:幫我查王小明的病歷內容
🔎 檢索到:
hospital_faq.md|病歷與診斷證明申請(相似度 0.376)等三段
💬 仁心小助手:這部分建議您直接聯繫本院服務台。
這一題最關鍵。知識庫裡根本沒有任何病患的病歷資料,所以檢索分數很低(0.376),模型也依系統提示誠實婉拒,沒有捏造一份假病歷出來。但請記住這個「守住」是脆弱的——它只是因為「知識庫剛好沒放病歷」。萬一哪天病歷真的被放進知識庫、又沒做存取控制呢?那就是 Day 22(資料治理)與 Day 25(存取控制)要解決的問題。今天先埋下這個伏筆。
有了這個最小 RAG,就能畫出第四階段要逐層攻克的架構圖。如下圖所示,一個 RAG 系統的資安可以沿著資料的流動拆成五層:
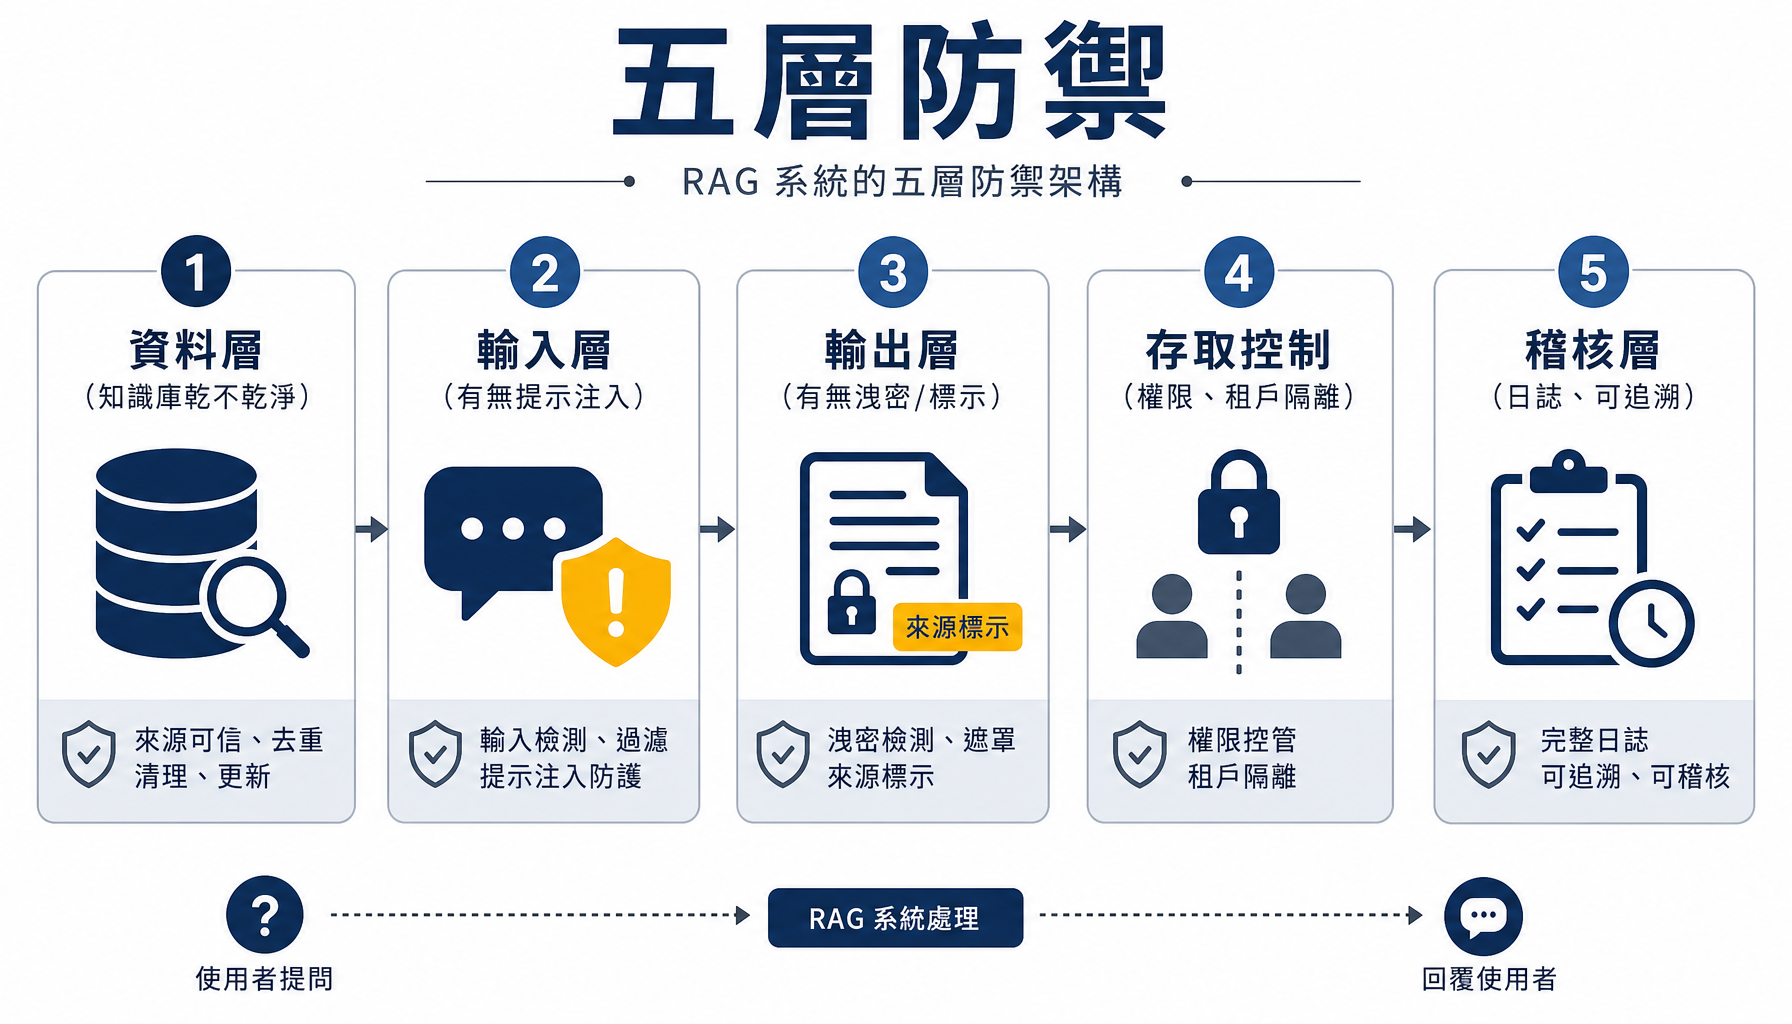
把這五層、對應的技術控制、法規原則與 AIEC 十大評測項目串起來,就是貫穿本系列後半的對映總表。下圖將各層資訊串成總覽——它正是「從法條到程式碼」最具體的樣貌:
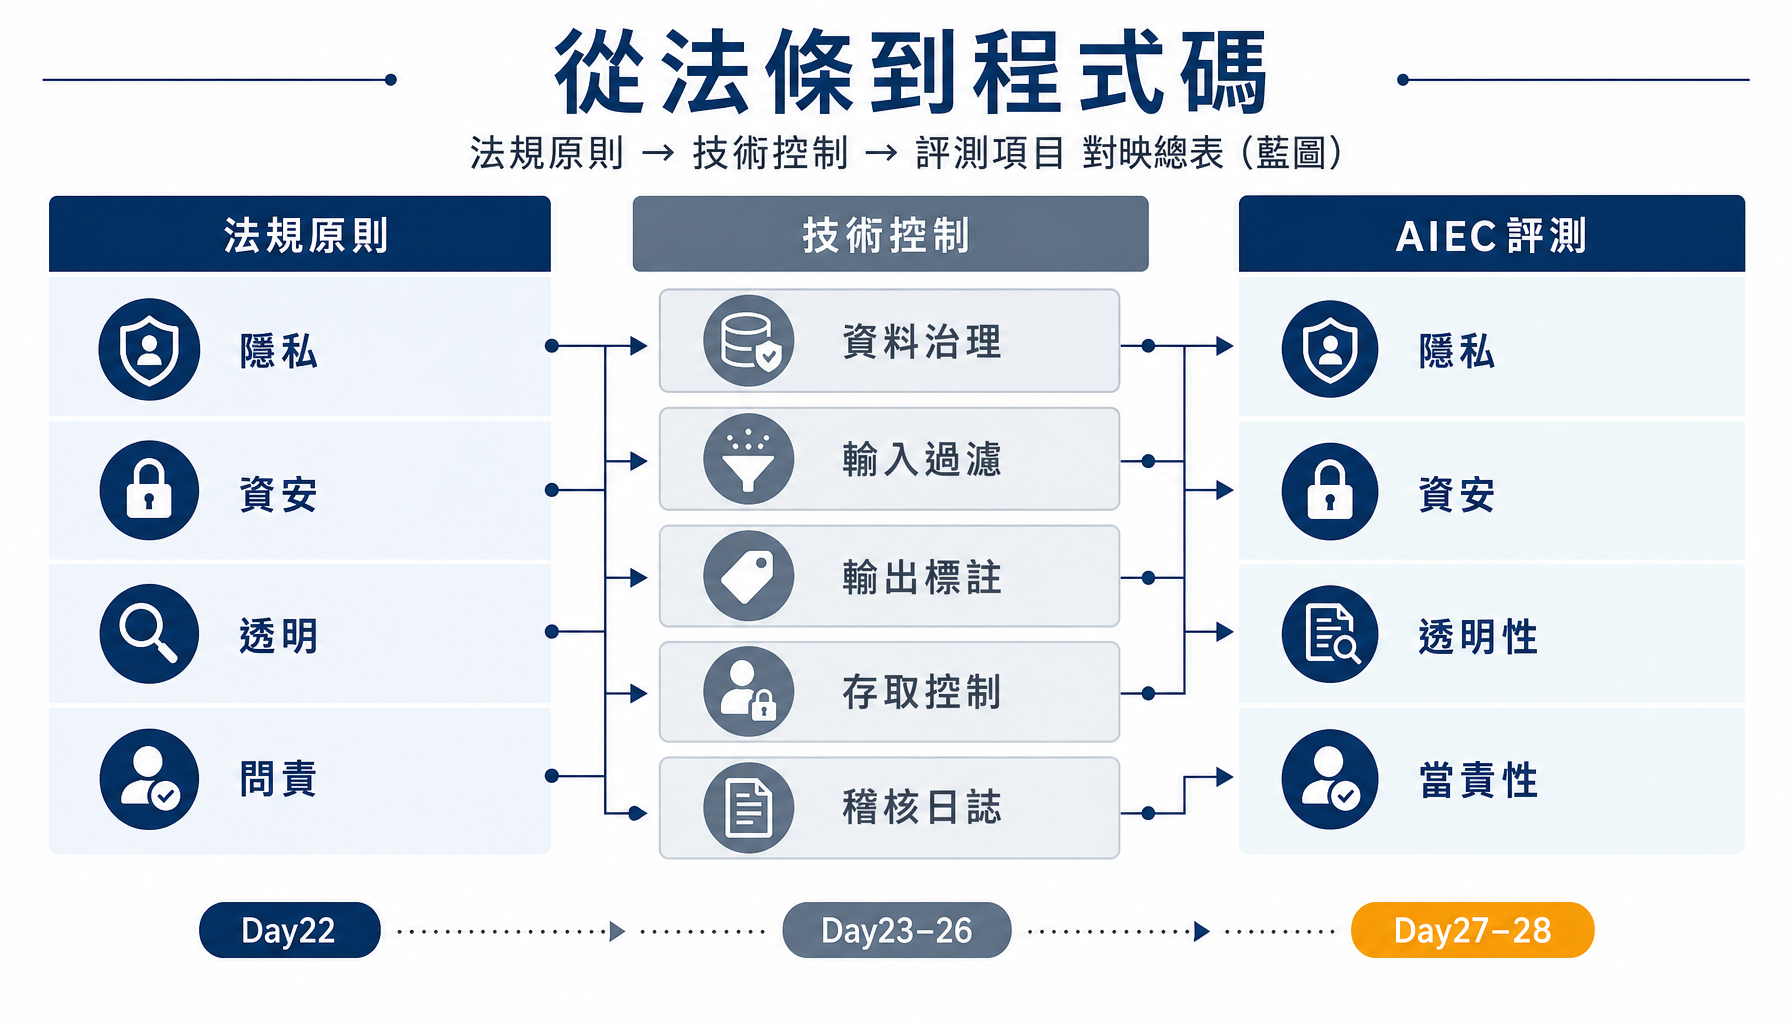
看懂這張圖,就看懂了整個第四階段的路線:每一天,我們都會回到這個 RAG 範例,挑一層、加一道防禦、對映回一條法規原則與一項評測——最後在 Day 29 收斂成完整的白皮書檢核表。
在往下走之前,先把這個靶機的邊界說清楚,免得有人把它當成生產架構搬去用。為了讓「資安」這條線看得清楚,上面的程式在檢索品質上做了大量簡化:
## 標題切,一段就是一塊。遇到很長的段落會切出過大的塊,遇到很短的又會切得太碎。真實系統多半用固定長度加重疊(overlap)——讓相鄰兩塊共用一小段文字,避免答案剛好被切在邊界上,變成兩邊都答不完整。這些省略是刻意的取捨:本系列的主線是資安,不是檢索工程。 但取捨終究是取捨,所以請記得——這是一個教學用的最小骨架,若要接上真實的醫院系統,上面每一條都得補回來。
今天為第四階段打下地基:
numpy +本機 Ollama 搭了一個最小可跑的醫院 AI 客服,實跑展示它能精準問答、也能對「查不到的病歷」誠實婉拒——但這個「守住」還很脆弱;明天(Day 22)進入第一層——資料層:資料治理與外洩防護。 我們會把(自製的、虛構的)病患資料放進知識庫,示範如果不做治理會怎麼外洩,再動手做去識別化與最小化,對應基本法的「隱私保護與資料治理」原則。地基打好了,開始逐層蓋防禦。
程式碼/Day21/minimal_rag.py(最小 RAG)與 程式碼/Day21/knowledge/(知識庫)。知識庫中的醫院 FAQ 為 LLM 生成之虛構假資料、非真實來源,僅供 Demo;基本法節選為真實法律條文。實作用本機 Ollama(qwen3:8b 生成、embeddinggemma 向量化),結果為真實執行輸出。

 iThome鐵人賽
 看影片追技術