
第三天,我們要來認識 Python 資料分析的核心基石——NumPy。後續會大量使用的 Pandas 表格與繪圖套件,底層都是依賴 NumPy 進行高速的矩陣與數值運算。今天我們同樣以純 .py 腳本建立 day03_numpy_basics.py,掌握陣列的基本操作與向量化運算。
第一部分
新建 day03_numpy_basics.py,寫下陣列的建立與基礎屬性檢查: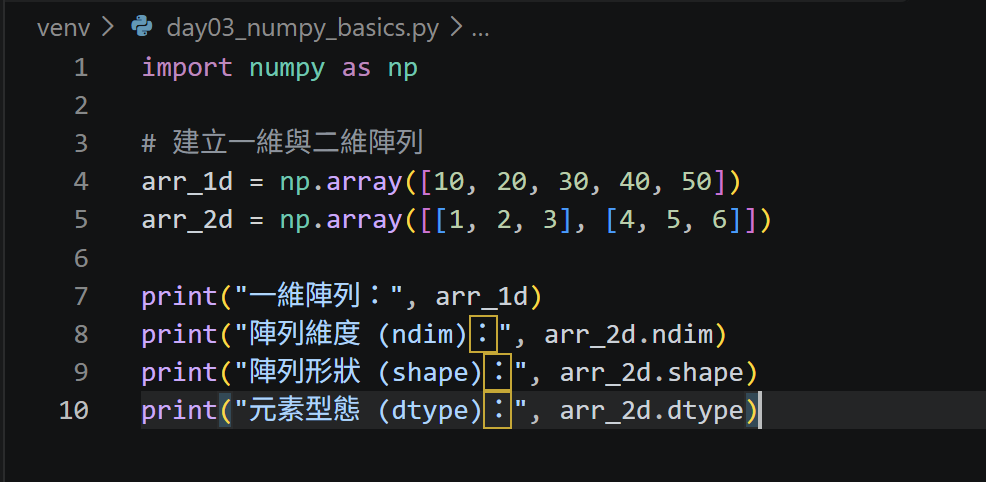
第二部分
接著進行陣列形狀變換與常態分佈/隨機數值的生成: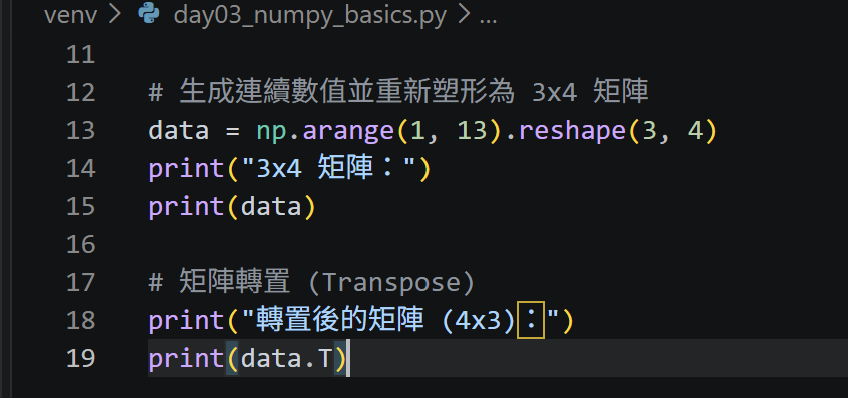
第三部分
最後體驗 NumPy 最強大的特性——向量化運算與布林遮罩篩選,完全不需要寫任何 for 迴圈: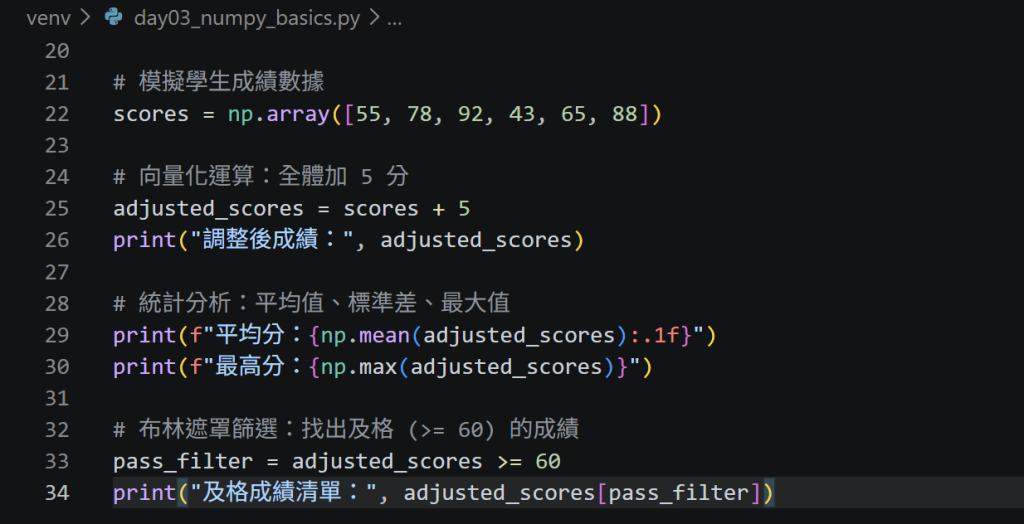
執行 python day03_numpy_basics.py 後,終端機順利印出矩陣形狀、轉置結果以及篩選後的成績陣列。
第四部分
確認程式運作無誤後,將今天的進度推送到 GitHub 進行版本控制: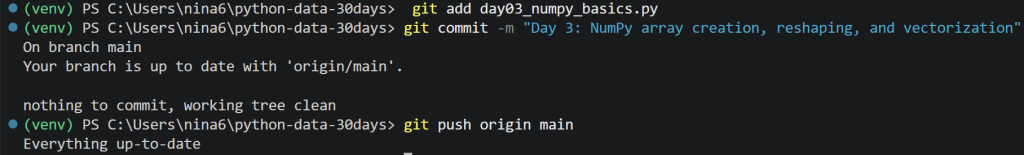
我前面已經commit過了,但後面打錯重用,才會顯示nothing to commit。
終端機顯示更新推送成功,回到 GitHub 重新整理頁面,就能看到今天新增的 day03_numpy_basics.py。
今日心得/遇到的問題
今天體驗到 NumPy 向量化運算的強大之處。在傳統 Python 寫法中,如果要把清單內的數字全部加上 5 或進行條件過濾,必須透過 for 迴圈或推導式逐一處理;而在 NumPy 中直接使用 scores + 5 就能一次完成,程式碼精簡而且運算效率極高。

 niii

 iThome鐵人賽
 看影片追技術