
又多花了一整天整理資料後,我一直在思考我犯的錯誤。
其實在參考各大字典的資料設計,重新建立規則後,果斷地把資料庫刪掉,重新注入 121 份單字筆記。會是更乾淨的作法。
但人類有時候會沉迷在很細微的手工作業裡,我也不知不覺沉迷在在各種單字整理小規則的堆疊⋯⋯
(是的,我其實很有幸福感,這是辦公室文明進化史中,足以毀滅人類文明的「無價值產出的勞動驅動」,反價值的事情有時候做起來更開心。)
不過因為鐵人賽還在進行,只好被迫用一種歡快的語氣記錄這段毫無意義的整理工程。
進度:
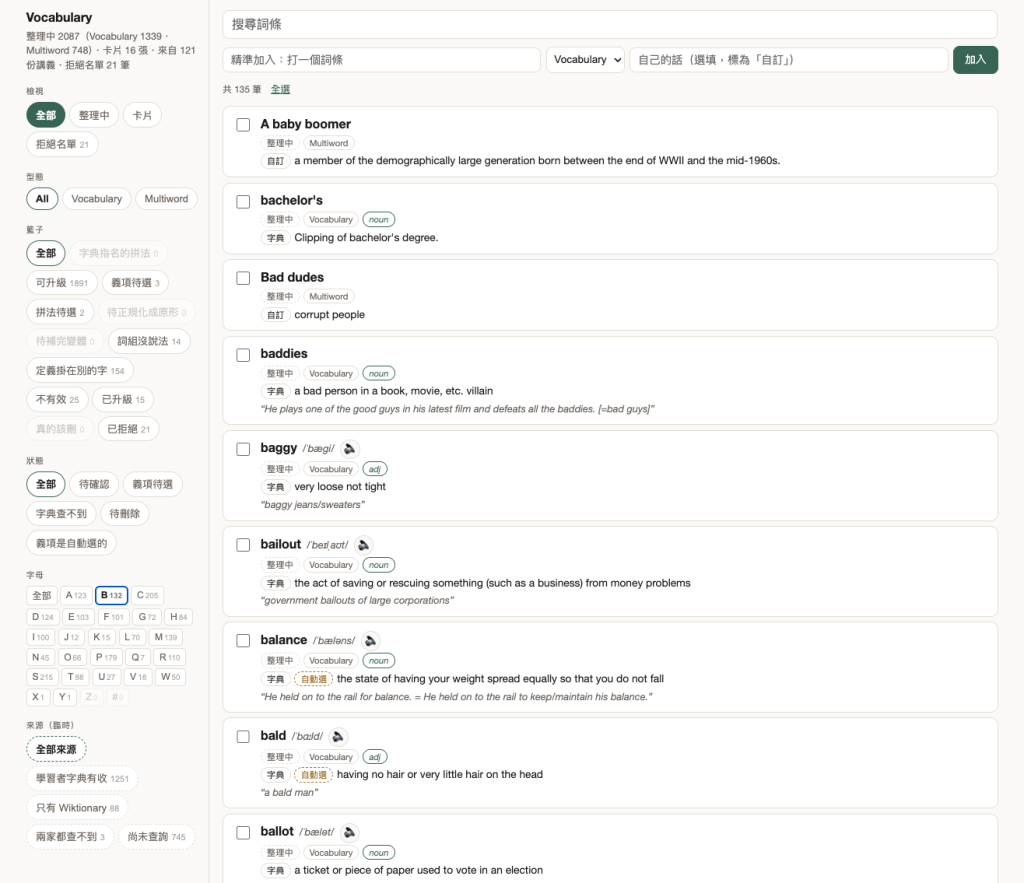
saving account,非母語的人有時候不知道要這樣說。beat around the bush 這種give something up 、get well on,這種對練習劍橋英檢蠻重要的,因為劍橋英檢在聽力裡卡了很多這種片語,聽不懂就會完全錯判。所以我在準備時有下載專門的 app 來做複習。一邊參考字典的作法,一邊區分種子資料中有效 v.s. 無效的內容。漸漸變成這樣
前端:
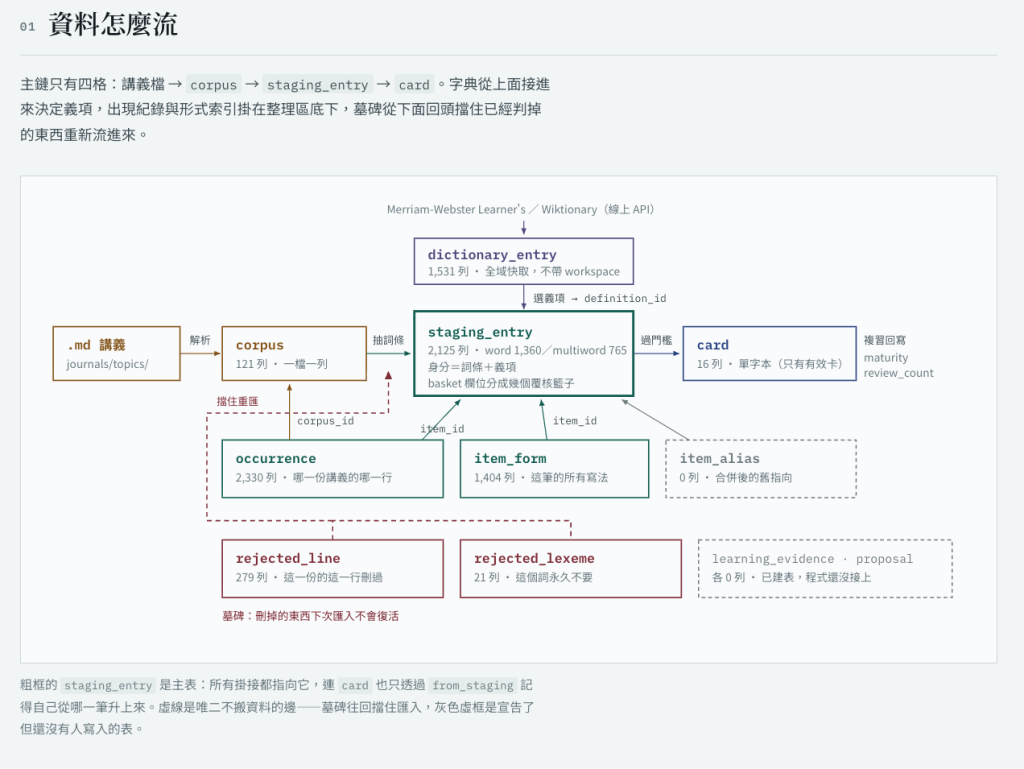
相關資料表:
我覺得還需要花 5 小時左右清理一下。希望今天睡前可以再處理一下。
明天無論如何要碰到新功能!
因為單字本整理會需要等 AI 清理、試用、抓 bug 再修。
在等待的過程中開了另一個獨立支線,先把口說功能做了一個原型。
這年我試用了一些付費口語 AI 教練 app,其中我最喜歡的是 Loora:
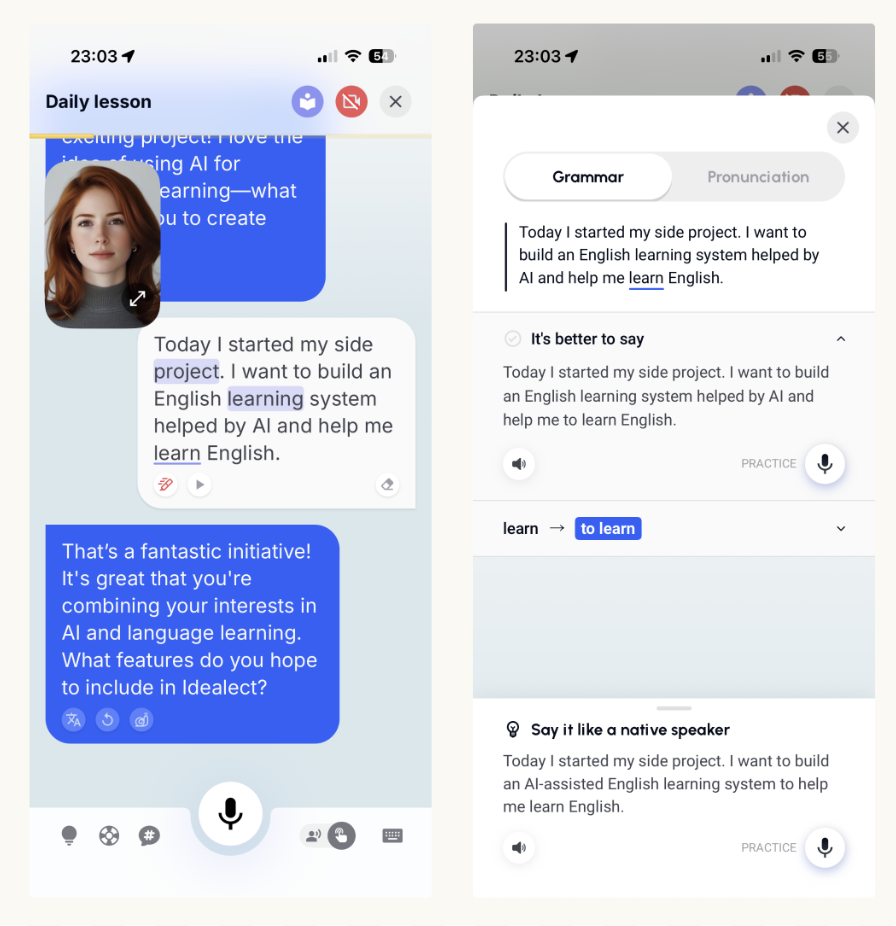
核心功能是:
至於有一個爽朗的 AI 教練互動,那個是考試導向的我,目前不需要的功能。(而且我真的覺得,和 這種 app 裡的 AI 教練聊天很無聊)
總之,AI 幫我選了適合的模型:ASR:parakeet-ctc-0.6b(NVIDIA FastConformer-CTC,經 MLX 跑 Apple Silicon)
跑了幾輪測試後還算滿意。我們就先把一個最小可用的介面做出來。
第一版,直接套用 Python 函式庫的介面:
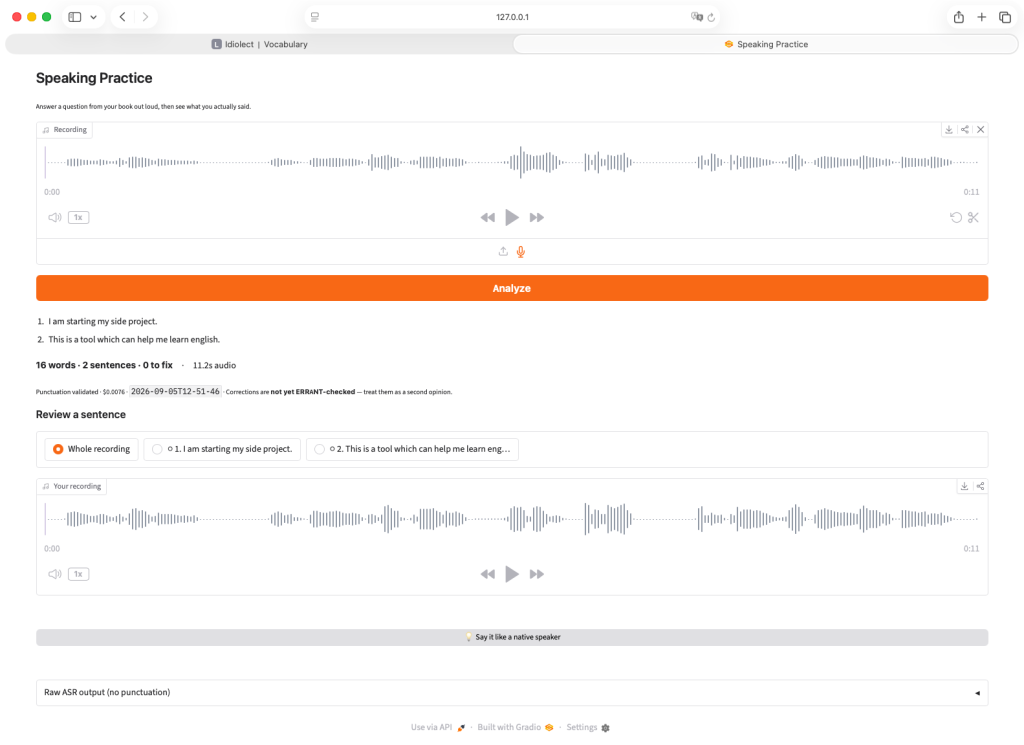
然後把前端做起來:
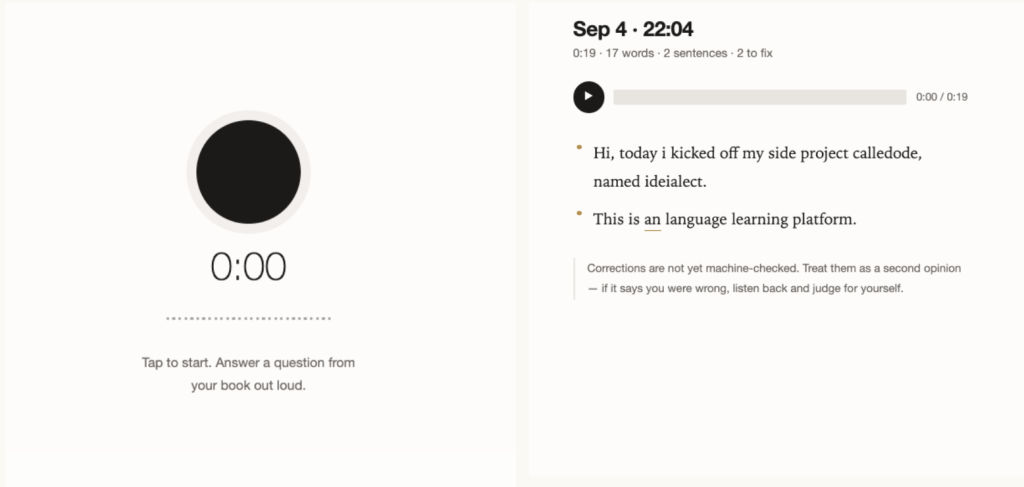
這個前端我沒有很滿意,但今天的進度只改到這邊!
口說是一個比較獨立的工具。目前我的主線任務是在單字本上面,希望明天可以解脫!


 iThome鐵人賽
 看影片追技術