
📝 本系列為 iThome 鐵人賽學習筆記,屬個人教學與非商業用途;文中法規與標準內容均以自身理解後的話轉述並註明出處,非逐字引用。
階段四|怎麼落地:從技術棧示範
過去兩天,我們沿著資料的流動,替醫院 AI 客服守住了兩道關:資料層(Day 22,把個資在進庫前就治理掉)與輸入層(Day 23,擋住直接與間接的提示注入)。這兩層守的都是「進去的東西」——進知識庫的資料、進模型的輸入。
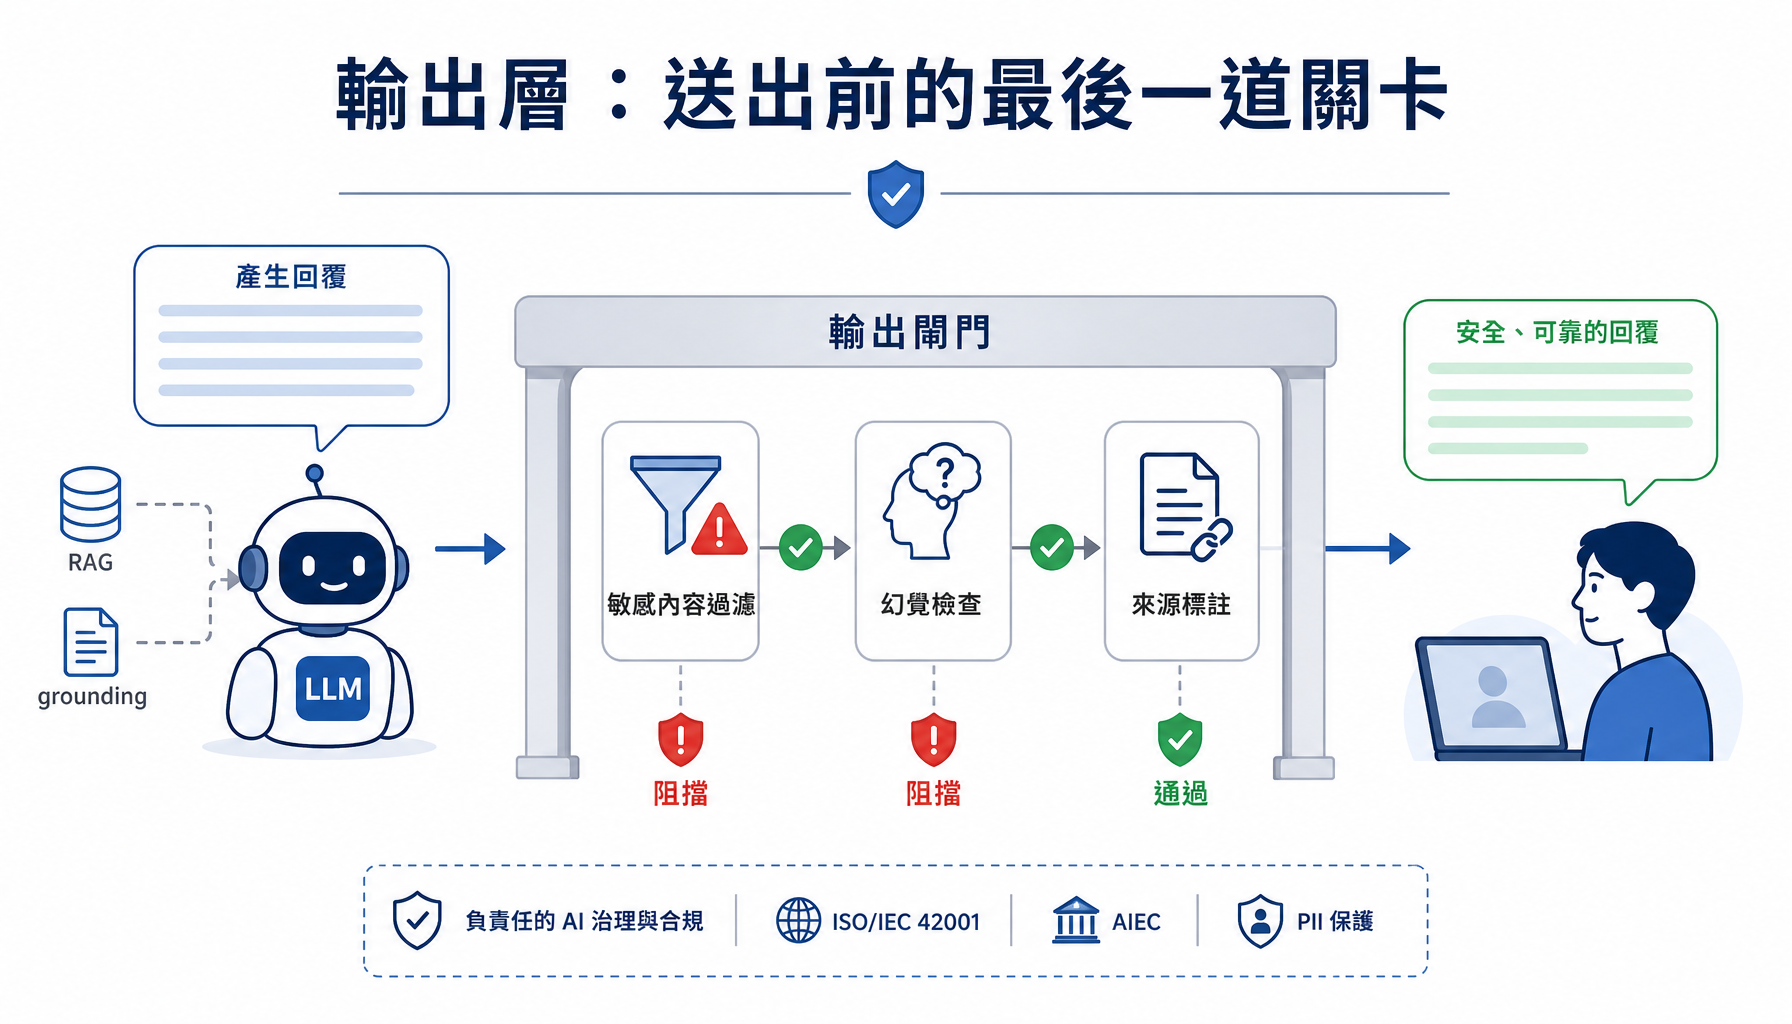
今天要守的,是**「出來的東西」**。模型依據參考資料生成了一段回覆,這段回覆在真正送到使用者眼前之前,還該不該再過一關?答案是肯定的。這正是第四階段第三層——輸出層——要回答的三個問題:
檢索增強生成(Retrieval-Augmented Generation,以下簡稱 RAG,原理見 Day 21)讓答案「有依據」,但「有依據」不等於「安全、可信、可追溯」。輸出層要做的,就是把這三件事補齊。
有讀者可能會問:資料層已經把個資治理掉、輸入層也擋住了注入,出口這關是不是多餘?
恰恰相反。這正是 Day 23 談過的縱深防禦(Defense in Depth)精神——不能假設前面每一道防線都滴水不漏。 資料治理可能有漏網的個資、輸入過濾的樣式庫可能被新的變化球繞過、模型本身也可能因為幻覺而生出錯誤內容。輸出層就是這條防線的最後一哩:假設前面全都失守了,出口這關能不能兜底攔下來?如下圖所示,資料、輸入、輸出三層防線依序排開,輸出層站在最後一個位置。
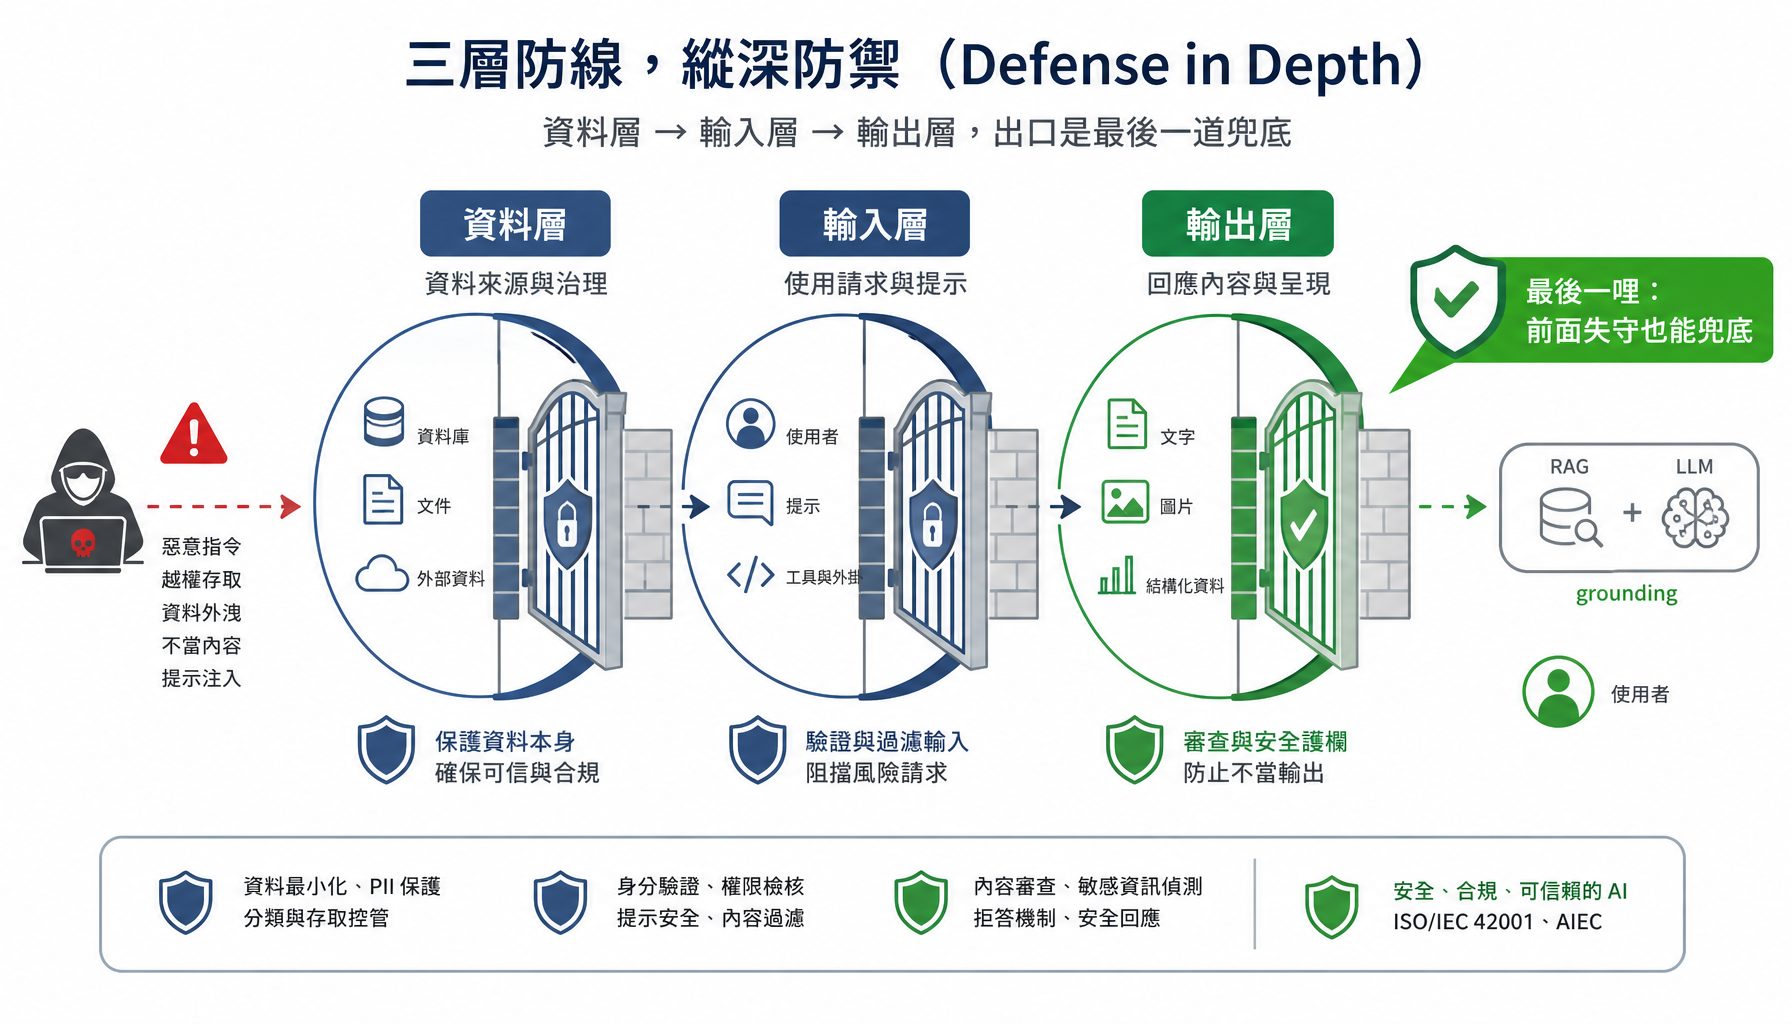
所以輸出層的價值,不在於它「多做了什麼新鮮事」,而在於它站在最後一個位置:無論內容是怎麼跑到回覆裡的——是資料層漏掉的、是注入誘導的、還是模型幻覺捏造的——只要它出現在「要送出去的那段文字」裡,輸出層就有機會攔下。下面我們用三個情境,把輸出層的三道防禦逐一做出來。
三道防禦,都是可以搬到任何大型語言模型(Large Language Model,以下簡稱 LLM)應用的樣板。以下逐段拆解整支程式(完整檔在 程式碼/Day24/output_guard_rag.py)。我們保留一個「未設防」版本(直接把模型輸出丟回去,重現 Day 21 的做法)與「已設防」版本並排對照。
先看匯入與常數。除了標準函式庫,只需要 numpy 與 ollama;GROUNDING_THRESHOLD 是稍後幻覺防護要用的相似度門檻:
import glob
import os
import re

import numpy as np
import ollama

EMBED_MODEL = "embeddinggemma"
CHAT_MODEL = "qwen3:8b"
TOP_K = 3
GROUNDING_THRESHOLD = 0.50   # 最高相似度低於此值,視為「知識庫查無足夠依據」
KNOWLEDGE_DIR = os.path.join(os.path.dirname(__file__), "knowledge")
接著是 RAG 的骨幹,原理與 Day 21 相同:載入切塊、向量化、取相似度最高的 TOP_K 段。注意 retrieve() 回傳的是「段落與分數」成對的清單——那個分數等一下就是幻覺防護的判斷依據:
def load_and_chunk(knowledge_dir: str) -> list[dict]:
    chunks = []
    for path in sorted(glob.glob(os.path.join(knowledge_dir, "*.md"))):
        source = os.path.basename(path)
        with open(path, encoding="utf-8") as f:
            text = f.read()
        text = re.sub(r"<!--.*?-->", "", text, flags=re.DOTALL)  # 去掉檔頭標註
        for part in re.split(r"\n##\s+", text):
            part = part.strip()
            if len(part) >= 10:
                chunks.append({"source": source, "text": part})
    return chunks


def embed(texts: list[str]) -> np.ndarray:
    resp = ollama.embed(model=EMBED_MODEL, input=texts)
    vecs = np.array(resp["embeddings"], dtype=np.float32)
    vecs /= np.linalg.norm(vecs, axis=1, keepdims=True) + 1e-10
    return vecs


def retrieve(question: str, chunks: list[dict], matrix: np.ndarray, top_k: int):
    q_vec = embed([question])[0]
    scores = matrix @ q_vec
    top_idx = np.argsort(scores)[::-1][:top_k]
    return [(chunks[i], float(scores[i])) for i in top_idx]
第一道,是在回覆送出前,再用個資規則掃一次,命中就遮蔽。這與 Day 22 的「進庫前去識別化」互相呼應——一個守入口、一個守出口。
# 個資遮蔽規則。這是「出口」的最後一道防線:不管內容為何來源,只要回覆裡
# 出現符合個資格式的字串,一律在送出前遮蔽。與 Day 22 的「進庫前去識別化」
# 相呼應——一個守入口、一個守出口,兩道疊起來才是縱深防禦。
_PII_RULES = [
    (re.compile(r"09\d{2}-?\d{3}-?\d{3}"), "[已遮蔽電話]"),
    (re.compile(r"[A-Z][12]\d{8}"), "[已遮蔽身分證]"),
    (re.compile(r"H\d{7}"), "[已遮蔽病歷號]"),
]


def redact_pii(text: str) -> tuple[str, bool]:
    """掃描並遮蔽回覆中的個資,回傳 (遮蔽後文字, 是否有命中)。"""
    hit = False
    for pattern, mask in _PII_RULES:
        text, n = pattern.subn(mask, text)
        hit = hit or n > 0
    return text, hit
redact_pii() 用正規表示式(Regular Expression,一種文字比對規則,見 Day 22)比對電話、身分證、病歷號這些個人可識別資訊(Personally Identifiable Information,以下簡稱 PII,見 Day 22)的格式,把命中的部分換成「[已遮蔽…]」。這裡的關鍵觀念是——它不管這串個資是怎麼跑進回覆的。可能是資料層漏了一筆沒治理的、可能是被注入誘導吐出來的,出口這關一律攔。這就是「兜底」的意思。(這裡的身分證樣式 [A-Z][12]\d{8} 和 Day 22 假名化階段用的是同一條——第二碼限定 1/2,對應國民身分證統一編號的性別碼,1 為男、2 為女。至於 Day 22 入庫端那條 身分證:[A-Z][0-9]{9},它綁死了「身分證:」這個欄位標籤,所以出口這條雖然性別碼收得較緊,整體覆蓋面反而更廣——出口是最後防線,沒有欄位標籤可倚靠,只能認格式本身。)
第二道對付的是幻覺(Hallucination):模型在沒有足夠依據時,仍然「一本正經地掰出一個聽起來很合理的答案」(Day 21 曾提及此詞)。RAG 的系統提示雖然要求「找不到就說不知道」,但那是「請模型自律」——遇到對齊較弱的模型、或溫度調高時,它仍可能硬掰。
輸出層的做法,是加一道不依賴模型自律的確定性檢查:看檢索到的最高相似度。如果連最相關的段落都和問題對不太上(相似度太低),就代表知識庫其實查無依據,此時直接回一句標準的「查無足夠資料」,根本不讓模型有機會發揮想像力。
def is_grounded(hits: list[tuple]) -> bool:
    """檢索到的最高相似度是否足以支撐回答;太低代表知識庫其實查無依據。"""
    top_score = hits[0][1] if hits else 0.0
    return top_score >= GROUNDING_THRESHOLD
這道檢查稱為 grounding check(「有無事實依據」的檢查)。它的精神是:與其信任模型「應該會誠實」,不如用一個機械式的門檻,把「明顯沒依據」的情況先攔在生成之前。 門檻值(本例 0.50)要依知識庫與嵌入模型實測調整——太高會把正常問題也擋掉,太低則形同虛設。
第三道,是替每個答案附上「依據來源」與免責提示。這對應的是基本法的**「透明與可解釋」**原則(Day 8)——使用者有權知道這個答案「從哪裡來、可不可信」。
DISCLAIMER = "(本回覆由 AI 客服依知識庫生成,僅供參考,不能取代專業醫療判斷。)"


def attach_sources(reply: str, hits: list[tuple]) -> str:
    """在回覆後附上依據來源與免責提示,讓答案可追溯、可查證。"""
    sources = "、".join(dict.fromkeys(c["source"] for c, _ in hits))  # 去重、保序
    return f"{reply}\n📎 依據來源:{sources}\n{DISCLAIMER}"
attach_sources() 做兩件事:把這次回答所依據的來源檔名(去重後)附在後面,讓答案可追溯、使用者能回頭查證;再加上一句免責提示——這是針對「過度依賴(Overreliance)」的產品設計對策。使用者很容易把 AI 的回答當成權威,尤其在醫療情境下這很危險;一句「僅供參考、不能取代專業判斷」的提示,是提醒使用者保持警覺的最低成本做法。
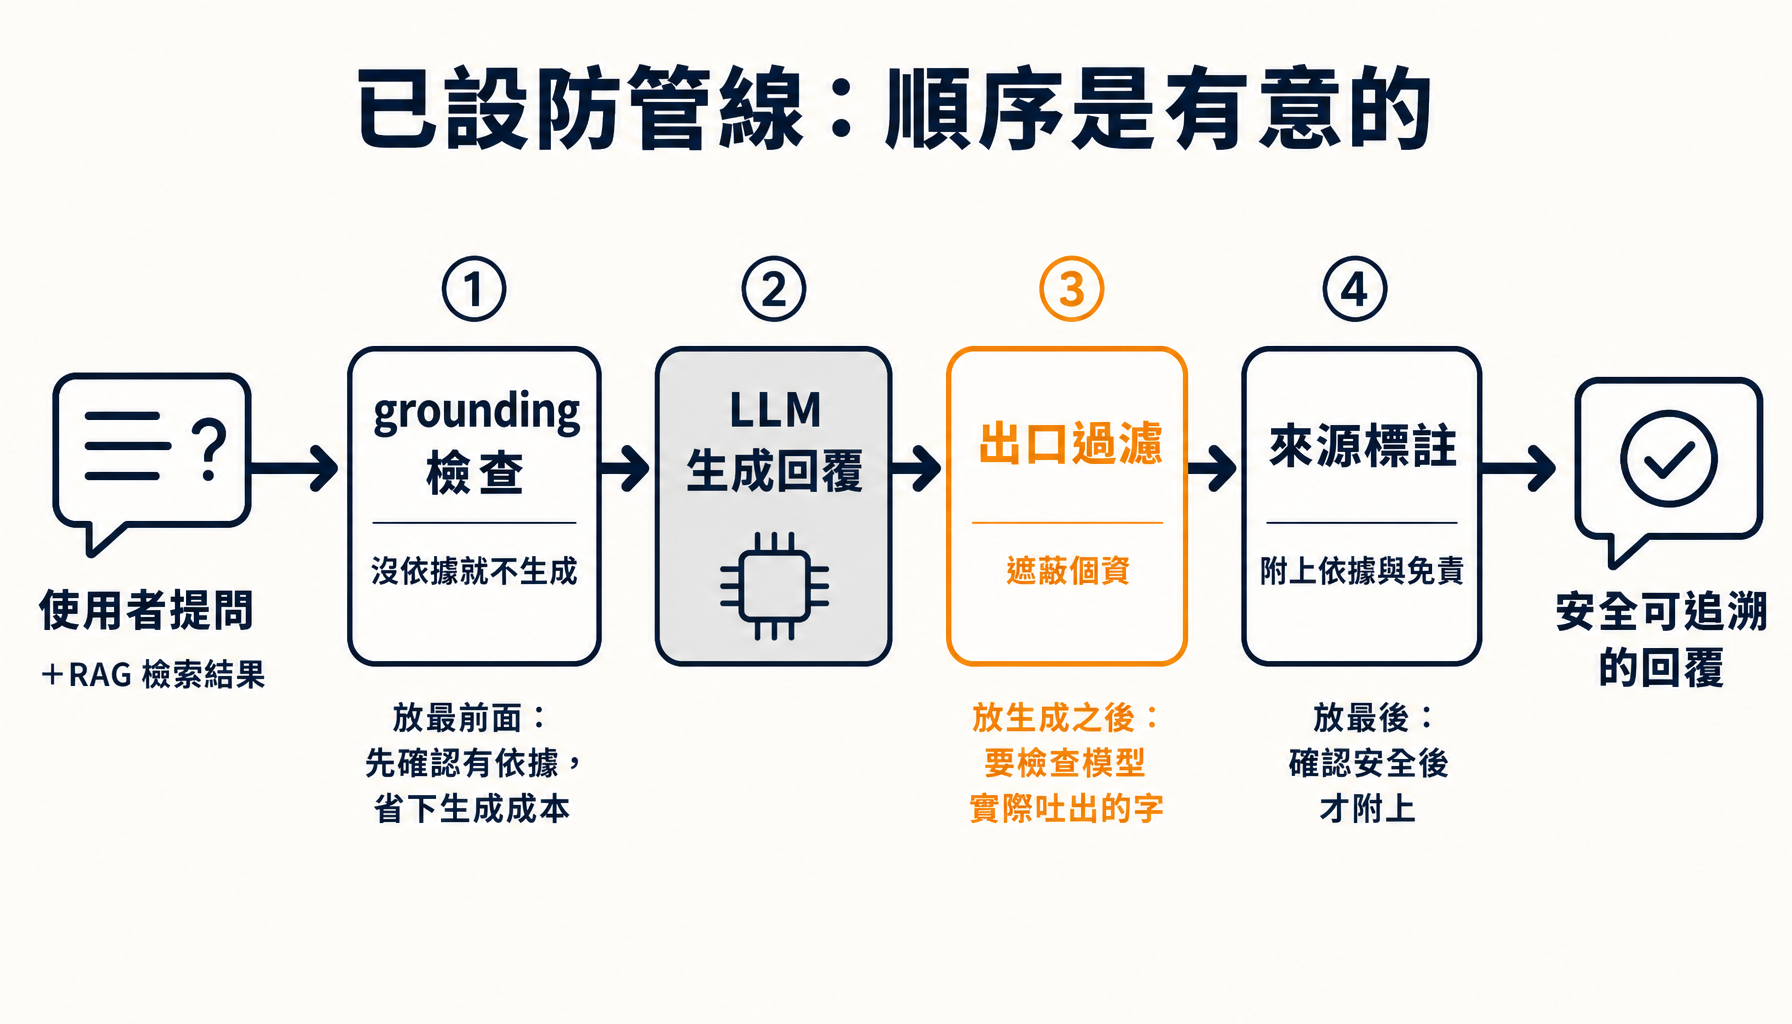
已設防的生成流程,就是把這三道依序組起來:先 grounding 檢查(沒依據就不生成),生成後出口過濾(遮蔽個資),最後附上來源與免責。
def answer_guarded(question: str, hits: list[tuple]) -> str:
    """已設防:先做 grounding 檢查,再生成,最後出口過濾+來源標註。"""
    # 防禦 ②:grounding 檢查——查無足夠依據就不硬答
    if not is_grounded(hits):
        print(f"    ⚠️ 輸出層:最高相似度 {hits[0][1]:.2f} < 門檻 {GROUNDING_THRESHOLD},判定查無足夠依據。")
        return ("關於您的問題,本院知識庫中查無足夠的對應資料,為避免提供不準確的資訊,"
                "建議您直接聯繫本院服務台由專人為您服務。")
    reply = _generate_raw(question, [c for c, _ in hits])
    # 防禦 ①:出口敏感內容過濾
    reply, redacted = redact_pii(reply)
    if redacted:
        print("    🚨 輸出層:回覆中偵測到個資格式,已於出口遮蔽(資料層兜底)。")
    # 防禦 ③:來源標註 + 免責提示
    return attach_sources(reply, hits)
_generate_raw() 則是實際呼叫模型的地方,沿用 Day 21 的做法——把檢索段落連同來源標記拼進提示,交給模型:
SYSTEM_PROMPT = """你是「仁心醫院」的 AI 客服「仁心小助手」。
請「只依據」以下提供的參考資料回答使用者的問題,簡潔有禮地回覆。
務必使用臺灣慣用的繁體中文,不得出現任何簡體字。
若參考資料中找不到答案,請誠實說「這部分建議您直接聯繫本院服務台」,不要自行編造。"""


def _generate_raw(question: str, contexts: list[dict]) -> str:
    """呼叫模型生成原始回覆(尚未經過輸出層處理)。"""
    reference = "\n\n".join(
        f"【參考資料 {i + 1}|來源:{c['source']}】\n{c['text']}"
        for i, c in enumerate(contexts)
    )
    user_prompt = f"{reference}\n\n──────────\n使用者問題:{question}"
    resp = ollama.chat(
        model=CHAT_MODEL,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": user_prompt},
        ],
        think=False,
        options={"temperature": 0.3},
    )
    return resp["message"]["content"].strip()
注意提示裡把來源檔名一併寫進了參考資料的標頭(|來源:{c['source']}),這是為了讓模型在回答時「看得到」自己依據的是哪份文件。整個流程的順序是有意的:grounding 檢查放最前面(省下沒必要的生成)、出口過濾放生成之後(因為要檢查的是模型「實際吐出來」的字)、來源標註放最後(在確定內容安全後才附上)。
對照組是「未設防」版——它就是 Day 21 的原始做法:模型生成什麼就直接回什麼,沒有任何出口把關。主程式則對三個情境,分別跑未設防與已設防兩條路:
def answer_naive(question: str, hits: list[tuple]) -> str:
    """未設防:模型生成什麼就直接回什麼(重現 Day 21 的做法)。"""
    return _generate_raw(question, [c for c, _ in hits])


if __name__ == "__main__":
    chunks = load_and_chunk(KNOWLEDGE_DIR)
    matrix = embed([c["text"] for c in chunks])
    print(f"📚 知識庫共 {len(chunks)} 段,已建立向量索引。\n")

    # 情境一:正常問答——展示來源標註與可解釋
    demo("正常問答:來源標註讓答案可追溯",
         "門診時間是幾點到幾點?", chunks, matrix)

    # 情境二:幻覺防護——問知識庫查無的問題,不讓模型硬掰
    demo("幻覺防護:知識庫查無依據就不硬答",
         "請問貴院附設的停車場一小時收費多少錢?", chunks, matrix)

    # 情境三:出口兜底——資料層殘留個資,輸出層在出口遮蔽
    demo("出口兜底:殘留個資在出口被遮蔽",
         "家醫科的聯絡窗口是誰?電話幾號?", chunks, matrix)
最後是 demo(),負責檢索、分別呼叫兩條路、並排印出對照:
def demo(title: str, question: str, chunks, matrix) -> None:
    hits = retrieve(question, chunks, matrix, TOP_K)
    print("=" * 72)
    print(f"【{title}】")
    print(f"❓ 使用者問題:{question}")
    print("🔎 檢索到:", "、".join(f"{c['source']}({s:.2f})" for c, s in hits))
    print(f"🔴 未設防回覆:{answer_naive(question, hits)}")
    print("🟢 已設防:")
    print(f"    回覆:{answer_guarded(question, hits)}\n")
它印出的那一行相似度分數,在幻覺防護的情境裡特別關鍵——可以直接看出門檻是怎麼判的。已設防管線的三道關卡與它們的先後順序如下圖所示,三個情境的實際輸出則接在其後。
把程式跑起來(本機 Ollama、qwen3:8b、真實輸出),三個情境的對照如下圖所示,以下逐一檢視三道防禦各自如何作用:
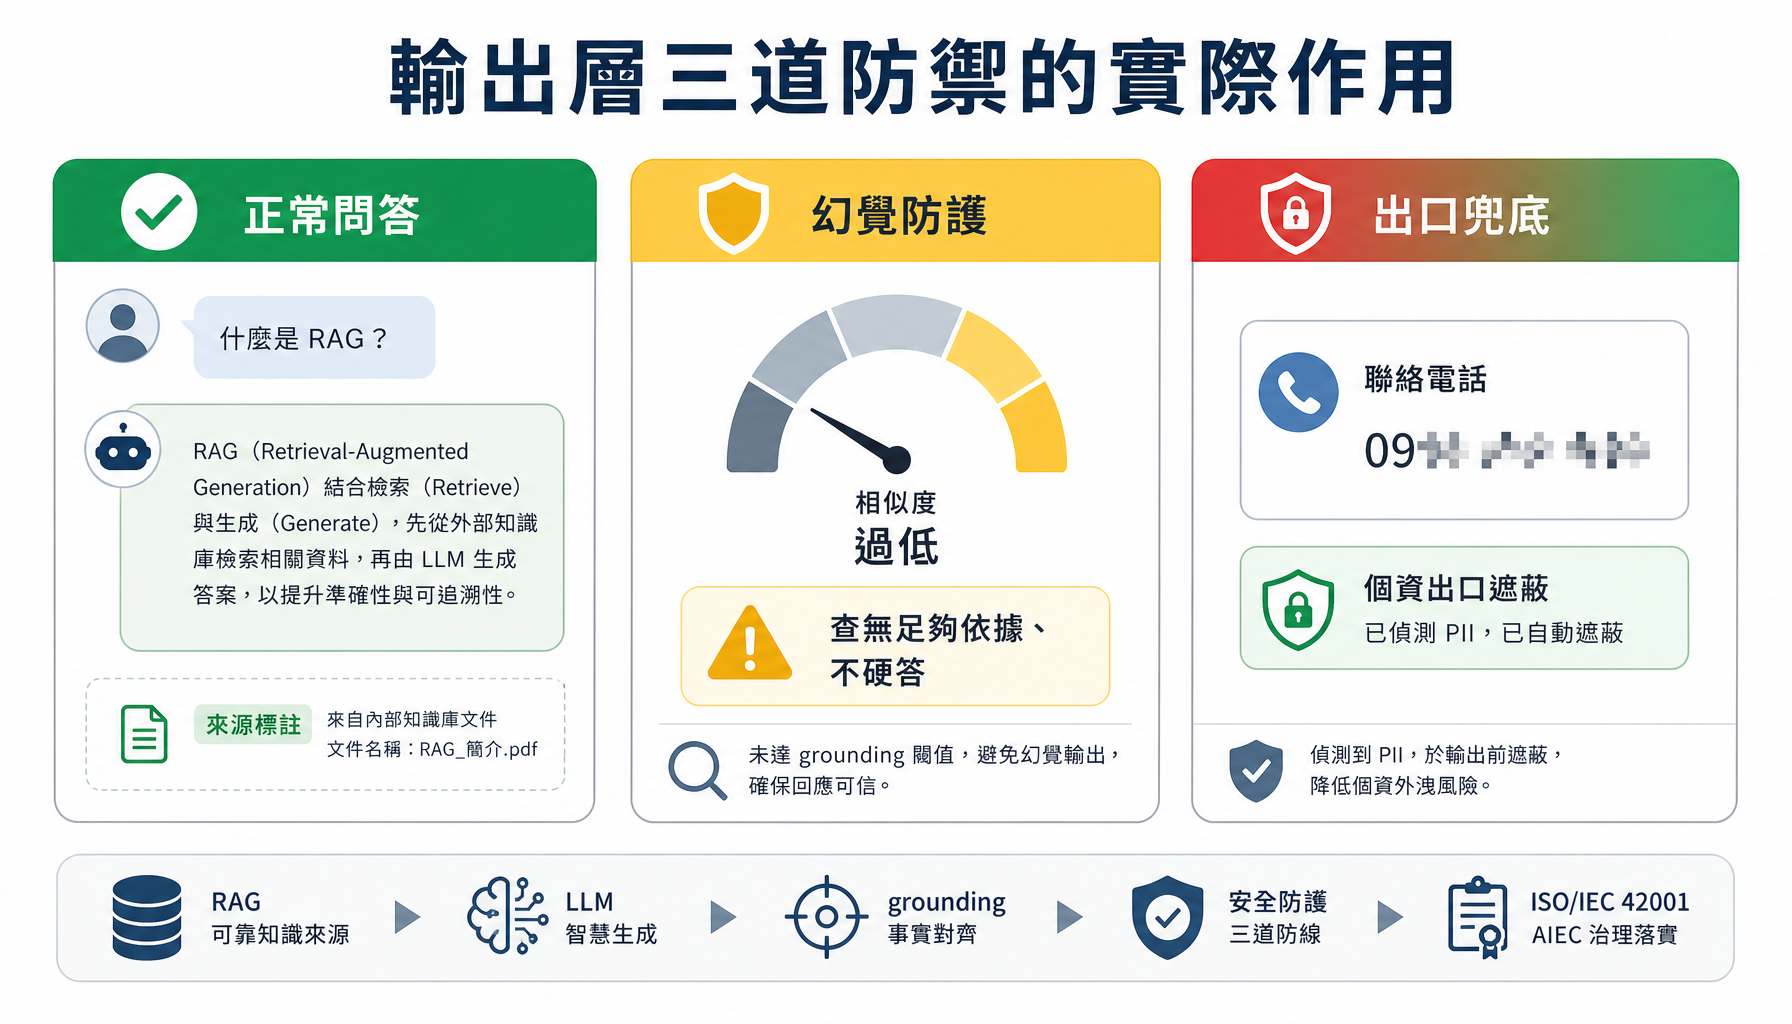
問一個知識庫答得出來的問題「門診時間是幾點到幾點?」:
🔴 未設防回覆:本院門診時間為:上午診 08:30–12:00、下午診 13:30–17:00、夜間診 18:00–21:00……
🟢 已設防回覆:本院門診時間為:上午診 08:30–12:00……
📎 依據來源:hospital_faq.md
(本回覆由 AI 客服依知識庫生成,僅供參考,不能取代專業醫療判斷。)
答案內容一樣,但已設防版多了兩行:依據來源與免責提示。使用者一眼就知道這個答案是根據 hospital_faq.md 來的、而且它只是參考。這就是「可解釋」最樸素的落地——不需要什麼高深技術,把來源標出來,答案就從「一個黑盒子的斷言」變成「一個可查證的引用」。
問一個知識庫裡根本沒有的問題「貴院附設的停車場一小時收費多少錢?」:
🔴 未設防回覆:這部分建議您直接聯繫本院服務台。
🟢 已設防:
⚠️ 輸出層:最高相似度 0.45 < 門檻 0.5,判定查無足夠依據。
回覆:關於您的問題,本院知識庫中查無足夠的對應資料,為避免提供不準確的資訊,建議您直接聯繫本院服務台由專人為您服務。
這裡要誠實說明:這次未設防版也婉拒了——因為 qwen3:8b 對齊得好、加上 RAG 系統提示要求「找不到別編」,模型自己選擇了誠實。但這正是重點所在:未設防版的「守住」,是靠運氣(模型剛好願意誠實);已設防版的「守住」,是靠機制(相似度 0.45 低於門檻,確定性地攔下)。 換一個對齊較弱的模型、或把溫度調高,未設防版隨時可能開始掰一個假的停車費率;而 grounding 檢查不管模型想不想掰,只要沒依據就先擋。把安全建在機制上,而不是模型的善意上——這是貫穿本系列的核心紀律。
這個情境刻意讓前面的防線「失守」:我們在知識庫裡放了一份 internal_note.md,裡面殘留了一筆沒有被 Day 22 治理掉的假個資(家醫科窗口的姓名與電話,檔頭已標註為教學用途)。這模擬「資料層漏了一筆」的真實情況。使用者問「家醫科的聯絡窗口是誰?電話幾號?」:
🔴 未設防回覆:家醫科的聯絡窗口是李美華護理師,電話為 0912-345-678。
🟢 已設防:
🚨 輸出層:回覆中偵測到個資格式,已於出口遮蔽(資料層兜底)。
回覆:家醫科的聯絡窗口是李美華護理師,電話為 [已遮蔽電話]。
📎 依據來源:internal_note.md……
未設防版忠實地把殘留的電話號碼洩漏了出去——這不是模型的錯,是資料層漏了、模型只是照實回答。而已設防版在出口偵測到符合電話格式的字串,在送出的最後一刻把它遮蔽掉。這就是縱深防禦最具體的畫面:前面的防線破了一個洞,最後一道關卡把它補上。 這也是為什麼「多此一舉」的輸出層,其實一點都不多餘。
Day 23 做過一組對照:把我們手寫的注入樣式庫,和 LLM Guard(Protect AI 釋出的開源 LLM 防護工具包,MIT 授權)內建的分類模型擺在一起比,結果手寫規則輸了三題。既然如此,出口這道 redact_pii() 是不是也該換成現成的工具?
這個問題值得認真做一次,因為答案和 Day 23 恰好相反。(前面三個情境示範的是「怎麼做」,這一節要回答的是「有沒有必要自己做」。)
LLM Guard 的輸出端有一個 Sensitive 掃描器,功能正好對應 redact_pii():掃描回覆裡的個資並遮蔽。它底層用的是 Microsoft Presidio——微軟開源的個資偵測與去識別化工具,做法是「命名實體辨識(Named Entity Recognition,以下簡稱 NER,見 Day 22)+規則比對」雙軌並行:NER 用模型判斷「這串字是人名還是地名」,規則則負責有固定格式的編號。它是這個領域最通用的開源方案之一。對照程式在 程式碼/Day24/compare_with_llm_guard.py,同樣匯入本篇這支程式裡的 redact_pii(),確保比的是同一套規則:
import sys

from output_guard_rag import redact_pii

try:
    from llm_guard.output_scanners import Sensitive
except ImportError:
    sys.exit("需要 llm-guard,請先在 Python 3.11/3.12 環境執行 pip install llm-guard")


# 每個案例標出「這句話裡有哪些個資該被遮掉」,作為對答案的依據。
CASES = [
    ("中文·姓名與電話",
     "王大明先生您好,您的聯絡電話 0912-345-678 已登記完成。",
     "王大明、0912-345-678"),
    ("中文·身分證與病歷號",
     "病患身分證 A123456789,病歷號 H0000001。",
     "A123456789、H0000001"),
    ("英文·姓名與電話",
     "Hello Mr. John Smith, your phone number 415-555-0123 is registered.",
     "John Smith、415-555-0123"),
]
三個案例分別測三種東西:中文姓名與台灣手機、台灣的國民身分證統一編號與本院病歷號、以及英文姓名與美式電話。第三個案例是刻意放的對照組——它讓我們看得出差異究竟來自「工具不好」還是「語言與地區不同」。
def main() -> None:
    scanner = Sensitive(
        entity_types=["PERSON", "PHONE_NUMBER", "EMAIL_ADDRESS", "US_SSN"],
        redact=True,
    )

    for name, text, expected in CASES:
        ours, _ = redact_pii(text)
        theirs, _, _ = scanner.scan("", text)
        print("=" * 72)
        print(f"【{name}】應遮蔽:{expected}")
        print(f"  原文     :{text}")
        print(f"  手寫規則   :{ours}")
        print(f"  LLM Guard   :{theirs}")
        print()


if __name__ == "__main__":
    main()
scanner.scan("", text) 的第一個參數是原始提問(輸出掃描器可以參考提問來判斷),這裡用不到就傳空字串。entity_types 指定要找哪幾類實體——清單裡有 US_SSN(美國社會安全碼),但沒有任何一項對應中華民國國民身分證統一編號,這個細節等一下會成為關鍵。
【中文·姓名與電話】應遮蔽:王大明、0912-345-678
  原文     :王大明先生您好,您的聯絡電話 0912-345-678 已登記完成。
  手寫規則   :王大明先生您好,您的聯絡電話 [已遮蔽電話] 已登記完成。
  LLM Guard   :<PERSON><PERSON>明先生您好,您的聯絡電話 <PHONE_NUMBER><PHONE_NUMBER> 已登記完成。

【中文·身分證與病歷號】應遮蔽:A123456789、H0000001
  原文     :病患身分證 A123456789,病歷號 H0000001。
  手寫規則   :病患身分證 [已遮蔽身分證],病歷號 [已遮蔽病歷號]。
  LLM Guard   :病患身分證 A123456789,病歷號 H0000001。

【英文·姓名與電話】應遮蔽:John Smith、415-555-0123
  原文     :Hello Mr. John Smith, your phone number 415-555-0123 is registered.
  手寫規則   :Hello Mr. John Smith, your phone number 415-555-0123 is registered.
  LLM Guard   :Hello Mr. <PERSON> <PERSON>, your phone number <PHONE_NUMBER> is registered.
三個案例,三種不同的結果。
第二題是最關鍵的一題。 身分證統一編號 A123456789 和病歷號 H0000001 都在 LLM Guard 眼前原封不動地通過了。原因不難理解:Presidio 的實體清單裡有美國社會安全碼、有英國國民保險號碼,但沒有中華民國的國民身分證統一編號;至於「本院病歷號是 H 開頭加七碼」這種只有這家醫院才知道的格式,任何通用工具都不可能內建。而我們那三條手寫規則,正是為這些格式量身寫的,全部命中。
第一題兩邊都不完美。 手寫規則遮掉了電話,但完全沒動「王大明」——因為 _PII_RULES 裡根本沒有姓名這一條。LLM Guard 兩樣都抓到了,但姓名遮偏了:「王大明」被切成 <PERSON><PERSON>明,只遮掉「王大」,留下一個「明」字——等於漏了一個字。電話則被標成兩個 <PHONE_NUMBER>,整串號碼都遮住了、沒有外洩,但標籤重複顯示它同樣沒把號碼看成一個完整單位。中文的詞與詞之間沒有空格,模型得自行判斷實體從哪裡開始、到哪裡結束;這種實體邊界的碎裂,是通用的命名實體辨識模型處理中文時常見的失準——邊界一抓偏,遮蔽就跟著錯位。
第三題則完全倒過來。 英文姓名與美式電話,LLM Guard 乾淨俐落,我們的規則一個字都沒遮到——因為那三條規則從頭到尾只認得台灣的格式。
把三個案例的結果並排,覆蓋範圍的差異一目了然:
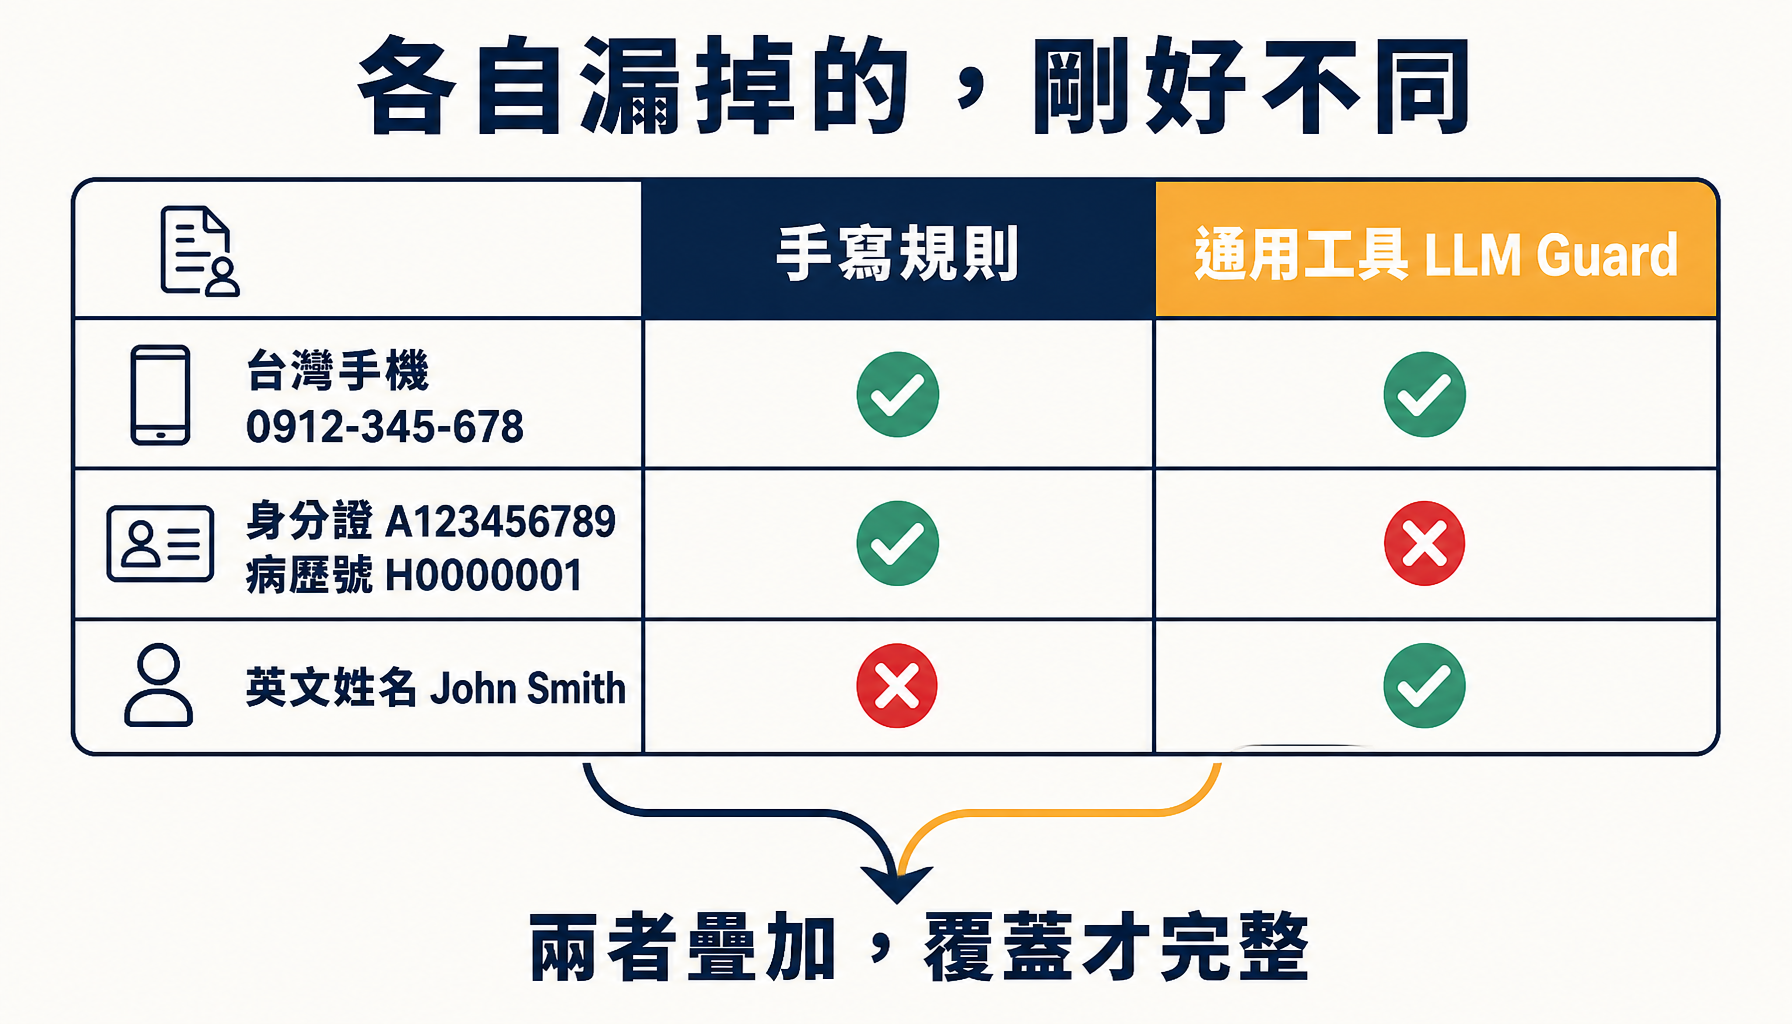
把 Day 23 和今天這兩組對照放在一起看,會得到一個比「用工具比較好」更有用的結論:
| 對照面向 | 通用工具強在哪 | 手寫規則強在哪 |
|---|---|---|
| 注入偵測(Day 23) | 語意層面的變形:換句話說、拆字夾帶 | 照本宣科的攻擊字串,且快、可解釋、隨時改 |
| 個資遮蔽(今天) | 人名等沒有固定格式的實體、英文語境 | 在地與機構自訂格式:身分證、病歷號 |
通用工具擋得住通用的威脅,擋不住在地的格式。 提示注入的話術在各種語言裡結構相近,所以訓練過的模型遷移得過來;但「中華民國國民身分證統一編號長什麼樣」「這家醫院的病歷號怎麼編」是純粹的地域與機構知識,不會出現在任何通用模型的訓練目標裡。
所以出口這一關的正確做法,不是把 redact_pii() 換成 Sensitive,而是兩個都掛上去:通用工具負責人名這類抓不到格式的實體,手寫規則負責在地與機構自訂的編號。兩者的漏洞剛好不重疊,疊起來的覆蓋率遠高於任何一邊單獨使用——這正是縱深防禦在同一層之內的樣子。
這也回頭說明了 Day 22 的一件事:那份 deidentify() 之所以要自己寫,不是因為沒有現成工具可用,而是因為它要遮的東西,現成工具剛好不認得。
把今天的輸出層防禦,接回貫穿本系列的對映總表(Day 21)。下圖呈現這組對映:
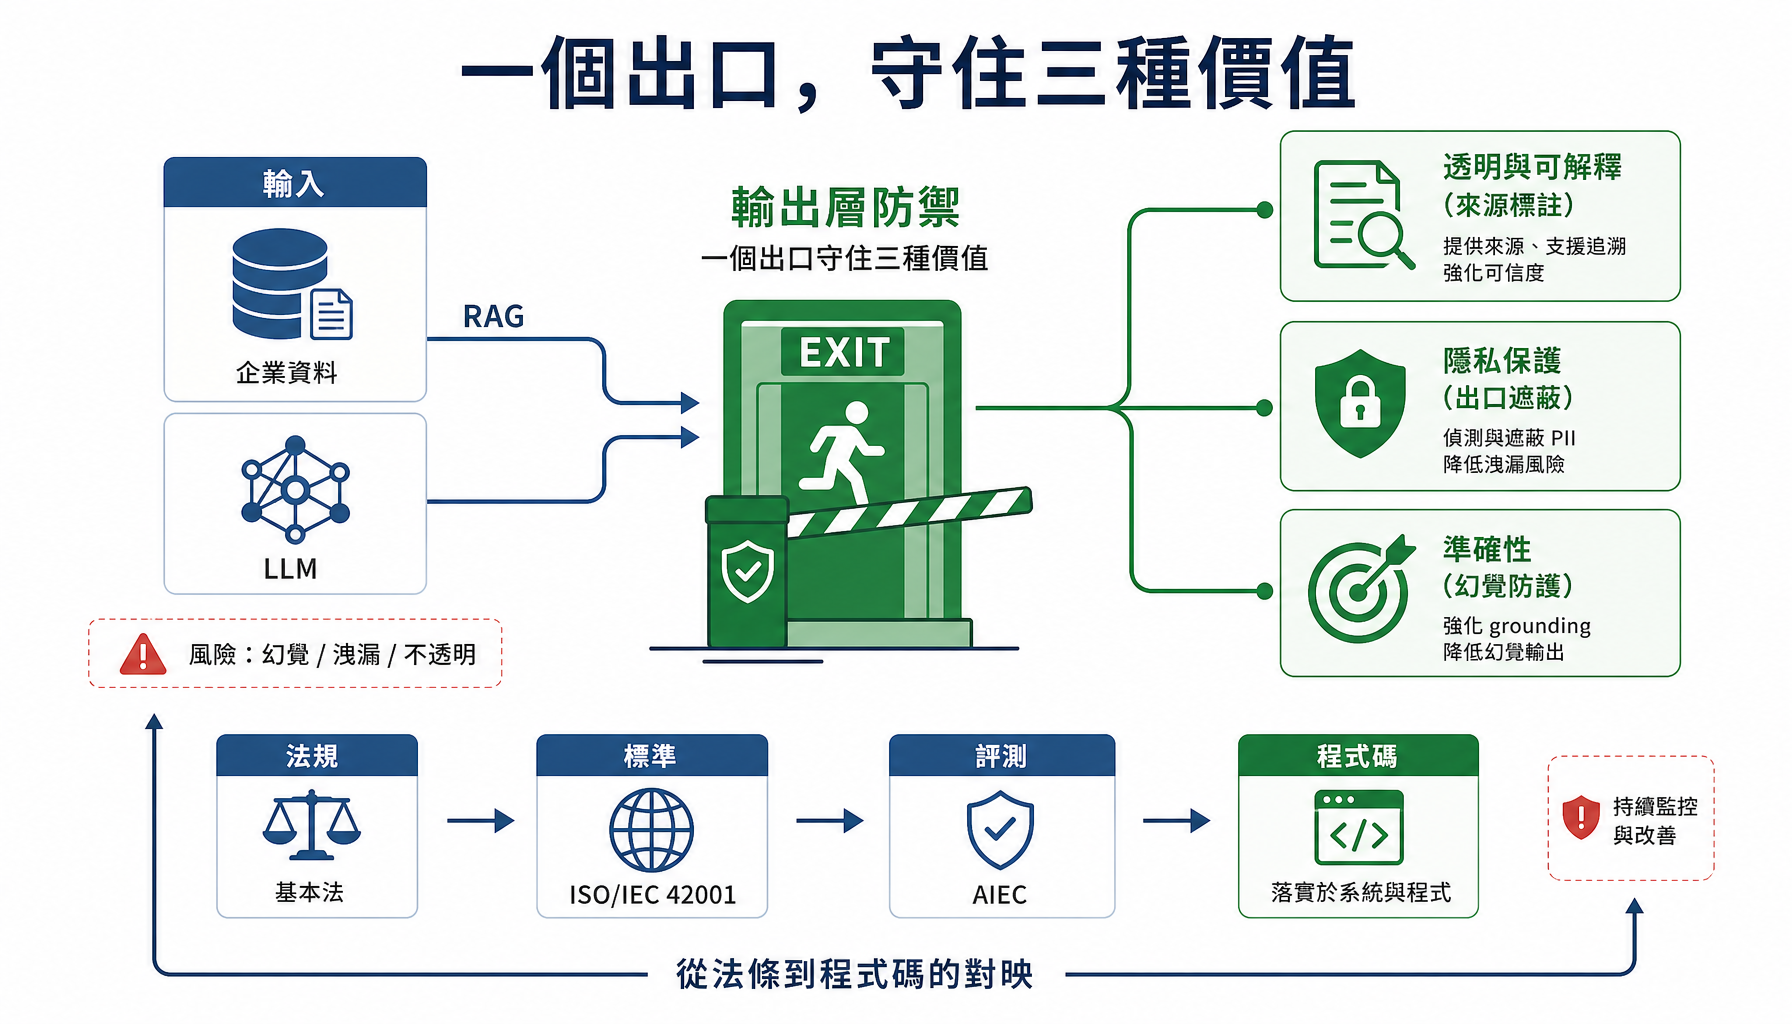
從這組對映可以看到一件事:輸出層同時回應了好幾條上位要求——來源標註對應基本法的「透明與可解釋」、出口過濾對應「隱私保護」、grounding 檢查對應「準確性」。一個出口,守住三種價值。 而這些「已設防」的實跑結果,將來就是送 AI 產品與系統評測中心(Artificial Intelligence Evaluation Center,以下簡稱 AIEC,見 Day 18)的「透明性」「可解釋性」「準確性」評測時,拿得出手的技術證據。
今天這三道防禦,各有各管不到的地方:
所以輸出層和輸入層一樣,是縱深防禦的一環,不是終點。它的價值在於「多一道獨立的關卡」,而不是「一道就能全包」。真正的安全,永遠來自多層獨立防線的疊加,加上下一階段會談的存取控制與持續的紅隊測試。
今天守住了 RAG 的第三層——輸出層:
redact_pii,遮蔽個資,與資料層一入一出呼應)、幻覺防護(is_grounded,用相似度門檻確定性地擋住「沒依據硬答」)、來源標註(attach_sources,讓答案可追溯、附免責提示對抗過度依賴);Sensitive 掃描器對照,通用工具抓得到人名與英文語境的個資,卻讓中華民國身分證統一編號與本院病歷號原封不動通過,中文姓名還會因實體邊界抓偏而遮漏一個字。結論不是二選一,而是兩者疊起來——通用工具補沒有格式的實體,手寫規則補在地與機構自訂的編號;明天(Day 25)進入第四層——存取控制與最小權限。 前三層都在處理「內容」——資料乾不乾淨、輸入安不安全、輸出該不該送。但還有一個更根本的問題:這個使用者,到底有沒有資格看到這筆資料? 我們會替客服補上身分與權限的把關,處理「最小權限」與「租戶隔離」——這是把「該保護的資料,連碰都碰不到」做到底的一層。
程式碼/Day24/output_guard_rag.py(輸出層防禦 RAG)、程式碼/Day24/compare_with_llm_guard.py(手寫規則與 LLM Guard 的對照)與 程式碼/Day24/knowledge/(知識庫)。其中 internal_note.md 為 LLM 生成之虛構備註,「刻意」殘留一筆未治理的假個資(假姓名、格式正確但杜撰的假電話),以示範輸出層對「資料層失守」的兜底遮蔽,檔頭已明確標註,正式系統知識庫不應含此類內容;其餘假資料沿用 Day 21/23。實作用本機 Ollama(qwen3:8b 生成、embeddinggemma 向量化),結果為真實執行輸出;因大型語言模型具非確定性,重現時回覆文字可能與本文節錄略有不同。(說明:本系列各日的虛構假資料為各自獨立生成,人物設定不跨日延續,請勿跨篇對照。)Sensitive 輸出掃描器底層為 Microsoft Presidio;文中三組對照為 python compare_with_llm_guard.py 的本機實際執行輸出,讀者可自行重現。環境提醒:LLM Guard 相依之 spaCy 截至撰稿時尚無 Python 3.14 對應輪檔,請改用 Python 3.11 或 3.12;首次執行會自動下載具名實體辨識模型(約 700 MB)與中英文 spaCy 語言模型。該對照僅三個案例,用於說明通用工具與在地規則的覆蓋差異,不足以作為任何工具之效能評比;Sensitive 的偵測範圍亦可透過自訂辨識器擴充;本文使用的是其內建實體類別中的四項,未加掛任何自訂辨識器。即使改採其完整的預設清單(十三項),其中同樣沒有對應中華民國國民身分證統一編號的類別,第二題的結果不會改變。

 iThome鐵人賽
 看影片追技術