
今天再深入地把 Karpathy 那套 LLM wiki 的架構走一遍。
他把一座知識庫拆成三層:raw/ 放來源(raw sources)、wiki/ 放 AI 整理出來的頁面(the wiki)、schema/ 放規則(the schema)。三層之上有三個操作:編纂(Ingest)、對話(Query)、健檢(Lint)。
這六條準則之前我們已經一條一條定義過了,今天講的是另一件事——它們為什麼長成這樣,以及每一條背後有哪個非做不可的決定。
這一層放你丟進來的東西:網址抓下來的內文、PDF 抽出來的文字、自己貼上的一段筆記。規則只有一條:存進去之後就不再改。
These are immutable — the LLM reads from them but never modifies them. This is your source of truth.
為什麼?因為它是所有結論的憑據。wiki/ 裡的每一句話,理論上都應該追得回某一份來源。三個月後你看到一個結論,想確認它到底是資料裡寫的、還是 AI 自己想出來的,能查的就只有這一層。這一層要是可以被改寫,那條追溯鏈就斷了。
raw/ 不能刪,只能封存。封存只是把檔案搬到 raw/archive/ 底下,筆記 ID 不變、版本歷史不變、所有連結還連得到,差別只在它不再出現在待編纂清單裡。後悔了也搬得回來。
跟 raw/ 剛好相反,這裡是 agent 的工作區,可以隨時改寫、合併、重組。
You read it; the LLM writes it.
至於要切成哪些子資料夾,Karpathy 只列了幾種頁面類型(summaries、entity pages、concept pages、comparisons、an overview、a synthesis),怎麼分是實作自己的事。我用的是這一套:
wiki/
  sources/     一份來源對一頁,摘出重點並連回 raw/
  concepts/    跨來源的概念,通常被多篇引用
  entities/    人、組織、產品
  arguments/   有爭議的主張,正反兩面都記
  queries/     問答存檔
  index.md     整座知識庫的地圖
  log.md       變更紀錄
比資料夾更重要的是頁跟頁之間的連結。在頁面內文裡寫兩個方括號就是一條連結:
這個主張的來源見 [[mensh2017ten]],相關概念是 [[paper-structure]]。
這是 Obsidian 的慣例,Karpathy 的定義裡也把它當成這一層的本質——他說的不是「一堆 Markdown 檔」,是有結構、互相連結的一批 Markdown:
the LLM incrementally builds and maintains a persistent wiki — a structured, interlinked collection of markdown files that sits between you and the raw sources
關鍵在於連結是內文的一部分,不是額外的欄位。agent 寫頁面的時候順手就把關係建好了,沒有第二個地方要維護,也不會出現「內容更新了但關係表沒跟上」的狀況。
而這批連結之後會長成三個東西,全部不需要使用者額外做任何事:
待編纂的判斷依據:沒有任何 wiki/ 頁連回某份來源,那份來源就是還沒消化。下一節細講。
反向連結:打開一頁就看得到「有誰引用了我」,這是讀的時候最有用的一欄。
知識圖譜:把所有連結攤開就是整座知識庫的形狀。Karpathy 自己也是這樣看的——
Obsidian's graph view is the best way to see the shape of your wiki — what's connected to what, which pages are hubs, which are orphans.
哪些頁是樞紐、哪些是沒人理的孤兒,圖上一眼就看得出來。孤兒頁也正好是健檢要抓的東西之一。
同一批 [[…]],三種用途。之後會有一整篇講它們怎麼從內文變成資料庫裡的一行。
index.md 和 log.md 是兩個特殊頁,Karpathy 專門開了一節講它們。
index.md 是地圖,agent 每次編纂完都要更新。一頁一行:連結、一句話說明,需要的話再帶上日期或來源數,然後照類別分組:
# 索引

## 概念
- [[paper-structure]] — 一篇論文的骨架該怎麼搭 · 2 份來源

## 來源
- [[mensh2017ten]] — Mensh & Kording (2017),十條論文寫作規則 · 2026-09-04

## 人物
- [[konrad-kording]] — 神經科學家,上面那篇的共同作者
log.md 則是流水帳,格式固定:
## [2026-09-04] ingest | 標題

做了什麼、建了哪些頁、改了哪些頁。
固定前綴的理由很實際:
if each entry starts with a consistent prefix (e.g.
## [2026-04-02] ingest | Article Title), the log becomes parseable with simple unix tools —grep "^## \[" log.md | tail -5gives you the last 5 entries.
為什麼要有 log?一是這座知識庫會被 AI 持續改寫,你需要一條時間軸,才知道它是怎麼長成現在這個樣子的。二是下一次 agent 進來的時候,讀 log 比讀整座 wiki 便宜太多。
index.md 打的是同一副算盤:agent 要回答問題時先讀 index,再鑽進相關的頁面。Karpathy 說這招在百來份來源、幾百頁的規模下意外地夠用,而且省掉整套向量基礎設施。
This works surprisingly well at moderate scale (~100 sources, ~hundreds of pages) and avoids the need for embedding-based RAG infrastructure.
這就是為什麼這座知識庫從頭到尾沒有向量資料庫。
我們再看一次系統架構圖: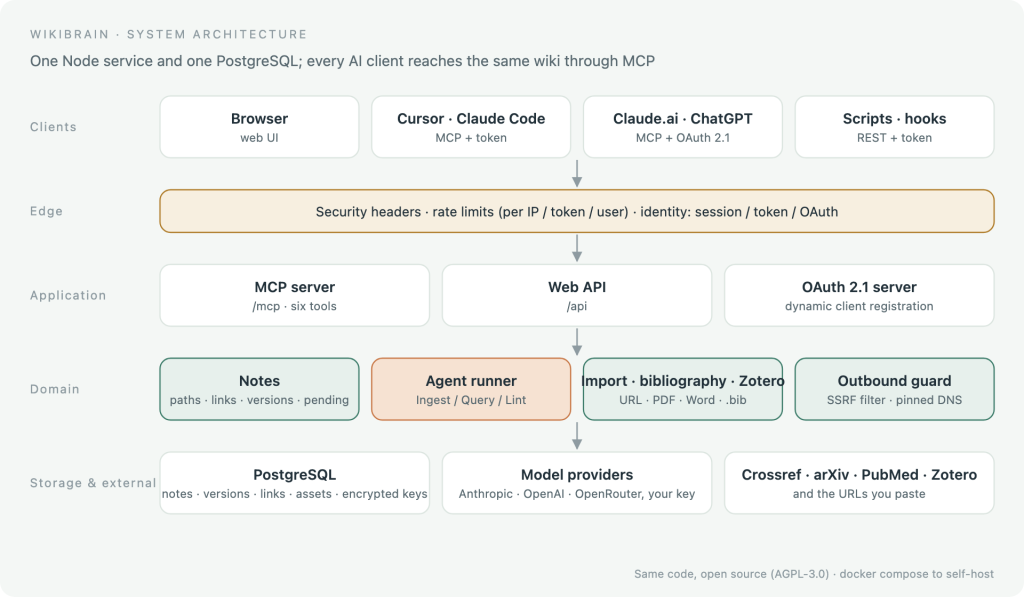
三層知識庫在最底下,上面是共用同一份資料存取的兩條入口:網頁與 MCP。
這一層是我覺得整個模式最聰明的地方。Karpathy 說有沒有這一層,決定了 AI 是一個守規矩的維護者、還是一個普通的聊天機器人。
This is the key configuration file — it's what makes the LLM a disciplined wiki maintainer rather than a generic chatbot.
一般的做法是把規則塞進系統提示詞:術語要統一、什麼時候該開新頁、引用要怎麼寫。問題是使用者改不到。而且每個人的知識庫,規則本來就不該一樣——研究者的知識庫,跟拿來管專案的知識庫,那是兩回事。
把規則放進 schema/ 之後,它就變成知識庫裡的一頁普通筆記。使用者自己就能改,改完下一次 agent 進來就照新的做。不用重新部署,也不用來找我。他也把這一層當成會跟著長大的東西。
You and the LLM co-evolve this over time as you figure out what works for your domain.
系統這邊只做一件事:讓 agent 動筆之前先讀這一層。MCP 的第一個工具就叫 get_instructions,它的描述裡直接寫著「動筆前先呼叫本工具」。
這個概念 Karpathy 沒提——他只在健檢那一節要求找出沒有任何頁面連進來的孤兒頁(orphan pages with no inbound links),我把同一個想法反過來套在來源上。
一份來源是不是待編纂,不靠任何狀態欄位,而是可以查出來的:
raw/底下的來源,沒有任何wiki/頁面連回它,就是待編纂。
好處是它永遠不會跟現實脫節。你手動刪掉一頁 wiki,對應的來源自動變回待編纂;你自己寫一頁連回去,它自動變成已編纂。沒有要維護的旗標,也就沒有旗標跟事實對不起來的那一天。
get_instructions 除了回傳規則,也會順便列出目前待編纂的來源。所以 agent 一進來就知道有哪些事該做,不用你開口。
三層是靜態的,真正讓這座知識庫動起來的是三個操作。它們各自都有一個做錯就會毀掉整個模式的地方。
編纂(Ingest):它不是摘要。
最容易犯的錯是把編纂做成「幫這份資料寫一篇摘要」。那樣的話一份來源進來就長一頁,十份就是十頁各自獨立的摘要,跟你的下載資料夾沒有本質差別。
Karpathy 給的規模是一個很好的檢查點:
A single source might touch 10-15 wiki pages.
一份來源動到十到十五頁——這個數字說明編纂的動作是把新內容散佈到整座知識庫該更新的每一個角落,而不是在旁邊新增一份摘要。它會去改既有的概念頁、補上交叉引用、更新目錄、在有衝突的地方標記出來。
這也是為什麼匯入和編纂一定要分成兩個詞。匯入只是把檔案搬進 raw/,系統對內容一無所知;編纂才是消化。把它們混成一個動作,使用者就會以為東西丟進去就等於整理好了。
對話(Query):答案不能只活在聊天視窗裡。
一般的問答做完就結束,你得到答案,對話關掉,那個理解就消失了。這正是第一篇批評 RAG 的同一個毛病,只是換了一個地方發生。
所以 Karpathy 把這件事寫進操作的定義裡:
good answers can be filed back into the wiki as new pages.
一個有價值的回答——一份比較、一個你剛發現的關聯——應該變成知識庫裡的一頁,然後下一次查詢讀得到它。問答本身也是知識。
配套的要求是答案一定要附出處。沒有出處的答案沒辦法被驗證,而一頁沒辦法被驗證的內容存回知識庫,只會污染後面所有的查詢。
健檢(Lint):它的產出是問題,不是修好。
健檢是三個裡面最容易被忽略的一個,因為它不產生新內容。但一座持續長大的知識庫一定會累積毛病:互相矛盾的說法、被新資料推翻的舊主張、沒有人連到的孤兒頁、該有卻缺的交叉引用。
Karpathy 列完那串清單之後補了一句,我認為那才是健檢真正的價值:
The LLM is good at suggesting new questions to investigate and new sources to look for.
健檢跑完給你的不只是一份錯誤清單,是一份「你接下來該讀什麼」的清單。它把維護變成一個會指出下一步的動作,而不是一件掃地的雜事。
至於哪些問題該由程式算、哪些該交給模型判斷,那是實作層的決定,之後會講。
三個資料夾,三種待遇:raw/ 是憑據,所以不能改也不能刪;wiki/ 是成果,所以隨便 AI 改;schema/ 是規則,所以交給使用者自己控制,而且 AI 動筆前一定會先讀。
這樣切完,你拿到的東西跟「把一堆檔案丟給 AI 問問題」差很多:每一句結論都追得回那份不會被改的原件;交叉引用、目錄、變更紀錄這些繁瑣的維護工作,都透過 agent,根據 schema/ 的規則自行維護。我們只要專注探索知識庫本身就好。
三個操作則各自守著一件事:編纂要散佈到整座知識庫而不是新增一份摘要、對話的答案要能存回去變成新的一頁、健檢要指出下一步該讀什麼。六條準則到這裡都還只是規格,接下來要看它們變成程式碼之後長什麼樣。


 iThome鐵人賽
 看影片追技術