
匯入引擎是整個專案裡最髒的一塊:沒有什麼漂亮的架構,全是一個一個網站踩出來的規則。
但它也是使用者最有感的一塊。貼一個網址進去,出來一份乾淨的 Markdown 加完整書目,這件事做得好不好,決定他們會不會繼續用。
抓一個網址有兩條路。第一條是抓 HTML 直接抽正文,快、便宜,對八成的網站有效;第二條是開一台真的瀏覽器等它跑完,慢、貴,但剩下那兩成只有它有辦法。
抓網頁 → 抽正文 → 轉 Markdown → 抽書目 → 決定檔名 → 存進 raw/
抽正文用 Readability,就是 Firefox 閱讀模式背後那套;轉 Markdown 用 Turndown 加 GFM 外掛(表格、刪除線、任務清單)。這兩個套件負責了八成的工作。
剩下兩成是地獄,而且從送出請求的那一刻就開始了:
export const FETCH_HEADERS = {
  'user-agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0 Safari/537.36 WikiBrain/0.1',
  'accept-language': 'zh-TW,zh-Hant;q=0.9,zh;q=0.8,en;q=0.7',
  accept: 'text/html,application/xhtml+xml,application/pdf;q=0.9,*/*;q=0.5',
};
那串 user-agent 要偽裝成瀏覽器,因為很多網站對非瀏覽器的 UA 直接回一份被閹割的頁面。accept-language 則決定維基百科給你簡體還是正體。
我拿二十個真實網址做了一輪實測,記成一份矩陣,每個網站一列。以下是幾個代表性的:
維基百科:抓回來是簡體,而且所有標題都不見了。簡體是 accept-language 沒送;標題不見是因為它包在 div.mw-heading 裡,Readability 看到被 div 包住的標題會整塊丟掉。
修法我沒有寫成「如果是維基百科就……」,而是一條通則:前處理時把只包著一個標題的 div 拆掉。這樣其他同樣寫法的網站一起受惠,也不必為每個站各留一段特例。標題後綴(「 - 維基百科,自由的百科全書」那種)則靠一份站名字典砍掉。
arXiv:摘要頁的 HTML 很難剖析,但它有 export API。直接改打 API,作者、年份、DOI、摘要一次到位。實測一篇論文抓到十二位作者。
PubMed:同樣改走 efetch API 拿 XML。
YouTube:正文是沒有意義的,只留描述欄。
新聞網站:作者跟日期通常在 JSON-LD 的 schema.org/Article 裡,比 meta 標籤可靠。但 headline 不能照單全收,有些站(維基百科就是)在那裡塞的是整段描述:
// Some sites (Wikipedia) put a long description in the JSON-LD headline; over 80 chars it is not used as the title
const ldHeadline = ld.headline && ld.headline.length <= 80 ? ld.headline : undefined;
需要登入的平台:Facebook 這類直接回一個明確的錯誤,告訴使用者複製內容用貼上文字的方式匯入。假裝能抓然後給一份垃圾,比誠實地拒絕更糟。
二十個網址裡十三個成功,三個依設計拒絕,四個是我自己給錯的無效網址。
如果頁面上有 citation meta 標籤或 DOI,就抽出來:
title: Ten simple rules for structuring papers
authors: [Brett Mensh, Konrad Kording]
year: 2017
venue: PLOS Computational Biology
doi: 10.1371/journal.pcbi.1005619
citation_key: mensh2017ten
拿到 DOI 之後再打一次 Crossref 補齊,因為網頁上的 meta 常常缺東西。
citation_key 也拿來當檔名,所以同一篇論文不管從哪裡抓進來,檔名都一樣,不會重複收藏。組成規則是第一作者的姓、年份,加上標題裡第一個三字以上的詞:
export function familyName(author: string): string {
  const a = author.trim();
  if (a.includes(',')) return a.split(',')[0].trim();      // 「Mensh, Brett」
  const parts = a.split(/\s+/);
  return parts.length > 1 ? parts[parts.length - 1] : a;   // 「Brett Mensh」
}
export function citationKey(meta: Partial<SourceMeta>): string | undefined {
  if (!meta.authors?.length || !meta.year) return undefined;
  const family = familyName(meta.authors[0]).toLowerCase().replace(/[^\p{L}\p{N}]/gu, '');
  const word = (meta.title ?? '').toLowerCase().match(/[\p{L}\p{N}]{3,}/u)?.[0] ?? '';
  return `${family}${meta.year}${word}`.slice(0, 60) || undefined;
}
那兩行 familyName 是踩出來的。作者名可能是「Mensh, Brett」也可能是「Brett Mensh」,我一開始只處理了前者,結果所有西方名字都拿到名而不是姓,用一個真實的華藝網址才測出來。
網頁裡的圖如果只存網址,過一陣子原站改版就全變成破圖。所以匯入時會把圖抓下來存進自己的附件表,內文的連結改寫成本地路徑。
限制寫在一個常數裡:
export const ASSET_LIMITS = { bytes: 5 * 1024 * 1024, perImport: 10, importBytes: 2 * 1024 * 1024 };
每次匯入最多十張、每張兩 MB(手動上傳的附件可以到五 MB)。抓失敗就保留原網址,而不是讓整個匯入失敗。匯出 zip 的時候附件也會一起打包,連結改成相對路徑,這樣解壓縮出來的資料夾直接可以丟進 Obsidian。
抓取最容易誤判的一件事是:HTTP 回 200 不代表你拿到了內容。很多站會回一頁 200 的機器人檢查頁,標題是「Just a moment...」或「請稍候」,內文是一段要你開啟 JavaScript 的說明。照單全收的話,使用者的 raw/ 裡就多一份內容是「請稍候」的來源。
所以抓完還要再判斷一次:
const CHALLENGE_TITLES = /^(client challenge|just a moment\.{0,3}|access denied|attention required!?|are you a robot\??|security check|verify you are human|403 forbidden|請稍候|請稍等|正在驗證)/i;
export const isChallengePage = (title: string, markdown: string) =>
  CHALLENGE_TITLES.test(title.trim()) ||
  /enable javascript and cookies to continue|checking your browser before accessing/i.test(markdown);
判斷條件是一份標題的黑名單加兩句內文特徵。這種清單注定不完整,會隨著遇到新的防護服務一直長,但它擋掉的是最糟的那種失敗:看起來成功了,錯誤要等三個月後你回頭查證據時才發現。
無頭瀏覽器很貴:一頁要兩秒多,記憶體吃掉兩百多 MB。所以它是 fallback,不是主要路徑。判斷就兩行:
const thin = !YT_RE.test(url.hostname) && (chars < LIMITS.minContentChars || (!r.article && chars < 3000));
if ((thin || challenge) && !hasBiblio && ctx.headlessOn) {
thin 是「抓回來的東西看起來不像一篇文章」:字數少於兩百,或者 Readability 認不出主體而且不到三千字。第二個條件要兩項同時成立。有些很長的頁面 Readability 判不出主體,但內容其實抓得很完整,沒必要為它開一台瀏覽器。YouTube 直接排除在外,因為它的正文本來就沒有意義。
challenge 就是前面那個 isChallengePage。機器人檢查頁也會升級到第二條路。第一條路拿到的是一頁「請稍候」,那正是最該讓真瀏覽器去跑一次的情況。前面說「誠實地拒絕」講的是需要登入的平台,機器人檢查則還有得救。
hasBiblio 是一道煞車:頁面已經有完整書目就不啟動。有 DOI 跟作者的論文頁,就算全文抓不到,書目本身已經有價值了。
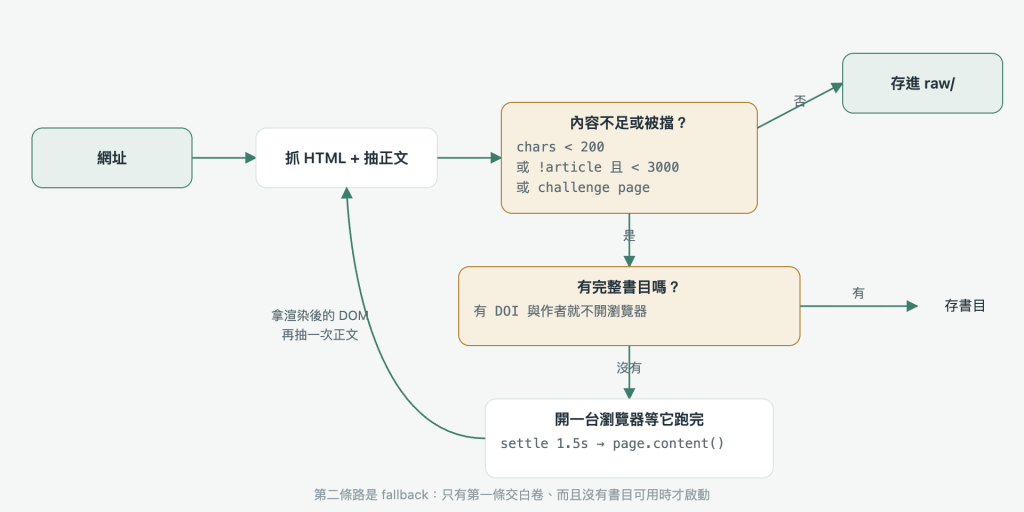
兩條路的分岔點。右上那條是八成的情況,往下走的每一步都在問「還有沒有更便宜的辦法」。
至於回應是 403 或 5xx,走的是更早的另一條路徑,那裡不看書目,連內容都沒拿到,沒有書目可言。
實測下來,這個 fallback 讓幾個原本完全抓不到的網站可以用了:某些技術媒體、線上課程平台、共筆工具、政府法規資料庫。
不是每次匯入都開一台新的瀏覽器,那樣光啟動就要好幾秒。改成共用一個實例,閒置六十秒之後自動關掉:
let browser: Browser | null = null;

async function getBrowser() {
  if (browser?.isConnected()) return browser;
  const { chromium } = await import('playwright-core');
  browser = await chromium.launch({ headless: true, timeout: 20_000, proxy: { server: 'per-context' } });
  return browser;
}

function touchIdle() {
  clearTimeout(idleTimer);
  idleTimer = setTimeout(() => { browser?.close().catch(() => {}); browser = null; }, 60_000);
}
那個 proxy: { server: 'per-context' } 是刻意的:瀏覽器本身不准直接連外,每個 context 各自走一條會驗目的地的代理。理由是瀏覽器會自己去載入網頁裡的所有子資源(圖片、CSS、字型、被 JavaScript 觸發的請求),那些請求不會經過我寫的抓取函式,逐跳驗證對它們完全無效。
每次渲染開一個新的 context(等於一個乾淨的無痕視窗),用完關掉。context 之間不共用 cookie,所以不會有一個網站的登入狀態外洩到另一個網站的問題。
渲染的流程本身很短:
await ctx.route('**/*', route => (/^https?:/.test(route.request().url()) ? route.continue() : route.abort()));
const page = await ctx.newPage();
await page.goto(url, { waitUntil: 'domcontentloaded', timeout: opts.timeoutMs ?? 20_000 });
await page.waitForLoadState('networkidle', { timeout: 8_000 }).catch(() => {});
await page.waitForTimeout(opts.settleMs ?? 1_500);
const finalUrl = page.url();
if (!opts.allowPrivate) await assertPublicHttpUrl(finalUrl); // belt and braces
return { html: await page.content(), finalUrl };
第一行把非 http(s) 的請求全部擋掉(file:、data: 這些)。networkidle 那行後面掛 .catch(() => {}),因為有些站永遠不會靜默:輪詢、長連線、廣告,等不到就算了,繼續往下走。最後那 1.5 秒很不科學,但實務上有效,因為很多站的內容是在 requestIdleCallback 或動畫結束後才塞進 DOM。
倒數第二行的 assertPublicHttpUrl(finalUrl) 是重複驗證:轉址之後的最終網址再檢查一次,程式裡的註解寫著 belt and braces。
第一版我把渲染排成一條佇列,一次只跑一頁。理由是控制記憶體。
它能動,但有兩個問題我當時沒有量:佇列是全域的,不分使用者,而且沒有上限。也就是說,一個人一次丟五十個網址進來,其他所有人的匯入都得排在後面,而排隊的請求就只是掛著等,直到某個地方逾時。
這條佇列後來被整個換掉,換成有上限的並行池加上每個工作區的公平配額。換掉的理由是它沒有上界:排隊的人愈多,最後一個人等愈久,而且沒有任何一段程式會說「不行了」。
這裡只先記下一件事:我當初寫成一條佇列的理由是「控制記憶體」,而那個理由後來被證明只是把問題從記憶體搬到延遲。
第二條路不是免費的。映像裡要裝一整套 Chromium,建置變慢、磁碟變大,而這是每一個自架的人都要付的成本,即使他從來不匯入需要 JavaScript 的網站。
所以它做成可以關掉:IMPORT_HEADLESS=0,關了之後那些網站的匯入會失敗,但映像省下來。自架而且只抓靜態頁的人,關掉是划算的。
這條髒路的規則會一直長:拆只包一個標題的 div、arXiv 改打 API、標題超過八十字元不採用、看到「請稍候」就升級。但「哪些網站要開瀏覽器」的清單我始終沒有留——啟動第二條路看的是頁面的樣子,跟網站的名字無關。二十個網址的實測,第一條路過了十三個;剩下的,交給那台閒置六十秒就自己關掉的瀏覽器。


 iThome鐵人賽
 看影片追技術