
上一篇看過 OpenSpec 會在專案裡放進哪些檔案,也知道一個 change 可以透過 new、continue、ff、apply 與 archive 一路往下走。不過,實際操作時,我們只要執行 continue,下一份 artifact 就會出現。但它是怎麼知道現在該建立哪一份文件,裡面又要寫什麼呢?
OpenSpec 之所以知道下一步,不只是看 change 資料夾裡已經有哪些文件。專案可以先透過 config.yaml 準備共同背景與預設流程;建立 change 時,OpenSpec 也會在 change 資料夾放入 .openspec.yaml,記住這一份 change 要照哪套流程往下走。等我們執行 continue,Skill 就能根據這些設定與目前完成的 artifacts,找出下一份可以建立的文件。這一篇,我們就來看看 OpenSpec 怎麼選出這份文件,再把文件格式、專案背景與這個階段要遵守的規則整理成 instructions,交給 AI 撰寫吧!
這篇使用哪個版本? 和上一篇一樣,下面主要說明我當時開始使用的 OpenSpec 1.0。遇到目前已經不同的地方,我會再另外補充。
config.yaml 先準備哪些專案設定?OpenSpec 的 Customization 文件提到,openspec/config.yaml 是一份可選的 project config,主要可以設定三件事:新 change 預設使用的 schema、每一份 artifact 都需要知道的專案背景,以及特定 artifact 才要遵循的規則。這裡的 schema 是定義 artifacts 與相依關係的一套設定,後面會直接打開來看。
我們先看一份 config.yaml 範例。下面沿用官方範例的 context、rules.proposal 與 rules.specs,另外補上 design 與 tasks 的 rules,方便一起對照:
schema: spec-driven

context: |
  技術:TypeScript、React、Node.js
  API:RESTful
  測試:Vitest
  公開 API 必須維持向後相容

rules:
  proposal:
    - 說明出問題時要怎麼還原
    - 說明哪些團隊需要跟著調整或一起確認
  specs:
    - scenarios 使用 Given/When/Then
    - 撰寫新規格前,先參考現有規格的寫法
  design:
    - 每一項重要技術決策都要說明理由
    - 列出已知風險與取捨
  tasks:
    - 依照工作內容分組
    - 每一項 task 都要附上對應的驗證方式
把這份設定拆開來看,各段內容的用途如下:
| 設定位置 | 適合放什麼? | 這份範例的依據 |
|---|---|---|
schema |
新 change 預設使用哪一套 schema。 | OpenSpec 1.0 官方設定方式。 |
context |
每一份 artifact 都需要知道的共同背景,例如技術、API 慣例、測試工具與向後相容要求。 | OpenSpec 1.0 官方 config 範例。 |
rules.proposal |
proposal 才需要注意的內容,例如出問題時怎麼還原,以及哪些團隊需要跟著調整或一起確認。 | OpenSpec 1.0 官方 config 範例。 |
rules.specs |
specs 的撰寫方式,例如使用 Given/When/Then,並先參考既有規格。 | OpenSpec 1.0 官方 config 範例。 |
rules.design |
design 階段要特別交代的內容,例如重要技術決策的理由、已知風險與取捨。 | 根據官方 design template 的 Decisions 與 Risks / Trade-offs 延伸。 |
rules.tasks |
tasks.md 的整理方式,例如依工作內容分組,以及每一項工作要怎麼驗證。 |
工作分組來自官方 tasks template;驗證方式是本文補上的示意。 |
context 會提供給每一份 artifact,所以我會放各階段都需要知道的專案背景,並避免放容易過時的版本號碼、檔案數量或測試統計數值。這不是 OpenSpec 的硬性規定,而是這些資訊一旦過期,後續建立文件時,AI 就會一直收到不正確的背景。
如果一項要求只有某一份 artifact 會用到,就可以放進對應的 rules。這裡的 proposal、specs、design 與 tasks,對應的就是【Day - 7】介紹過的四種 artifacts。以 design.md 為例,它的 artifact ID 是 design,所以建立這份文件時會讀取 rules.design;建立 tasks.md 時則會讀取 rules.tasks。每一組 rules 要放哪些要求,可以依照專案需求調整,官方沒有規定必填的內容。
這裡要注意!這些 rules 是給 AI 建立對應文件時使用的。例如,rules.tasks 會在產生 tasks.md 時加入 instructions;等到 apply 開始實作,OpenSpec 會使用另一套 instructions,不會再次載入這組 rules。
看完背景與規則要放在哪裡,我們再回到建立 change 的起點。config.yaml 裡的 schema 會先在 new 建立 change 時提供預設流程;前面介紹的 context 與 rules,則要等到產生 artifact 時才加入 instructions。那麼,new 選好 schema 後,會把這次的選擇存在哪裡呢?
.openspec.yaml 記住了什麼?執行 new 建立 change 時,OpenSpec 會一起建立 .openspec.yaml。以當時預設的流程來說,內容大致如下:
schema: spec-driven
created: 2026-01-24
config.yaml 的 schema 是新 change 的專案預設值;.openspec.yaml 則記錄這一個 change 最後實際採用的 schema。created 是建立日期。後續執行 status、continue、apply 或 archive 時,OpenSpec 就可以從這些基本資料知道該使用哪一套流程,不需要每次重新指定。
change 已經記住自己使用 spec-driven,但這個名稱對應的設定裡,究竟定義了哪些 artifacts,又怎麼表示它們的相依關係呢?
schema 會決定一個 change 有哪些 artifacts、彼此的相依關係,以及每一份 artifact 要使用哪一個 template。【Day - 7】介紹 DAG 時,使用的就是 .openspec.yaml 裡記錄的 spec-driven;我到目前為止實際用過的也只有這一套。
CLI 會從這套 schema 的 schema.yaml 讀取 artifacts 的定義,其中也包含相依關係與 template 的設定。以 spec-driven 的 design 為例,設定大致如下:
artifacts:
  - id: design
    generates: design.md
    template: design.md
    instruction: |
      Create the design document that explains HOW to implement the change.
    requires:
      - proposal
id: design 就是前面 rules.design 對應的 artifact ID;requires 列出它需要先完成的 proposal,generates 則指定輸出檔名。至於文件的基本格式,template: design.md 會指向同一套 schema 裡的 templates/design.md 文件。OpenSpec 內建的 schema 與專案自訂的 schema,分別會放在下面兩個位置:
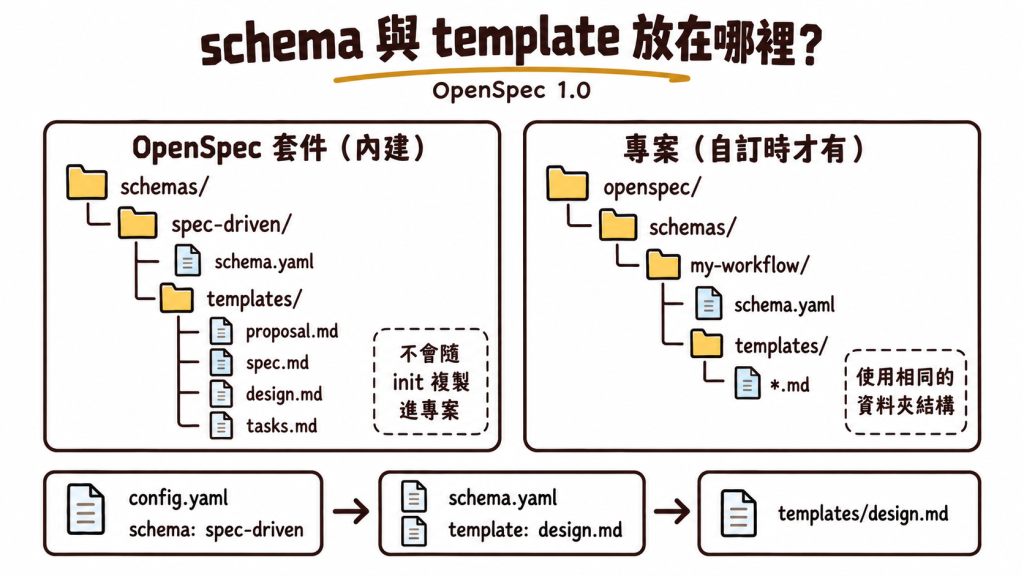
圖左邊的內建 schema 實際上是放在 OpenSpec 套件裡,並不會在初始化時全部複製到我們的專案中,所以【Day - 7】的初始化結構圖才沒有把這一層畫出來。只有建立自己的 schema 時,專案裡才會出現 openspec/schemas/<schema-name>/,並使用相同結構調整 schema.yaml 與 templates/。
還有其他 schema 嗎? 除了前面使用的
spec-driven,當時 OpenSpec 還內建另一套tddschema,流程是spec → tests → implementation → docs;也可以另外建立或修改 schema,換掉 artifacts、templates 與相依關係。我自己沒有實際跑過tdd或自訂 schema,這裡只用它來說明:schema 不只是換一份 template,而是可以改變整套 workflow。
現在有什麼不同? 寫文章時的 官方文件只把
spec-driven列為內建 schema,其他流程需要由使用者自行建立。
知道 schema 怎麼定義相依關係後,接下來就可以看看:continue 怎麼把這些設定和目前已完成的文件放在一起,找出下一份可以建立的 artifact?
continue 背後的 Skill 會依序呼叫兩個 CLI 指令:
openspec status --change "<change-name>" --json
openspec instructions <artifact-id> --change "<change-name>" --json
status 會先找出下一份可以建立的 artifact,instructions 再準備建立這份文件需要的資料。我們先從 status 開始看。假設 proposal 與 specs 已經完成,接下來輪到 design,JSON 大致會長這樣:
{
  "changeName": "add-data-export",
  "schemaName": "spec-driven",
  "isComplete": false,
  "applyRequires": ["tasks"],
  "artifacts": [
    { "id": "proposal", "outputPath": "proposal.md", "status": "done" },
    { "id": "specs", "outputPath": "specs/**/*.md", "status": "done" },
    { "id": "design", "outputPath": "design.md", "status": "ready" },
    {
      "id": "tasks",
      "outputPath": "tasks.md",
      "status": "blocked",
      "missingDeps": ["design"]
    }
  ]
}
結果中的 schemaName: spec-driven 就來自 .openspec.yaml。前面看過 design 的 requires 包含 proposal;這裡 proposal 已經完成,所以 design 是 ready,可以開始建立。tasks 則還在等 design,因此顯示 blocked,並在 missingDeps 列出缺少的 design。Skill 就能依照這些狀態選出接下來要建立的文件。
選出 design 後,AI 還需要它的文件格式、專案背景、rules,以及要參考哪些文件。接下來,Skill 會透過 instructions 取得這些資料。
接著,Skill 會執行 openspec instructions design --change "<change-name>" --json,取得建立 design 需要的資料。下面是簡化的 JSON 示意,較長的文字已縮短,只保留這次說明需要的欄位:
{
  "changeName": "add-data-export",
  "artifactId": "design",
  "schemaName": "spec-driven",
  "changeDir": "<project>/openspec/changes/add-data-export",
  "outputPath": "design.md",
  "description": "Technical design document with implementation details",
  "instruction": "Create the design document that explains HOW to implement the change...",
  "context": "技術:TypeScript、React、Node.js...",
  "rules": [
    "每一項重要技術決策都要說明理由",
    "列出已知風險與取捨"
  ],
  "template": "## Context\n\n## Goals / Non-Goals\n...",
  "dependencies": [
    {
      "id": "proposal",
      "done": true,
      "path": "proposal.md",
      "description": "Initial proposal document outlining the change"
    }
  ],
  "unlocks": ["tasks"]
}
對照前面看過的設定,這份 JSON 裡的 instruction 與 template 來自 schema,context 與 rules 則來自 config.yaml。outputPath 指定要寫入 design.md,dependencies 列出需要參考的 proposal.md 路徑,讓 AI 知道要讀哪份已完成的文件。
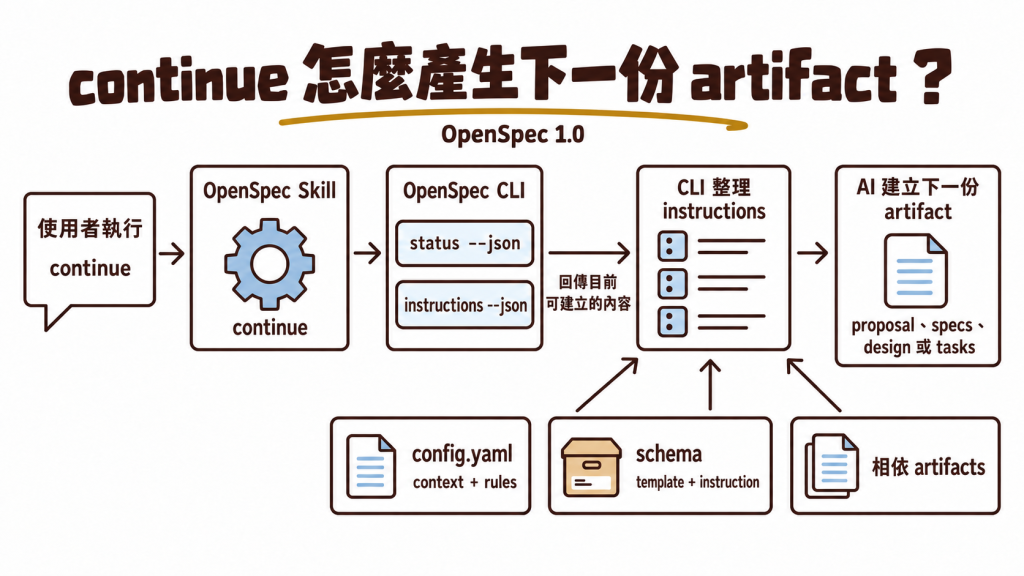
continue 先透過 status 找到下一份 artifact,再用 instructions 取得建立文件需要的資料,最後才由 AI 撰寫並存到指定位置。AI 仍然負責判斷內容,但不用自己猜下一個步驟、檔案位置或 template。
知道這些設定各自負責什麼後,遇到文件不符合預期,也比較有方向可以查。change 採用的流程不對,可以查看 .openspec.yaml 記錄的 schema;文件格式不合,可以查看 schema 指定的 template;專案背景或規則沒有帶進來,則可以對照 config.yaml 與 CLI 回傳的 instructions。平常這些 CLI 指令會由 Skill 呼叫,真的需要查問題時,我們才把它取得的內容打開來看。
不過,continue 建立完這份文件後,會先停下來讓我們查看,而不會直接建立下一份。這個停止條件,以及完成後顯示的下一步提示,又是寫在哪裡呢?
這些要求就寫在各個 Skills 裡。【Day - 7】的 workflow 圖把完成後的下一步建議串成箭頭;現在打開 Skills,就能看到它們在什麼狀態下提供哪些提示:
| 完成的流程 | 接下來怎麼走? |
|---|---|
| new | change 建立完成後,提醒我們使用 continue 建立第一份 artifact。 |
| continue | 每次只建立一份 artifact,說明剛完成的內容與新解鎖的 artifacts 後就先停下來;規劃文件全部完成後,則會提醒我們進入 apply。 |
| ff | 一次準備好實作前需要的 artifacts,完成後提醒我們進入 apply。 |
| apply | tasks 全部完成後,提醒我們進入 archive。 |
| verify(可選) | 完成實作與 artifacts 的核對後,告訴我們有哪些問題值得先處理,或是已經可以準備 archive。 |
| onboard | 從建立 change 開始,透過互動教學帶著我們走過一輪完整的 workflow。 |
以 continue Skill 為例,當時的 Skill instructions 在建立 artifact 後,包含下面幾項和下一步有關的要求:
- Show what was created and what's now unlocked
- STOP after creating ONE artifact
- Prompt: "Want to continue? Just ask me to continue..."
這也表示,continue 建立完 design 後,不會直接接著產生 tasks。它會先顯示這次建立的 artifact、目前完成進度,以及剛解鎖的內容,接著停下來,讓我們決定是否繼續。其他 Skills 也會在結尾提供類似提示,合在一起後,就能對上【Day - 7】workflow 圖裡的每一條箭頭。
第一次使用時: 可以利用 onboard 的互動式教學,讓 AI 帶著我們把整輪 workflow 給走過一次。
看完 Skill 怎麼取得資料、建立文件與提示下一步後,我們也能回頭回答一個設定上的問題:【Day - 3】曾把專案原則放進 constitution,換成 OpenSpec 後,這些要求適合放進 context,還是某一份 artifact 的 rules 呢?
context、rules 和 Spec Kit constitution 有什麼不同?【Day - 3】已經說明過 constitution 會在哪些流程被讀取。不論是我當時參考的版本,還是寫文章時的版本,它都是一份由多個流程共用的專案原則。
constitution 適合放整個專案長期要遵守的原則。如果一條規定只和某一份 artifact 有關,放進 constitution 後,其他會讀取這份文件的流程也會一起收到。提示詞一多,內容又互相重疊或衝突時,這些資訊反而可能成為 AI 產生內容時的雜訊。
OpenSpec 的 config.yaml 則把兩種內容分開:每一份 artifact 都需要知道的背景放進 context,針對個別文件的撰寫要求,則放進各自的 rules。以前面的設定為例,「公開 API 必須維持向後相容」是各階段都需要知道的要求,所以放在 context;「每一項 task 都要附上對應的驗證方式」是在規定 tasks.md 要怎麼寫,就放進 rules.tasks,不必讓其他文件也收到這項撰寫要求。
整理原本放在 constitution 裡的要求時,就可以先問:這項要求是整個專案都要遵守,還是只在建立某份文件時才需要?先分清楚適用範圍,再決定放在哪裡,不必把整份 constitution 原封不動搬進 context。
到這裡,我們已經把規劃文件產生前,設定、CLI 與 Skills 怎麼串在一起看過一輪。文件準備好後,就可以進入 apply。它也沿用 Skill 透過 CLI 取得 instructions,再交給 AI 執行的模式,只是這次的工作是依照 tasks 實作,並更新完成狀態。前面也提醒過,apply 使用的是另一套 instructions,不會再次載入產生 tasks.md 時的 rules.tasks。這裡就不再重複拆解 CLI 的呼叫過程。
不過,tasks 全部打勾後,實作結果是否符合規劃,又該怎麼確認呢?前面提過,verify 是一個可選的流程,可以在歸檔前核對實作結果與 specs、design 是否一致。下一篇,我們就接著看 verify 與 archive 怎麼完成核對與歸檔,再回到我第一次使用 OpenSpec 的 greenfield 實驗,看看這套 workflow 實際跑起來,會得到什麼結果吧!
config.yaml


 iThome鐵人賽
 看影片追技術