
上一篇看過 Skills 怎麼透過 CLI 取得 instructions,讓 AI 建立規劃文件,再由 apply 依照 tasks 實作。不過,當 tasks 全部打勾,實作結果是否符合前面寫好的 specs 與 design,又該怎麼確認呢?
【Day - 7】介紹 workflow 時提過,verify 是歸檔前可以選擇執行的核對流程。那麼,tasks 已經全部打勾後,它還會看哪些內容?我們就先從這裡開始,再看看 archive 怎麼更新正式 specs,並保留這次 change 的紀錄。
tasks 的勾選狀態可以讓我們知道哪些工作已經標記完成,但如果想確認 specs 裡的情境有沒有被實作、程式碼是否符合 design 的決策,就需要把文件與程式碼放在一起核對。執行 verify 時,AI 會重新讀取 change artifacts 與 codebase,從「有沒有做完」「有沒有做對」與「作法是否一致」三個方向檢查這次的實作:
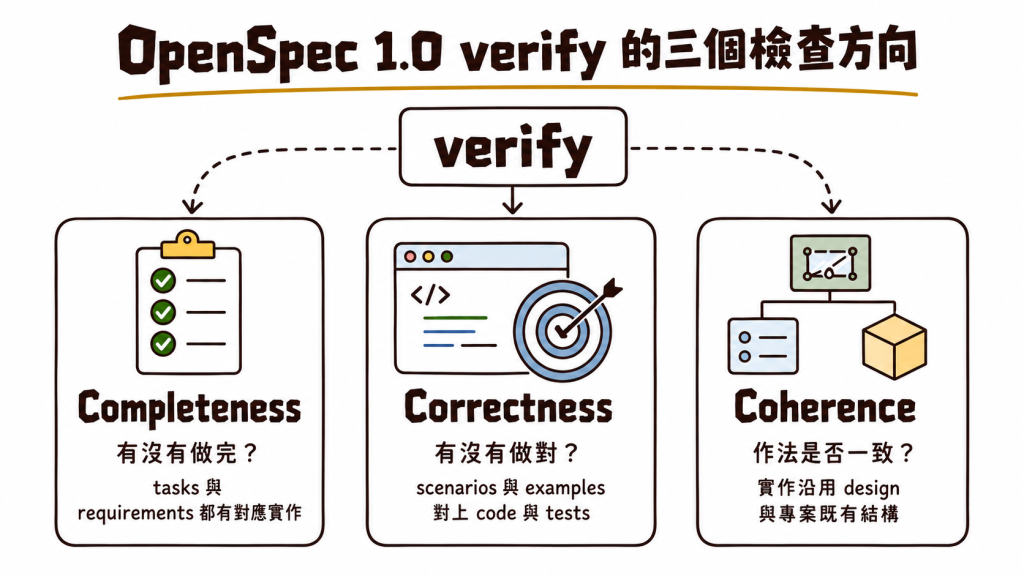
找到的問題會依照 CRITICAL、WARNING 與 SUGGESTION 分組,並盡量附上相關檔案位置與修正建議。假如這個 change 沒有 design,verify 也不會因此失敗;它會略過缺少的部分,並說明哪些內容沒有檢查。
verify 本身只負責檢查,不會直接修改 code,也不會擋住 archive。當時的 apply Skill 在 tasks 完成後,仍然會直接提示可以進入 archive;要不要先執行 verify,是由我們依照這次 change 的範圍與風險決定。
verify 的核對告一段落、需要修正的問題也處理好後,這次 change 就可以準備歸檔了。那麼,change 裡記錄的規格變更,要怎麼更新回 openspec/specs/?當時的 proposal、design 與 tasks 又會保存在哪裡?接下來就來看看 archive 怎麼處理這些文件。
還記得【Day - 6】使用 Spec Kit 時遇到的規格累積問題嗎?當時,如果把後續調整當成新的 feature,再執行 Spec Kit 的 specify,就會建立另一個 feature 目錄。針對同一個功能調整幾次後,specs/ 裡可能留下好幾份前後相關的 spec,我還得自己把它們找出來,才能慢慢整理出系統現在的行為。OpenSpec 則先把「目前的正式規格」和「這次準備做的變更」分開,等 change 完成後,再透過 archive 把兩邊接回來。
這個差別只用文字說不太容易看懂,我們直接用 auth 加入 MFA 的例子來看:
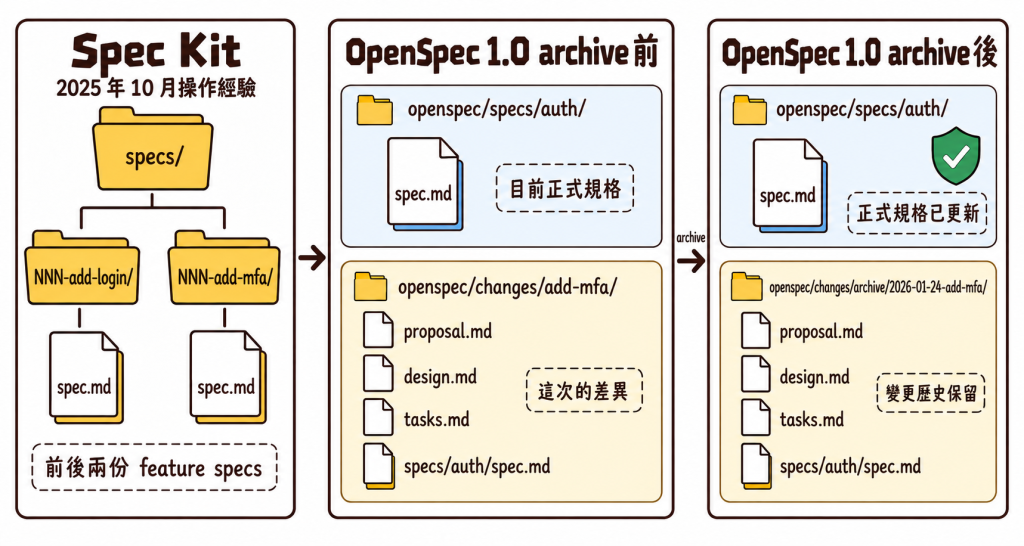
圖左延續【Day - 6】的 Spec Kit 操作經驗,呈現的是 2025 年 10 月左右的作法。原本的登入功能和後來加入的 MFA,可能各自留下一份 feature spec;兩份文件都能回頭參考,但還需要自己整理,才知道 auth 現在完整的行為。
到了 OpenSpec,openspec/specs/auth/spec.md 先保存 auth 目前的正式規格,change 裡的 specs/auth/spec.md 則只記錄這次準備加入的 MFA requirements。如果想先把這些變更合併回正式 specs,但暫時保留 change 繼續工作,可以使用 sync。實作與測試完成後,我通常會直接進入 archive,因為這個流程也會詢問要不要先同步規格。我只要在這裡確認,MFA 的 delta specs 就會合併回正式的 auth spec,整個 change 也會加上日期並移進 archive。
下一次又要調整 auth 時,新的 change 仍然只描述這次的差異。完成 archive 後,差異會繼續更新同一份 openspec/specs/auth/spec.md。這樣一來,如果我們想知道系統目前應該怎麼運作,可以查看正式 specs;想知道以前為什麼這樣改,則可以回到 archive 找當時的 proposal、design 與 tasks。
新增 capability 時的 Purpose: 如果這次新增的是一項 capability,當時的 delta spec 不需要先寫
Purpose。到了 archive,CLI 建立新的正式 spec 時,才會先放入一段待整理的Purpose,提醒我們歸檔後再補上這項能力負責的範圍。也就是說,Purpose是正式 spec 裡的內容,但當時建立 delta spec 時,還不需要完成這個欄位。
要完成這次歸檔,archive 會先檢查規格文件的格式,再確認所有 delta 都能套用,接著更新正式 specs,最後將 change 移進 archive。前面的 verify 是讓 AI 核對實作是否符合規劃;這裡則是由 CLI 確認規格文件能不能完成合併,即使沒有執行 verify,歸檔時仍然會進行這些檢查。那麼,如果 delta specs 少了必要的 requirement 或 scenario,會在哪一步被發現呢?
執行 archive 時,CLI 預設會先透過 validate 檢查 change 與 specs 的文件格式,例如 requirement 底下是否有必要的 scenario。格式檢查通過後,才會繼續處理規格合併。validate 也可以單獨執行:
openspec validate <change-name>
artifacts 建立或修改後,我們隨時都可以手動執行這個指令。歸檔時若要略過這項格式檢查,則需要明確使用 --no-validate。
validate 通過只表示這些文件的格式可以被 OpenSpec 處理,不表示 code 已經符合規格,也不會替 AI 判斷這次 delta spec 應該歸到哪個 capability。格式確認後,CLI 還要先算出這次所有 delta 套用後會得到什麼結果。
【Day - 7】介紹過,delta spec 會用 ADDED、MODIFIED、REMOVED 與 RENAMED 四種操作,描述這次要怎麼改正式 spec。到了 archive,OpenSpec 會根據 requirement 名稱逐項確認:新增的內容不能和現有名稱重複;修改、移除或重新命名時,也必須先找得到原本的 requirement;重新命名後的名稱也不能和其他內容撞名。
這些檢查會先涵蓋同一份 change 裡的所有規格,通過後才開始寫入檔案。假設這次同時修改 auth 與 session,auth 的變更可以正常合併,但 session 的 delta spec 寫著要修改「Session 逾時處理」,正式的 session spec 裡卻找不到這個 requirement。這時 archive 就會停止,auth 的正式規格也不會更新,整個 change 會留在原本的位置,等我們修正後再重新執行。
不過,要檢查「原本的 requirement 是否存在」,CLI 得先知道這次修改的是哪一份正式 spec。它會依照 delta spec 所在的 capability 目錄判斷;如果同一項功能被取了另一個名稱,就可能被當成新的 capability,而不是既有規格的修改。
那麼,delta spec 要放進哪個 capability 目錄,是在哪一步決定的呢?建立 proposal 時,OpenSpec 在 Capabilities 段落的提示詞會要求 AI 列出這次新增或修改的 capabilities。如果是修改既有功能,就要先查看 openspec/specs/ 中已經存在的名稱;新增的 capability 則要取一個 kebab-case 名稱。到了 specs 階段,AI 再依照 proposal 裡列出的名稱,建立對應的 specs/<capability>/spec.md。
capability 名稱還是由 AI 判斷: proposal 的提示詞只提醒 AI 先查看既有規格,沒有規定要怎麼找、又該讀哪些內容。最後能不能找到並沿用正確的 capability,還是得靠 AI 自己判斷。
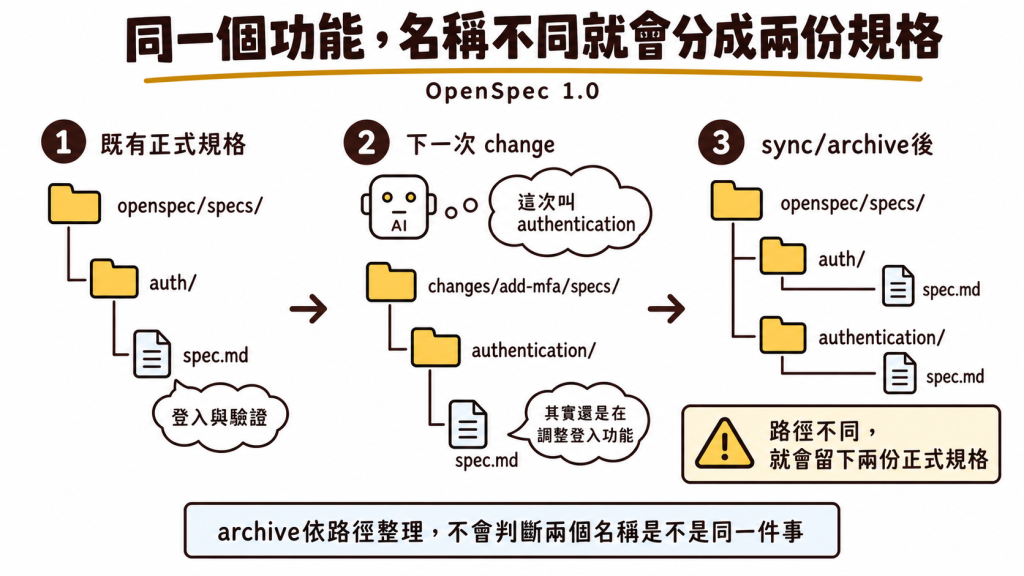
一旦這裡選錯,後面的 sync 與 archive 不會再重新理解兩份規格的內容,只會按照資料夾路徑處理。假設原本已經有 openspec/specs/auth/spec.md,AI 卻把下一次變更放進 specs/authentication/spec.md,archive 就會把 authentication 當成新的 capability,最後留下兩份內容很接近的正式規格。
現在有什麼不同? 目前的 OpenSpec 已經在 spec-driven schema把這條規則寫得更明確:修改既有 capability 時,必須沿用
openspec/specs/裡原本的完整路徑,不能另外改名或移動;propose Skill也會提醒 AI 保留既有的 capability path。這些提示可以降低命名不一致的機會,但 AI 還是得先找對這次要修改的規格。
這個問題解決了嗎? 即使
auth和authentication都在描述登入功能,只要資料夾名稱不同,sync 與 archive 就會把它們當成兩份規格處理。因此,AI 建立 proposal 時,還是得先找出可以沿用的規格名稱,再由我們確認有沒有找對。Issue #901提出一個改善方向:讓 AI 在建立 proposal 前,先透過 CLI 取得既有規格的清單與摘要,減少同一個功能被重複建立規格的機會。這個做法目前仍在提案階段。
整體來說,OpenSpec 透過 archive 搭配 sync,補齊了我使用 Spec Kit 時缺少的規格整理流程。只要 capability 分對,它就會把 delta specs 更新回正式 specs,同時保留當時的 proposal、design、tasks 與變更內容。想知道系統現在應該怎麼運作,就看正式 specs;想知道功能一路做過哪些調整、當時為什麼這樣改,則可以回到 archive 查找相關的 changes。不過,這次變更到底該放進哪個 capability,最後仍然要由 AI 判斷,再由我們確認,算是整套規格整理流程裡的一點美中不足。
那麼,把需求寫成規劃文件、交給 AI 實作,再一路做到歸檔,實際用起來是什麼感覺呢?我第一次使用 OpenSpec,就是拿它來做一個 AI Agent 專案。
那段時間剛好是「龍蝦」爆紅的時候,也就是大家熟知的 OpenClaw。
OpenClaw 當時的名稱變化: 2026 年 1 月底,它在短短幾天內從 Clawdbot 改名成 Moltbot,最後才定名為 OpenClaw。
看著大家都在玩自己的龍蝦,我也忍不住想:「那我也來做一隻自己的龍蝦好了!」
我就拿 GitHub Copilot SDK 來做這次實驗,剛好它也在 1 月多時進入 technical preview。它已經提供多輪對話、工具執行與 session 管理,我不用全部從頭做,就能把比較多心力放在 UI 與互動上,也比較容易用單純的需求測試 OpenSpec workflow。
這隻龍蝦實際做了哪些功能,不是這篇的重點,我就不多做介紹了XD。這裡只要知道,我不是只做一個小畫面或單一 API,而是準備做出一個可以持續加入功能的 AI Agent 實驗專案。
這次和剛接觸 Spec Kit 時最大的差別,是我已經吃過兩次虧,知道把需求交給 AI 產生規格,不會讓原本沒說清楚的地方自己消失。所以,我沒有急著建立 change,而是先按照龍哥分享的作法,使用 Superpowers 的 brainstorming Skill,一題一題和 AI 討論我當前想做的功能、操作方式與技術方向。等這些內容大致談清楚後,我才建立第一個 change,把討論結果整理成 proposal、specs、design 與 tasks,再透過 apply 讓 AI 開始實作。
第一次跑完 OpenSpec workflow 後,最先感受到的就是:需要閱讀與確認的文件真的少了很多!以前使用 Spec Kit 時,會產生 research、data model、contracts、quickstart、plan 與 tasks 等一整套 artifacts;換到 OpenSpec 後,主要就是 proposal、specs、design 與 tasks,檢查起來也輕鬆不少XD。
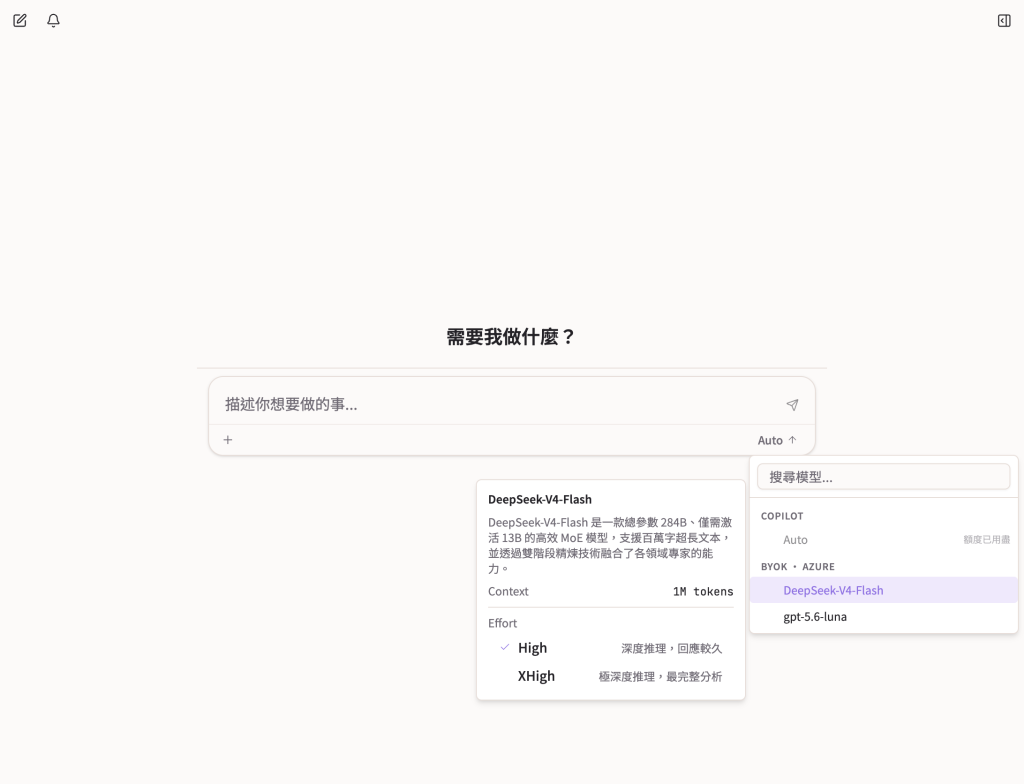
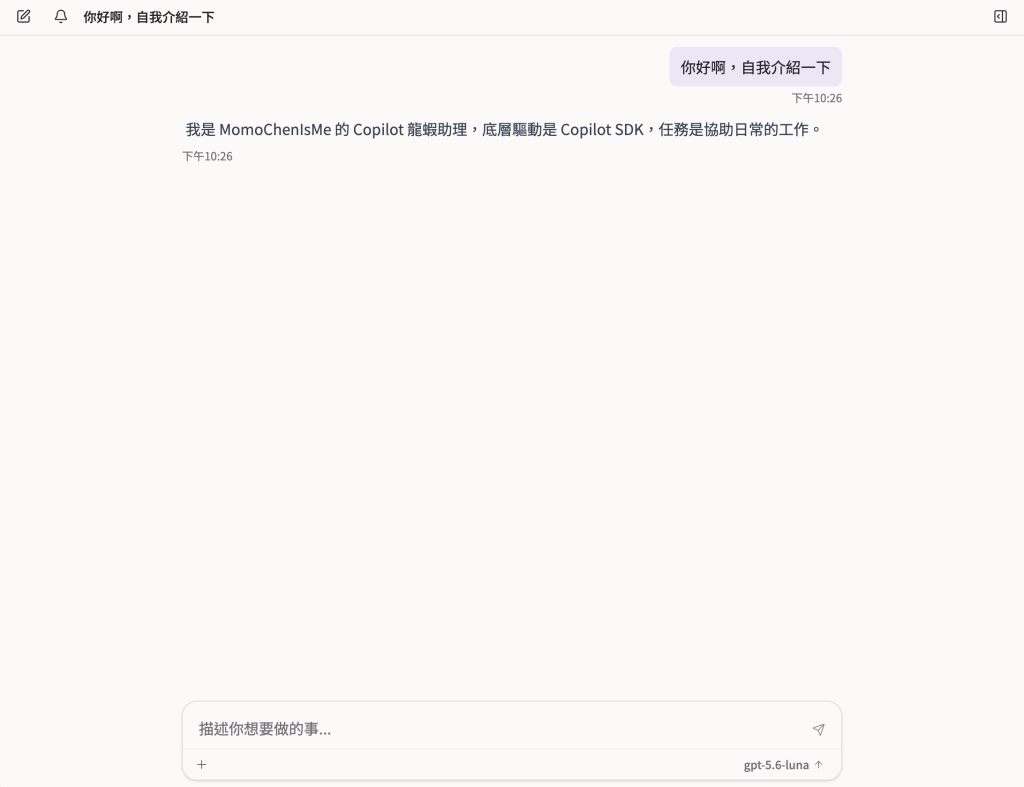
第一輪做出來的操作畫面,已經可以輸入需求、選擇模型與調整推理強度。當時的程式碼後來改了不少,這裡就用目前程式精簡後的畫面,示意當時的操作方式XD。
不過,真正讓我驚訝的還是實作結果。功能完成後,我照著規格逐項測試,規格裡有寫清楚的功能都有做到,整體穩定到讓我有點不敢相信。
AI 當然還是可能犯錯。實際遇到問題後,我也發現有些地方還是老樣子:有些需求本來就是我自己沒有說清楚。這時候,只需要再回到 brainstorming Skill,把缺少的需求或方向重新和 AI 討論一輪,再建立下一個 change,重新跑一次 OpenSpec workflow。就這樣一輪接著一輪補下去,原本缺少的功能也慢慢補齊,最後就真的完成了一個可以協助我做事情的 AI Agent 助手:
當時使用的模型: 在我開始使用 OpenSpec 不久後,Claude Opus 4.6 也在 2 月 5 日推出。至少對我來說,Opus 4.6 是 Opus 系列用起來最穩定、也最驚豔的一版。
不過,這次實驗的條件也和前兩次不同。我已經有使用 Spec Kit 的經驗,開始前又先用 brainstorming 把需求與技術方向談清楚,比較知道哪些地方不能再靠一句「AI 應該知道」帶過。這次也是從零開始的 greenfield 專案,不需要先處理既有架構與過去留下的限制,使用的模型也換成了 Opus 4.6。我對 OpenSpec 的好感,就是在這些條件下累積出來的:除了 workflow 符合我的開發節奏,我自己使用 SDD 的方式也已經不同。所以,這裡分享的是我在這次專案裡的使用感受,並沒有把兩套工具放在相同條件下比較喔!
前面提到,遇到需求缺漏時,我會重新討論,再建立下一個 change。但如果目前這份 change 還沒做完,就需要調整需求呢?
當時的 OpenSpec 已經允許在中途修改 artifacts。apply Skill會要求 AI 在需求不清楚、實作發現 design 有問題或遇到阻礙時先停下來,並建議回頭更新相關文件。我缺少的是一條專門處理中途變更的流程:如果 specs 改了,proposal、design 與 tasks 哪些也要跟著更新,仍然得由我自己判斷,再請 AI 一份一份整理。這點確實讓我覺得有些可惜。
不過,前面的 brainstorming Skill 已經先把需求問過一輪,加上當時使用 Opus 4.6 的結果很穩定,我實際做到一半才需要大幅修改規格的情況反而變少。真的遇到需求追加或方向調整時,我通常會先完成當前這一輪的工作,再重新從 brainstorming Skill 討論新的內容,接著建立下一個 change,完成實作與 archive。雖然多走了一輪,最後正式 specs 仍然會更新到新的狀態。
現在有什麼不同? OpenSpec 到 2026 年 7 月的 1.6 版才加入 update,專門修改既有 change 的 planning artifacts,並一起檢查相關的 proposal、specs、design 與 tasks。這是我剛開始使用 OpenSpec 1.0 時還沒有的流程。
用過第一次之後,我還是幾乎立刻就喜歡上這套 workflow。建立 change 前先把需求問清楚,完成後再透過 archive 更新正式 specs,這兩個部分都很符合我的使用習慣。雖然當時處理中途變更還得自己整理文件,但在這次實驗裡,只要前面的需求有談清楚,實作結果就能穩定地跟著規格往下走。
等我把 OpenSpec 跑過幾輪,正式 specs、changes 與 archive 的關係也比較熟悉後,我才開始嘗試龍哥自行開發的 OpenSpec 圖形化 App:Spectra。它除了提供圖形化介面,也延伸了我已經用順的 workflow。那麼,哪些操作可以沿用原本的習慣,需求中途改變時,又能怎麼更新相關文件呢?下一篇,我們就來看看 Spectra 怎麼安排這些流程吧!
/opsx:verify
validate
/opsx:update


 iThome鐵人賽
 看影片追技術