
一、「p95 太慢」不是結論,是線索的開頭
Day 17 的相對比較做完了:新版在同一環境慢了 40%。你走去跟 RD 說「新版變慢了」,RD 抬頭問:「哪裡慢?」你說:「……p95 慢。」這段對話沒有前進——你只是把同一個事實講了兩次。
先把期待擺正:你手上只有 k6 端的數據,看不到伺服器內部(CPU、慢查詢、GC 這些是 Day 24 之後的事),所以測試人員的價值不是指出兇手——那需要伺服器端證據和 RD 的專業——而是提出好問題、把嫌疑範圍從「整個系統」縮到兩三個。這就像站在案發現場外面的偵探:進不了屋子,但門口的腳印、窗戶的破法、鄰居聽到的聲音,足以排除一大半嫌疑人。同一句話的兩個版本,價值差多少自己感受:「系統變慢了」對上「下單 API 在 40 VU 以上開始惡化,等待時間佔了九成,伴隨 5xx 上升——嫌疑最大的是伺服器側,而且很可能在資料庫」。後者讓 RD 少查半天。
二、第一條線索:把一個請求切開來看
第一條線索藏在你天天看的輸出裡。k6 對每一個請求都記錄了完整的分段計時,只是預設 summary 把鎂光燈全給了 http_req_duration,其他分段安靜地躺在旁邊:
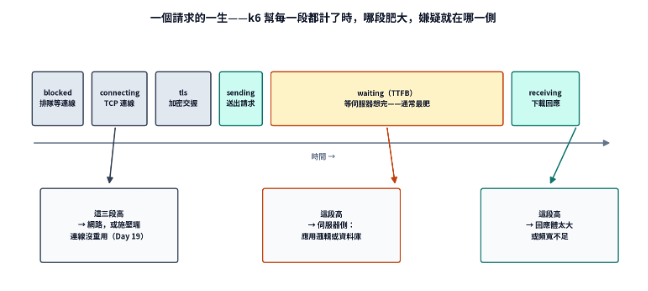
圖 1:一個請求的一生——k6 幫每一段都計了時,哪段肥大,嫌疑就在哪一側
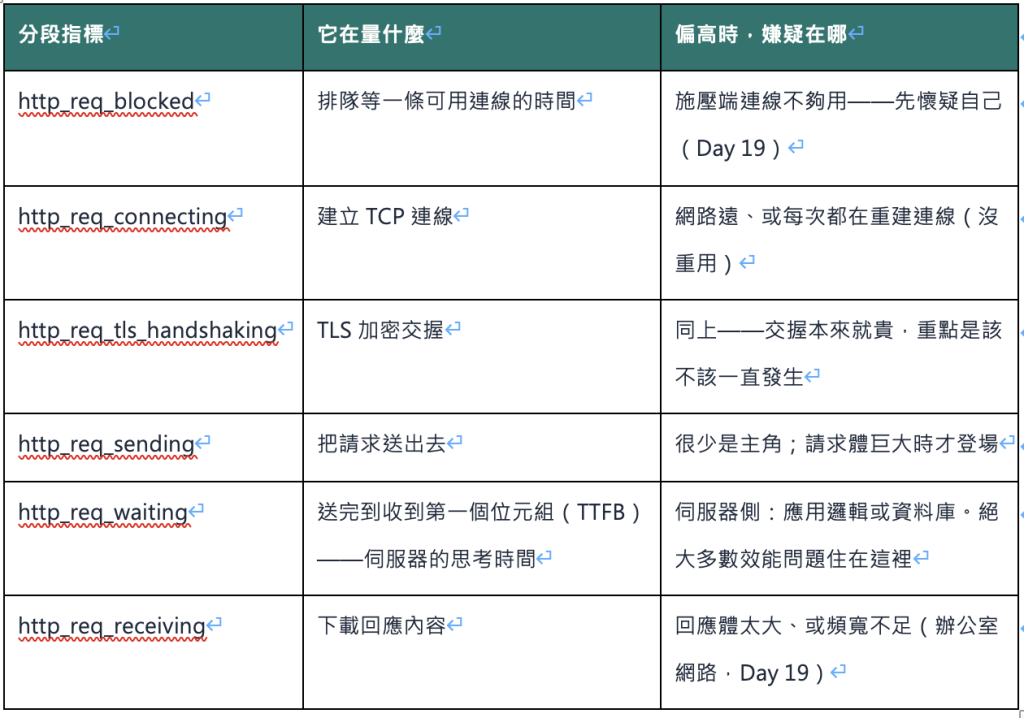
讀法只有一句:http_req_duration ≈ sending + waiting + receiving,而 waiting 就是伺服器的思考時間。waiting 佔九成——嫌疑在牆的另一邊,安心把問題帶給 RD;connecting 與 tls 肥大——問題可能還沒進伺服器,先查網路與連線重用;blocked 肥大——兇手可能是你自己的施壓機,Day 19 專門抓它。一個分段表,先把「牆的哪一邊」分清楚,推理就成功了一半。
三、第二、三條線索:錯誤的長相,吞吐量的形狀
線索二:錯誤不是只有「有沒有」,還有「長什麼樣」。同樣是錯誤率上升,不同長相指向完全不同的方向:timeout 是排隊排到死,典型的容量不足;5xx 是伺服器端真的炸了,帶著時間點通知 RD;connection refused/reset 是連線層撞到上限;而 4xx 突然增加,先深呼吸——最常見的原因是測試自己:token 過期了(Day 10)、測試資料被昨天弄髒了(Day 9)。報案之前,先確認不是自己家失火。
線索三:吞吐量的形狀,就是 Day 1 那條曲線的實測版。把一輪爬升測試(Day 12 的 stages)跑完,對照 VU 數與 rps 的關係,形狀只有三種:VU 加、rps 跟著漲、回應時間平穩——還沒到瓶頸,舒適區;VU 再加、rps 開始打平、回應時間開始爬——恭喜,你找到飽和點了,這就是這個環境的容量,多出來的使用者全在排隊;VU 繼續加、rps 不升反降、錯誤開始噴——過載崩潰區,系統把力氣花在處理塞車而不是做正事。「rps 打平的那個 VU 數」是判讀裡最有分量的一個數字——它直接回答 Day 1 的第一問:撐得住多少人。
三條線索單獨看都只是碎片,交叉之後才會說話——互相支持的假設留下,互相矛盾的剔除: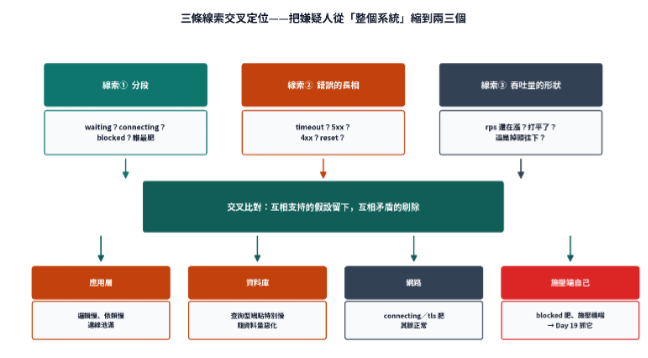
圖 2:三條線索交叉定位——把嫌疑人從「整個系統」縮到兩三個
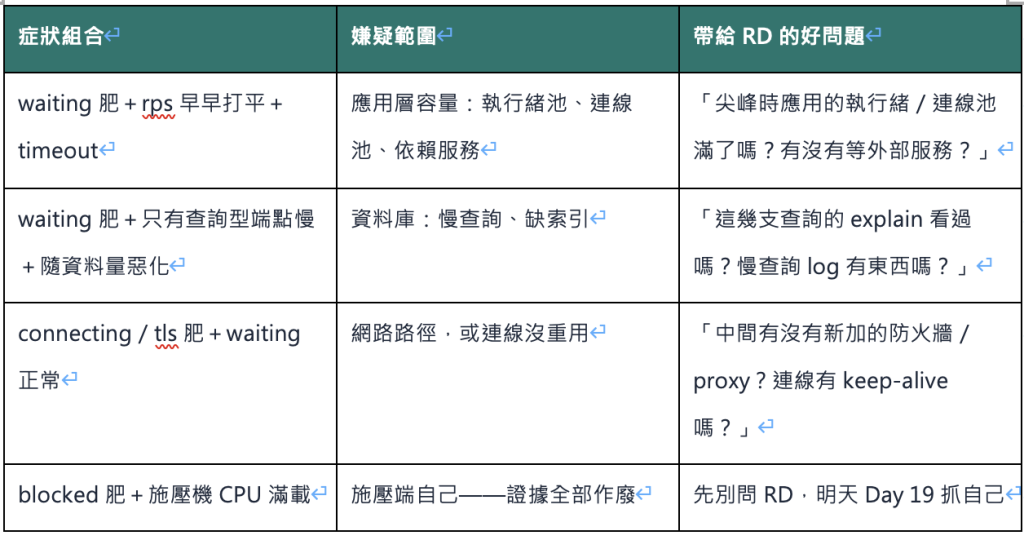
注意資料庫那一列的經典指紋,值得單獨記住:整體不慢、但帶查詢的端點特別慢,而且資料越多越慢——這個組合出現時,十之八九和 Day 17 說的「測試環境只有一千筆」是同一個故事的兩面:資料少時它假快,資料多了它現形。
四、動手做:讓 Claude Code 當華生,你當福爾摩斯
練習一:解剖自己的請求。先讓分段指標現身,看看健康系統的分段長什麼樣——之後才認得出生病的:
Prompt 1|輸出請求分段解剖表
請執行 k6 run --vus 3 --duration 60s pizza-api-test.js,
執行時加上參數,讓 summary 顯示以下指標的 avg 與 p95:
http_req_blocked、http_req_connecting、http_req_tls_handshaking、
http_req_sending、http_req_waiting、http_req_receiving。
跑完後把各分段整理成佔比表(各段 avg 佔 duration 的百分比),
指出哪一段佔大頭,並解釋這代表時間花在誰身上。
對公開練習站的預期結果:waiting 佔絕對大頭、connecting 與 tls 幾乎是零(連線重用得很好)——這就是「健康」的長相。順帶看一個小細節:blocked 與 tls 的 max 通常不小、p95 卻趨近零,因為交握只發生在每個 VU 的第一次請求——這正是 Day 5 說過的「看分佈、別只看平均」在分段指標上的重演。
練習二:拿一副症狀卡練推理。真實的瓶頸沒辦法在公開站上安全重現,但推理可以用案例練。把下面這副「症狀卡」原封不動交給 Claude Code——重點在 prompt 的姿勢:要假設清單,不要診斷書:
Prompt 2|列假設,不下診斷
以下是一輪爬升測試(5→60 VU,共 10 分鐘)的觀察:
- 40 VU 前:p95 約 500ms,rps 隨 VU 線性上升
- 40 VU 後:rps 打平在 210 上下,p95 爬到 2.8s
- http_req_waiting 佔 duration 的 93%
- 55 VU 起 http_req_failed 升到 4%,全部是 timeout
- 只有 GET /search 和 GET /orders?filter=… 明顯變慢,其他端點平穩
請列出至少三個假設。每個假設要註明:支持它的證據、
不利於它的證據、以及要驗證它還需要什麼數據或問誰什麼問題。
不要下結論,也不要使用我沒有提供的數據。
拿到假設清單後,換你上場:哪個假設的支持證據最強?(照這副牌面,資料庫嫌疑最大——waiting 肥、查詢型端點特別慢、飽和後 timeout,三條線索互相支持。)接著做 Day 15 教過的那件事:逐條檢查 AI 引用的每個數字是不是你真的給過的。寫著「CPU 使用率偏高」?你根本沒給 CPU 數據——這就是腦補,圈起來,要求它只依提供的證據重寫。
練習三:故意挖個洞,看它跳不跳。把 Prompt 2 的症狀卡刪掉錯誤率那兩行再問一次。觀察 Claude Code 是老實說「缺少錯誤數據,無法判斷飽和後是否伴隨失敗」,還是自己編了一個錯誤率繼續推理。這個練習的目的不是抓 AI 出糗,是校準你自己的警報器——判讀場景裡,AI 最危險的不是算錯,是把「聽起來合理」的細節無中生有。腳本寫錯了 smoke 會抓到,推理編錯了沒有任何機器會叫。
五、注意事項:推理最常見的六個坑
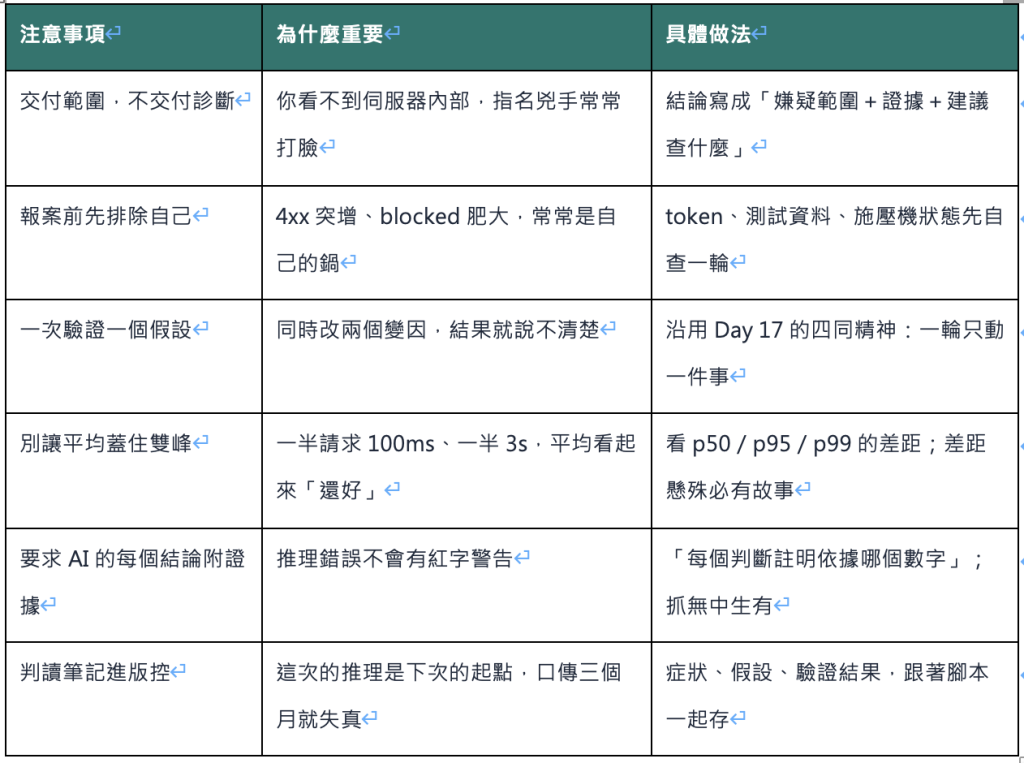
給 RD 的一句話:當 QA 拿著「waiting 佔 93%、只有查詢型端點慢、40 VU 後 rps 打平」來找你,他已經替你排除了網路和施壓端,把範圍縮到你家裡的兩個房間。此時回一句「我去看慢查詢 log」,整個團隊快一天;回一句「應該是環境問題吧」,他明天還會再來,帶著更多證據。
六、觀念驗證:三個問題確認你有帶走今天的重點
• http_req_waiting 和 http_req_connecting 各在量什麼?waiting 佔九成的時候,嫌疑在牆的哪一邊?(第二節)
• VU 一路加,rps 先漲、後打平、回應時間開始爬——打平的那個點叫什麼?它回答了 Day 1 三問裡的哪一問?(第三節)
• 為什麼要求 Claude Code「列假設+驗證方法」而不是直接給結論?練習三挖的那個洞,是在測它的什麼毛病?(第四節)
七、小結
判讀不是通靈,是拿著三條線索做交叉比對:分段解剖分清楚時間花在牆的哪一邊,錯誤的長相分清楚是塞死、炸掉還是自己烏龍,吞吐量的形狀找出飽和點——那個回答「撐得住多少人」的數字。交叉之後,嫌疑人從整個系統縮到兩三個,你交出去的是範圍、證據和好問題。AI 在這裡是華生:列假設、整理數據飛快,但挑出最強假設、為結論負責的是你——而且要盯著它別把沒有的證據講得煞有其事。不過,這一切推理有個前提:k6 端的證據本身得是真的。如果施壓機自己先到了極限,waiting、rps、錯誤率全都在說謊——Day 19,我們來抓「不可信的測試」。
附錄:判讀速查(影印版)
—— 線索① 分段 ——
waiting 肥      → 伺服器側 (應用/DB), 效能問題大本營
connecting/tls 肥 → 網路路徑, 或連線沒重用
blocked 肥      → 施壓端自己 (Day 19)
receiving 肥    → 回應體太大, 或頻寬不足
—— 線索② 錯誤的長相 ——
timeout         → 排隊到死, 容量不足
5xx             → 伺服器端故障, 帶時間點通知 RD
4xx 突增        → 先自查: token (Day 10) / 髒資料 (Day 9)
refused/reset   → 連線層撞到上限
—— 線索③ 吞吐量形狀 ——
rps 隨 VU 漲    → 未飽和
rps 打平+RT 爬  → 飽和點 = 這個環境的容量
rps 下跌+錯誤升 → 崩潰區
—— 交付物 ——
嫌疑範圍 + 引用的證據 + 給 RD 的好問題 (不是診斷書)
```


 iThome鐵人賽
 看影片追技術