
前五篇從問題、策略,一路談到架構怎麼選。接下來,我想把這些想法放在同一張圖上,看看每一層到底要做什麼,以及彼此怎麼配合。
一張架構圖有很多元件、很多連線,看起來可能很完整。但我讀圖時,還會想知道:這一層誰負責?出問題要找誰?要新增一個功能,又該放在哪裡?這些能回答,圖才真正幫得上工作。
所以,我想先把各層的工作整理出來:
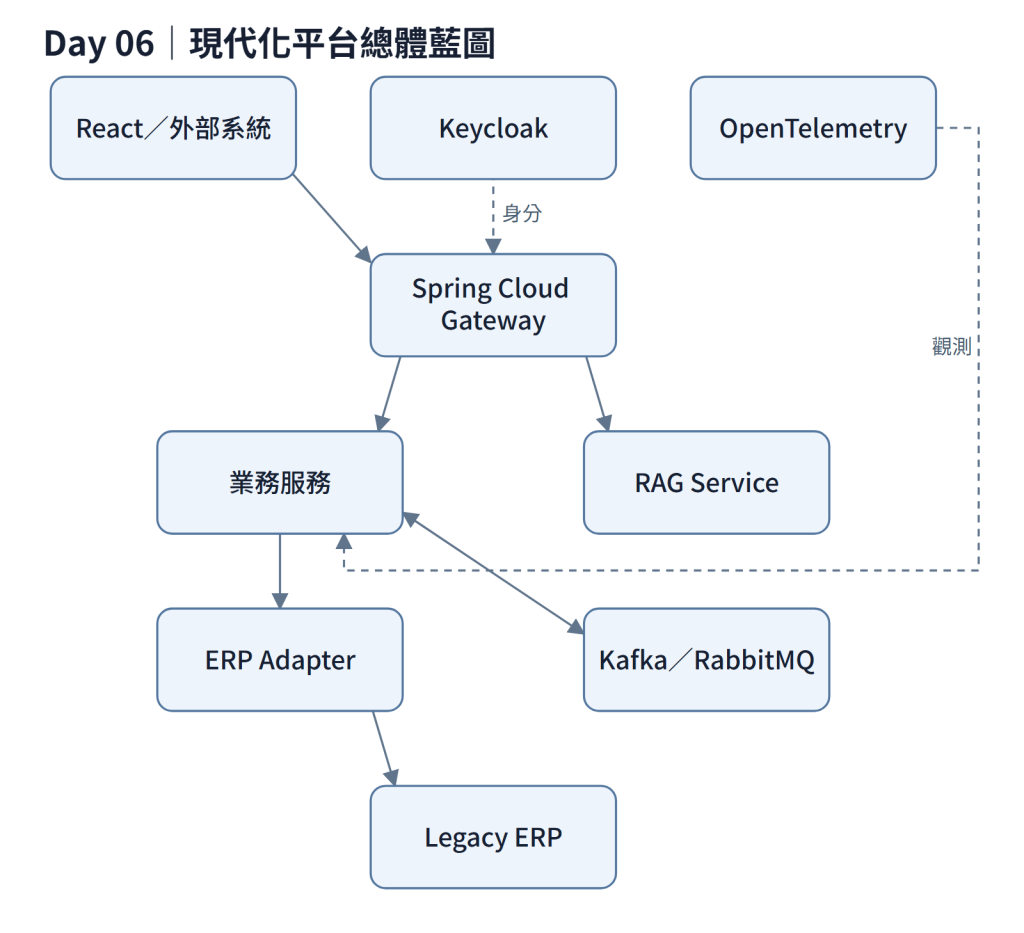
圖 Day 06-1:現代化平台總體藍圖。
分工的目的,是讓人知道某類變更該改哪一層、由誰負責。所以我會先用「什麼事情改了,會需要動到這一層」來理解:外部呼叫方式改了,看 Gateway;ERP 介面改了,看 Adapter;業務規則改了,回到業務服務。
如果同一個變更常常要同時改到 Gateway、業務服務與 Adapter,就可以回頭檢查源頭。例如 ERP 欄位是否一路帶到業務服務,或入口是否開始處理業務判斷。先找原因,再決定需不需要調整。
RAG 雖然也畫在圖上,目前仍是規劃中的能力。它不參與 ERP 核心交易判定,也不提供業務規則的最終依據。這一階段先整理治理與 PoC 條件,後面 Day 21、Day 22 再慢慢展開。
身分與可觀測性以虛線連接,代表它們是橫切關注點,不在業務呼叫鏈上。這兩層一旦故障,影響範圍會跨越所有服務,因此容量與可用性要求要獨立評估。
畫好之後,我會再替每個元件補上 repository、負責人和介面規格。用途、資料責任、依賴、SLO、部署、健康檢查、告警、操作手冊與退場條件,也一起記錄,讓接手的人知道從哪裡開始。
連線的意思也要寫清楚。哪一條是同步 REST、哪一條是事件、哪一條是 SOAP,都標出來,大家才不會對等待、逾時或重試有不同理解。
平台裡的元件通常只會越加越多。放進來時都有理由,但沒有人記下什麼情況可以拿掉,久了就沒有人敢刪。所以登記表裡我還會保留一個欄位:退場條件。元件放進來的當天,就先寫下兩件事:出現什麼訊號就可以拿掉,例如舊端點流量連續一段觀察期為零;以及拿掉之前,要先斷開哪些依賴。
| 取捨 | 這樣選的理由 | 何時要重新評估 |
|---|---|---|
| Gateway 作為單一入口 | 認證、限流與追蹤有集中控制點 | 入口容量或故障影響範圍超出可接受程度時 |
| 身分與觀測平台共用 | 避免各服務各自實作,治理才可能一致 | 共用平台的可用性成為整體瓶頸時 |
| ERP 存取一律經 Adapter | 業務服務不需理解 SOAP 與舊錯誤碼 | Adapter 開始承擔業務規則時(見 Day 14) |
| RAG 僅列為規劃中元件 | 尚未驗證的能力不應納入交易路徑 | PoC 完成且驗收門檻通過後 |
Gateway、身分與觀測平台由多個服務共用,集中之後比較容易統一管理,但大家也共同依賴它們,因此這幾層會另外評估容量與降級方式。
我會用一條完整的測試流程來對照這張圖,看看下面幾件事是否都做得到:
| 驗證項目 | 做法 | 想確認什麼 |
|---|---|---|
| 端對端可追蹤 | 選一筆交易,檢查是否能取得完整 Trace | correlation ID 是否貫穿各層? |
| 責任歸屬明確 | 對照每個元件的負責人與操作手冊 | 出問題時是否知道找誰? |
| 協定標示正確 | 比對圖上連線與實際實作 | 同步/非同步假設是否一致? |
| 共用層降級 | 模擬身分或觀測平台不可用 | 影響範圍是否符合預期? |
實際走過一次,比只看圖更容易發現缺口。所以準備一筆測試交易,從身分驗證、路由、業務服務,一直走到 Adapter 與 ERP,再看 Trace 能不能串起來。哪一段接不上,就先把那一段補好。
這張圖會陪著後面的文章一起往下走,隨時拿來確認服務與平台的責任。圖上列出的能力,包含仍在規劃的 RAG,還是要各自驗證完成程度。下一篇,先從服務邊界開始整理。


 iThome鐵人賽
 看影片追技術