
Prometheus 收集 Metrics,Grafana 呈現與關聯資料,Jaeger 查詢 Trace。工具的分工先知道了,接下來我更想整理的是:真的收到告警時,要先看哪裡,又要做什麼?
如果 Dashboard 只是照元件各放一頁資訊,平常看起來很完整,出問題時卻可能要不停切換。使用者在意的是訂單能不能完成,值班人員得自己把 Gateway、資料庫與 broker 的資料拼湊起來,才看得出訂單卡在哪一段。
所以我會先列出處理事故時需要回答的問題,再依這些問題安排畫面與告警。
我希望每張畫面都能幫忙回答三個問題:使用者有沒有受影響、哪個服務不正常、資源夠不夠用。前兩個問題看服務的 RED,先看 Gateway 這類最先接到使用者請求的入口服務,再往下看各業務服務;第三個問題看 CPU、連線池這類資源的 USE。
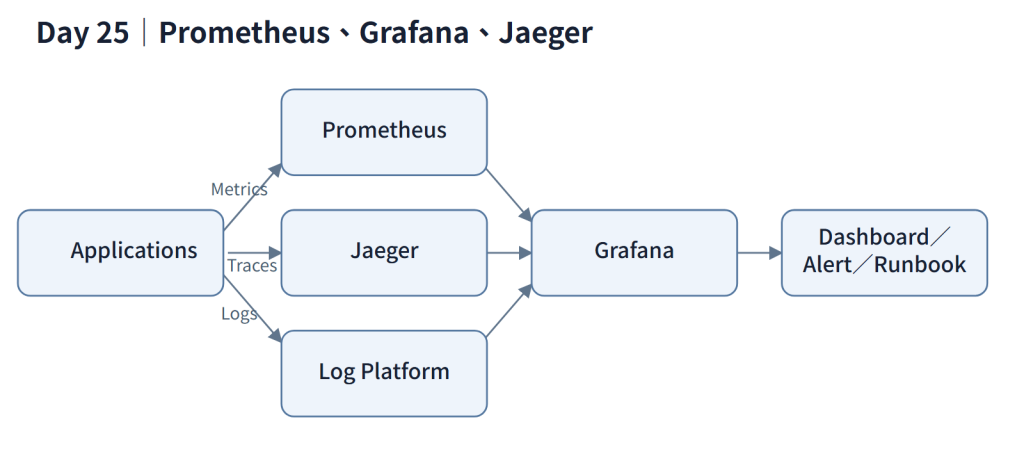
圖 Day 25-1:Prometheus、Grafana、Jaeger。
看得到狀況、知道何時該看,再有一份可以照著處理的步驟,三件事都準備好,收到告警的人才知道要先看哪裡、再做什麼。所以這張圖最後,我把 Dashboard、Alert 與 Runbook 放在一起。
RED 與 USE 的時間特性不同——USE 的指標通常會在 RED 惡化之前先出現趨勢,因此容量類告警應設在使用者受影響之前觸發。
每條告警帶嚴重度與負責人兩個標籤、runbook_url 與 dashboard 兩個連結;嚴重度的值越多,轉送通知的規則就要跟著多寫,所以只留 critical 與 warning 兩個值;page、warn 這類意思重疊的寫法不再使用。門檻也要配合持續時間和業務影響,讓收到的人知道為什麼需要處理,以及第一步可以做什麼。
如果每次短暫尖峰都通知,訊息一直來,大家反而很難分辨哪些真的需要介入。所以告警規則通常會加上持續時間:條件在每次檢查時都要仍然成立,連續滿這段時間才發通知。不過,實際要等多久,還是要依業務影響安排。
查問題時,先看整體,再往細節走,比較不容易只看到單筆異常。所以我會先用 Metric 看範圍與趨勢,再到 Jaeger 比較 Gateway、業務服務、Adapter 與 ERP 呼叫的 span,最後找相關 Log。
| 取捨 | 這樣選的理由 | 何時要重新評估 |
|---|---|---|
| Dashboard 依業務流程而非元件建立 | 使用者感受到的是流程中斷,不是某個元件異常 | 需要元件層細節時,另建 drill-down 頁面 |
| 告警一律附 Runbook 與負責人 | 收到的人不知道要做什麼,久了容易被忽略 | 無 |
| 門檻含持續時間條件 | 避免瞬間尖峰造成頻繁告警 | 需要即時偵測的高風險項目 |
| 容量告警設在使用者受影響前 | 保留處理時間 | 誤報率過高時,調整門檻而非取消 |
告警也需要定期整理。我會逐條確認:收到之後,有沒有明確的處理方式?重複的、已經不適用的,都要調整,Runbook 也跟著更新。
| 指標 | 計算方式 | 想回答的問題 |
|---|---|---|
| 告警精準率 | 需要處理的告警數/全部告警數 | 告警是否值得看? |
| MTTD | 從問題發生到被偵測的時間 | 監控是否夠早發現? |
| MTTR | 從偵測到恢復的時間 | 處理流程是否順暢? |
| SLO 達成率 | 符合 SLO 的時間比例 | 使用者體驗是否穩定? |
| Trace 覆蓋率 | 可完整追蹤的請求比例 | 定位工具是否可用? |
如果多數告警都不需要處理,就先回頭整理規則,讓值班人員收到的每則訊息都有明確用途,真正需要注意的問題也比較容易被看見。
我認為監控除了畫面與告警,還要一起交付負責人與處理步驟,收到告警時,才知道該由誰處理、怎麼處理。下一篇,再看看 CI/CD 怎麼把測試、核准與部署紀錄留下來。


 iThome鐵人賽
 看影片追技術