
昨天聊了軟體工程,今天來看看 AI 在協助我們開發時,可能遇到哪些限制。
截至今天我所知道的限制啊,說不定明年又不一樣了
由於AI其實泛指太多東西,這邊的AI先暫定為LLM。
在討論 AI 協助開發可能遇到什麼問題之前,我們得先知道一件事:
LLM 所產出的結果,跟它當下拿到的 Context 息息相關。
什麼是 Context 呢? 簡單理解就是:模型在產生這次回答時,實際所收到的資訊
Context(上下文)可能包括但不限於:
所以 Context 並不只是「你這次打的 prompt」。
今天一個 coding agent 到底知道什麼、看到什麼、被要求遵守什麼,全部可以視為 Context 的一部分。
而且這些資訊的重要程度並不相同。
Anthropic 甚至專門寫了一篇文章叫 Effective context engineering for AI agents 討論如何決定哪些資訊應該進 Context、哪些資訊不應該進去,以及長時間執行的 Agent 要怎麼管理 Context。
有興趣的可以看去年 context engineer 的介紹:https://ithelp.ithome.com.tw/articles/10394239
知道 Context 是什麼之後,接下來就來看看它在實際使用上可能遇到哪些問題。
像是這篇 ICLR 2026 的 Outstanding Paper, LLMs Get Lost in Multi-Turn Conversation
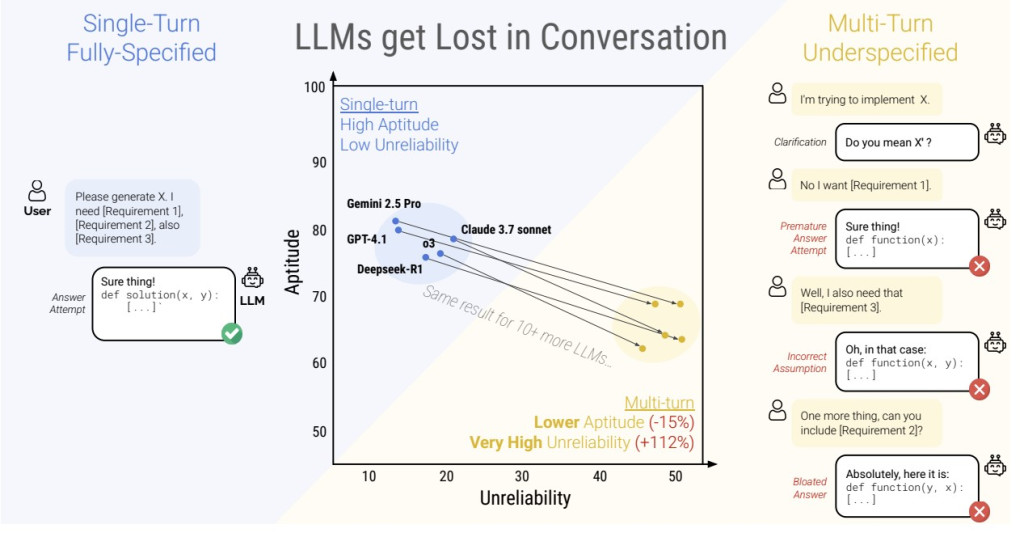
這篇論文比較了兩種使用 AI 的方式:
可以發現受測試的15個不同模型,在 multi-turn 的情況下,平均表現下降了約39%。
paper說有提到一個觀察的點是:模型會在資訊還不完整時先做假設、產生答案,後面又過度依賴自己先前寫的東西。
這是否像極了我們日常開發方式?我們在開發東西時候是逐步迭代的,幾乎不可能在最一開始就定義好所有該做的事情
我們可能覺得 只要逐步修正即可。但對AI來說,前面那套根據假設寫出來的東西,現在也成了Context的一部分。後來補上正確需求,不代表前面的錯誤假設就會自動消失。
但實際開發甚至比這個情況更麻煩,因為我們不只是「一開始沒把需求講完」,而是需求本身是真的會動態調整。
另一篇由 Microsoft research 團隊提出的研究 LLMs Get Lost in Evolving User Intent 右更進一步討論這件事情。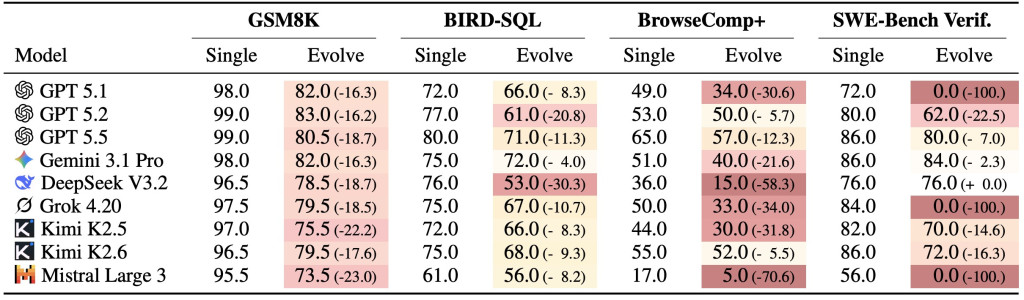
先解釋論文這張表中的兩個不同的實驗設定:
Single:原始 benchmark 的單輪、完整規格輸入。也就是使用者在一次 prompt 裡把任務所需資訊全部給完,模型直接回答。
Evolve:把同一個原始任務改造成多輪、使用者意圖會演化的對話。最終要解的仍然是原始 benchmark 的那個 task,因此最後答案還是用原 benchmark 的 verifier 評分。
可以看到當今天使用者意圖逐步演化的情況下(Evolove),大部分的 model 多多少都受到了的影響,並且會導致能力下降。
這件事又多帶出一個 Context 的問題:
我們不只是要讓 AI 知道「現在有哪些資訊」,還要讓它知道「前面的哪些資訊現在還有效」。
所以如果稍微整理一下,大概可以分成下面幾種。
我覺得可以用一種方式去思考,就如同人類一樣,如果我們同時接收到太多雜訊,雖然知道該focus在目標上,但多多少少還是會被影響。AI也是如此。
那軟體工程,可以用什麼角度避免這些事情呢?明天再來聊。
reference
Effective context engineering for AI agents
https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
Context Engineer 介紹
https://ithelp.ithome.com.tw/articles/10394239
LLMs Get Lost in Multi-Turn Conversation
https://arxiv.org/abs/2505.06120
LLMs Get Lost in Evolving User Intent
https://arxiv.org/abs/2607.20734
ICLR 2026 Outstanding Papers
https://blog.iclr.cc/2026/04/23/announcing-the-iclr-2026-outstanding-papers/


 iThome鐵人賽
 看影片追技術