
昨天提到的 AI 很容易因為接收到的 Context 而影響輸出的水準,那軟體工程又能透過什麼方式解決此問題呢?
想像一種情境,小時候疊積木蓋房子時,在底座歪斜不穩的情況下,是很難持續往上疊的。相反的,如果底座穩定並且堅固,則較容易繼續打造出完美且成熟的物件。
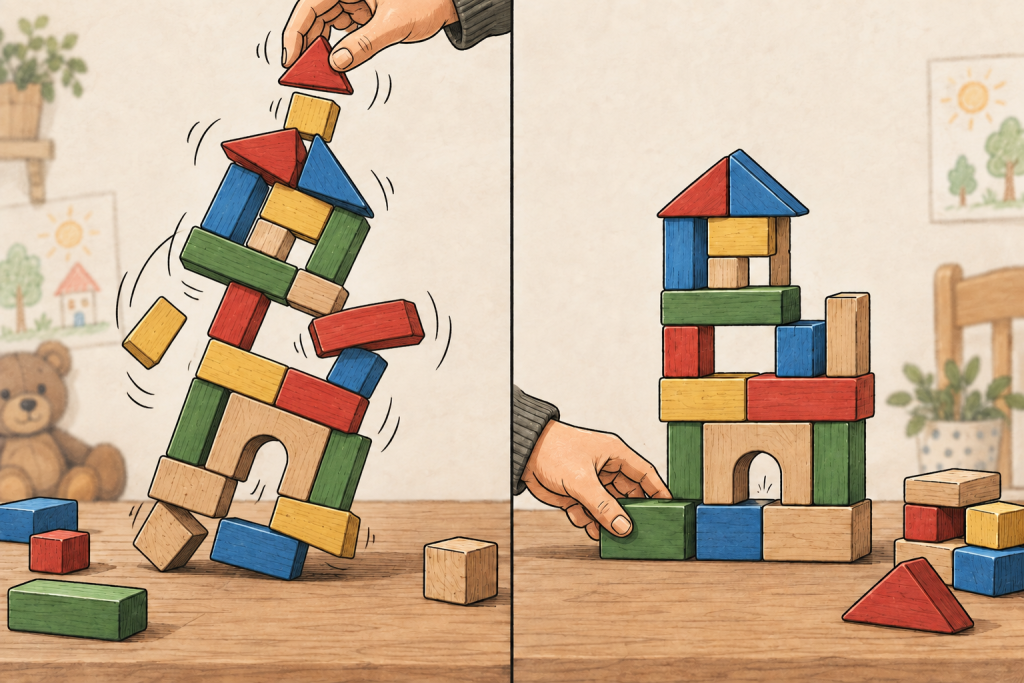
開發時也是如此。隨著需求的變動,我們得重新檢查原本的假設與程式結構是否還適用。若在不清理的情況下持續開發,就很容易提高開發所需要的精力成本。
那昨天留下的問題就來了:軟體工程如何幫助我們與 AI 一起面對這些變動?
軟體工程兩大重點:
當問題規模很小、需求固定,而且幾乎沒有後續維護成本時,很多軟體工程方法的價值確實不容易體現。
但如果開發的是一個會持續變動與更新的軟體,我們就得考慮:下次需求進來時,是否知道該從哪裡著手,這些變動是否影響其他方,又是否會造成錯誤。
軟體工程的各種方法,就是在處理這些問題。至於需要做到什麼程度,仍然得看專案的情境,沒有一套永遠適用的最優解。
回到昨天的 Context。
AI 在修改程式時,需要知道目前的設計理由、既有的程式行為,以及這次修改要達成什麼目標。
如果這些資訊只存在我們腦中,或者散落在前後矛盾的對話裡,AI 就可能根據不完整或錯誤的資訊繼續往下做。
而若有良好的風格與架構設計,則可在不特別提醒 ai 的情況下,遵照目前的框架下去實作,進而保持良好的品質與降低出錯的可能性。
例如,程式中準確的命名能表達其用途;責任劃分清楚的架構能降低修改時的範圍;文件可以記錄需求與設計理由;測試則能把部分預期行為變成可執行的檢查。藉此,當 AI 在讀取這些內容時,就降低了額外判斷與猜測的行為,進而提高任務交付的水準。
另一方面,如果程式各部分的責任能清楚劃分,降低模糊地帶,人與AI 也都能較容易提供準確的指示與敘述而不需要解釋半天。這不僅在對 AI、對人、對同事上都是更好的影響。
當然,前提是這些內容仍然反映現況。需求改了,文件與測試卻沒更新,反而可能成為另一個誤導來源。所以重點也包括:修改功能時,一起確認哪些既有資訊與決定需要調整。
而整理文件、探索不同拆法、補上測試與執行檢查,這些過往人類最不想做的瑣事,AI 能協助完成。這也是我覺得兩者能相輔相成的地方:工程方法讓合作有依據,AI 則有機會降低實踐這些方法的成本。
你可能會覺得,現在 AI 能力那麼強,在 prompt 裡提醒它「保持乾淨的架構、遵守軟體工程原則」,不就好了?
首先 Know how 絕對是人類最基本的必備條件,有足夠知識你才能更有效率地使用 AI agent 並且與其討論。
一直很喜歡李宏毅老師提過的一個例子,人類之於AI,就像是坐在大象上的象伏,大象是有能力的,但若無法好好下指令駕馭 也無法得到你想要的結果。
而且如同recap提到的重點,軟體開發不存在最佳解。在各個設計架構之間是存在不同 tradeoff 的。
所以相比於只要求「請保持良好的架構」,若有相關的背景知識,能更容易的與其進行討論並且釐清實際需求
並且在與AI對話時產生的摩擦,不僅讓能加深對於作品的理解,也提高對其能力的掌握度。 可喜可賀。
但,AI又已經這麼發達了,這過程中,部分老舊的軟工概念有機會淡出,也有新的維度需要帶入。
這也是我想透過這個系列挑戰的事情:並且如何系統化的介紹AI時代下的軟體工程。
接下來,會從 Control, Contain, Choose 三個角度切入,從軟體工程的角度去控制與使用 coding agent。
這三個階段對於 coding agent 的約束力度,會從非常確定性的規則(rule-base),逐漸放寬到較模糊的約束,甚至最後需要人為介入與討論。其理解難度也是從簡單到困難。
具有背景實力的小夥伴 建議可以直接切入到對應主題喔
1. Control:控制每一次修改
此階段要探討的問題是最具有明確正確與否的,例如:該如何復原寫壞的 code / func 呼叫方式是否正確 / 格式是否錯誤 / 文件是否存在矛盾 ...
撇除風格與設計,這些問題都存在明確的對錯。
既然有明確的對錯,就能寫成規則交給工具。透過強硬的 harness,用規則與預定義的手段(rule-base)去審閱 AI 完成的 code:人不需要每次都盯著,AI 也能自己跑檢查、看結果、再自己修正。
會用到的工具大家應該多少都聽過:Git 負責看見 AI 改了什麼、出問題時能退回;formatter、linter、type checker 與 test 負責檢查;CI 則讓這些檢查繞不過去。最後,文件負責補上 code 本身交代不了的資訊。
2. Contain:把修改圈在 boundary 裡
通過檢查的 code,不代表它好改。當專案大到無法一次讀完,此階段要探討的是:如何讓一次修改需要理解與影響的範圍,盡量停在 boundary 裡。
這裡的約束就沒那麼硬了。boundary 該怎麼劃,沒辦法完全寫成規則,需要人來決定;但劃好之後,有一部分仍然可以交給工具幫忙守住。
會談到 boundary、contract、abstraction、dependency、side effect 與 module 這些概念。
3. Choose:面對變動,決定成本付在哪裡
最後這個階段幾乎沒有標準答案。未來的需求無法預測,此階段要探討的是:boundary 該放在哪裡,又值得為還沒發生的變動先付出多少成本。
這部分沒有工具能替我們判斷,只能靠人做取捨,或是與 AI 一起討論。而 AI 讓多寫一層抽象變得很便宜,反而更容易過度設計。
會談到 cohesion、information hiding、DRY、OCP 與 YAGNI 等設計原則,但它們比較像是幫忙判斷的參考,該不該用還是得看情況。
三個階段都談完之後,最後再把它們整合起來,看看與 AI 合作時,這些方法如何一起發揮作用。
明天先從最基本的一步開始:用 Git 看見 AI 改了什麼。


 iThome鐵人賽
 看影片追技術