
數事環就是一個以數述事的驗證閉環:以數填單→聚單成表→用表製圖→而後以圖敘事→最後用數字來證明所言非虛。
這整個循環過程最重要的就是證據力的信度,如果源頭的數字是錯的,那麼整個循環就只是一場鬧劇,而最終決策錯誤要付出的代價超乎想像。
要讓過程可信就要談【核】,但要讓資料可信,就得談【稽】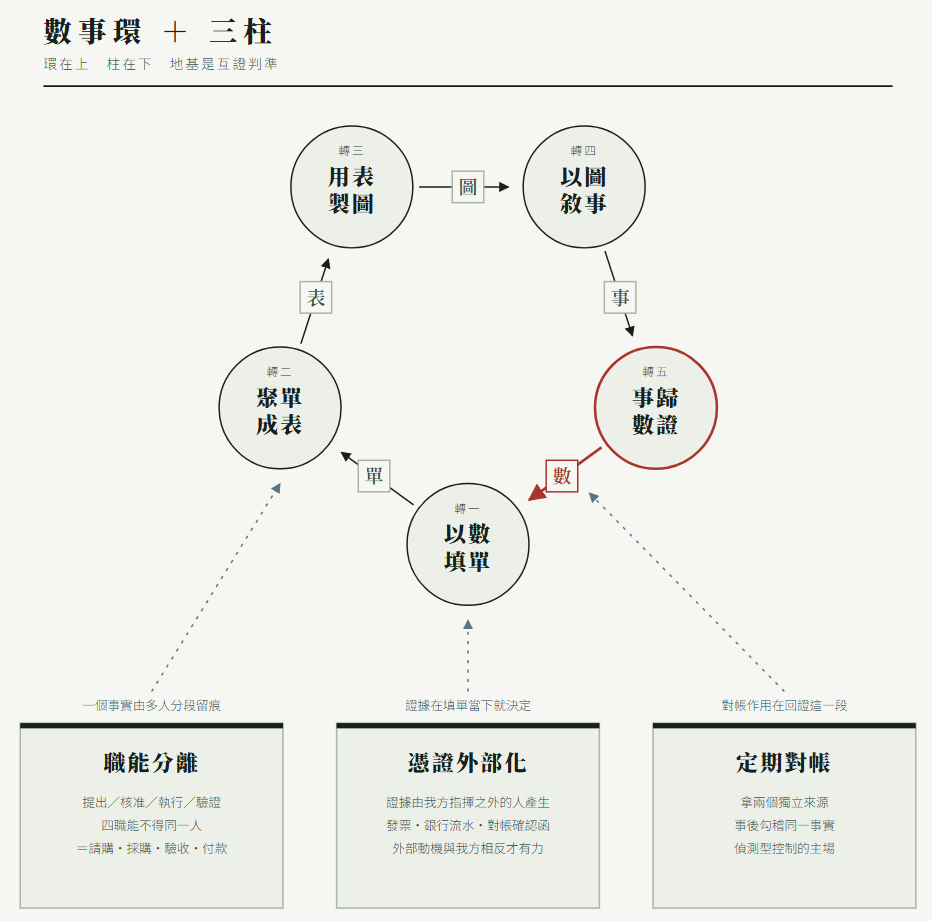
此圖為數事環加上三個控制,先用最敏感的帳務來說明更有感,常見的請-採-驗不該是同一人,雖然也常見被曲解為「 我(請購人)最清楚我要的是什麼,為什麼要給外行人驗收? 」或「 採購是外行人怎麼知道我要什麼,防火牆買了缺模組缺憑證缺服務,保固從3年變1年,上課點數全沒了 」這世界更複雜了,確實早年單純的付錢買貨那套得改,但又沒人說得出怎麼改(每個組織都有自己的玩法)。
以及更常見的採購140萬的設備但單筆超過50萬就得簽更高一層,於是化整為零拆單成三張47萬闖關。以多報少以少報多這些數字遊戲的個個是人精,但內稽外核+外稽內核混用還是能做到相當的防弊。
【核】與【稽】的差別在十六相位階表已下判詞,核是確保過程不易+防偽,但絕對難以防弊,這時稽察者的經驗就非常重要,現在切入資安視角來看同一張資安報表被能怎麼解讀(此處是示範,真正的資安報表不該如此簡陋,AI說它有超過30種以上的合理解讀,在此不提)
以下用同一張資產逐年發生的事件統計表做六種不同且矛盾的解讀,每一種貌似很有理很正確,資安江湖走馬,不通門道很容易被唬過去啊,而資安報表理解錯的後果各位都清楚。
讀法 1|逐欄直讀(period trend)
固定「資產年齡」不動,只沿著年度往下看。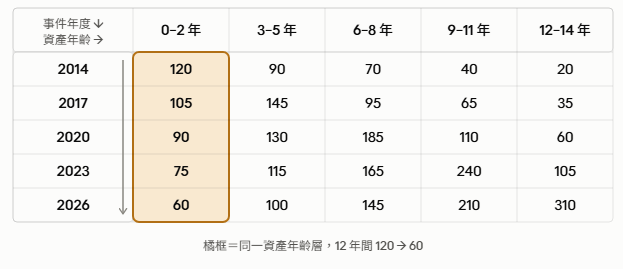
結論:「新資產的事件數腰斬,防護有效」。這是最常被放進管理層簡報的一條線,也是最容易被剪裁的一條——它只看得到一欄,其餘 20 格全被丟掉。
甚至還可能被解讀為「公司的資安防禦能力持續改善。(所以請提升經費換新,唉呀)」
讀法 2|逐列橫讀(cross-sectional age profile)
固定年度不動,只看某一年內不同帳齡的分佈。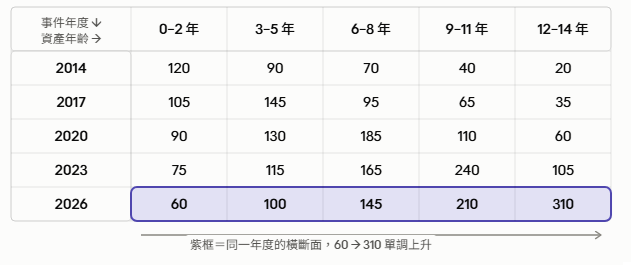
結論:「資產愈老愈危險,老舊資產是主要風險來源」。注意它和讀法 1 的方向完全垂直,結論也完全相反——但兩者用的是同一張表、同一批數字,而且各自內部都毫無矛盾。
但也可能是:
讀法 3|主對角線(cohort / vintage)
「斜著看」2014 年那批 0–2 年的資產,到 2017 年就變成 3–5 年,到 2026 年就是 12–14 年。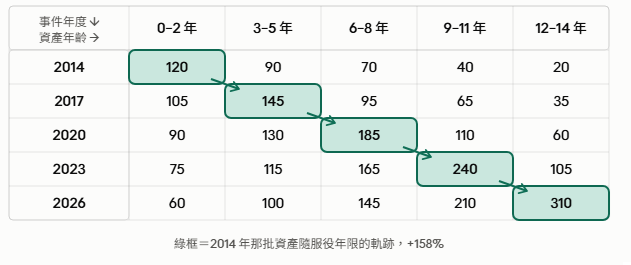
結論:「同一批資產隨服役年限持續劣化」。這條線最有說服力,因為它宣稱追蹤的是「同一群體」——但這個宣稱本身需要另外證明,表格自己證明不了。
這時得到的很可能只是一個避責的藉口:
不是「2026 年資安環境突然惡化」,而是某一批歷史設備逐漸成為高風險資產,所以應該換掉那批設備,給錢!(伸手
表上無法呈現的如果因為設備母數可能不同。
真正應該補:
指標:用途
該 cohort 尚存設備數:排除設備淘汰影響
Events / 100 assets:標準化事件率
Critical vulnerabilities / asset:看暴露程度
EDR / Patch coverage:看控制措施
Internet-facing 比率:看攻擊面
OS / firmware 世代:解釋技術債
例如:
310 件事件 / 10,000 台設備
跟
240 件事件 / 2,000 台設備
其實後者風險高很多,但直觀上是相反。
讀法 4|反對角線(偽世代,pseudo-cohort)
同樣是斜著看,只是方向相反。視覺上一樣工整,數字還呈現漂亮的倒 U 型。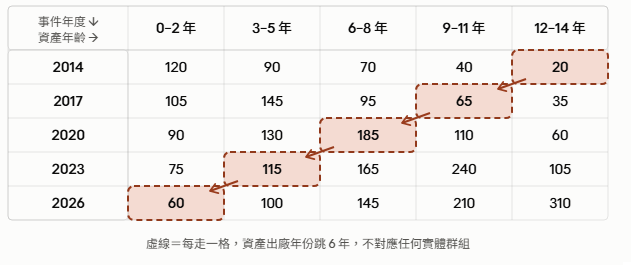
結論:「6–8 年是風險甜蜜點」。這條線在視覺上和讀法 3 完全對稱,同樣工整,同樣有「走勢」——但它每走一格,資產的出廠年份就跳動 6 年,所以它追蹤的不是任何一群真實存在的資產。斜向讀法看起來合理,不代表斜向的方向可以隨便選。
讀法 5|邊際合計(marginal totals)
不看內部結構,只看列和與欄和。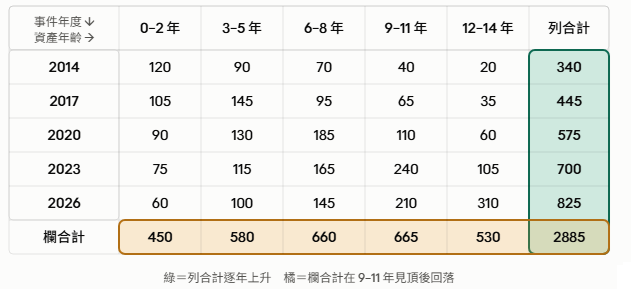
結論:兩個。「總事件量逐年上升」(右側綠色),以及「12–14 年的資產反而比 9–11 年安全」(下方橘色)。後者是右截斷造成的假象——只有 2026 那一列觀測得到 12–14 年,其他四列的高值世代根本還沒走到那一格。
讀法 6|整面熱區(surface / ridge reading)
不追任何一條線,直接看數值的濃淡分佈與峰線位置。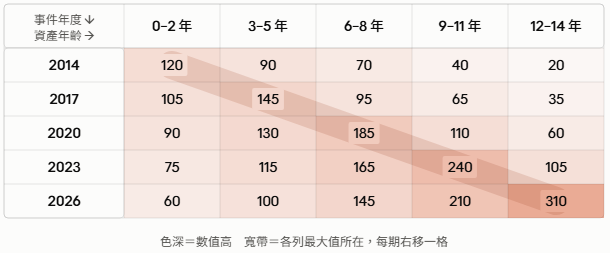
結論:「風險高峰正以每期一格的速度向右下推進」。這是六種讀法中唯一不預先挑定方向的,但代價是它只描述現象、不給因果——而簡報最後一頁通常要的就是因果。
對這表有興趣可搜尋:Age–Period–Cohort (APC) table、年齡—時期—世代分析表
同樣的格子,換一個分母或單位就是另一套結論:
1.絕對次數(原表)
2.率:事件數 ÷ 該格資產台數(缺分母是這張表最大的空洞)
3.佔比:格內值 ÷ 列總和(組成結構)
4.成長率 / 指數化(以 2014=100 或以各世代首格=100)
所以可以得到6 × 4 = 24 種彼此內部一致、但結論互相矛盾的敘事。
然後來抄貼一段AI說得比我清楚的清單:
常見謬誤(12 類,每一筆都可獨立當一堂課)
1.APC 不可識別性(identification problem)——年齡 + 時期 − 世代恆為常數,三者線性相依。這是數學事實:單憑這張表,年齡效應、時期效應、世代效應的線性成分無解,只能識別曲率。任何宣稱「主因是資產老化」的結論都是外加假設的產物。
2.分母遺漏 / base rate neglect——2014 年可能只有 200 台新資產、2026 年有 5,000 台;0–2 欄的下降完全可能是率的大幅上升。
3.偵測偏誤(detection / ascertainment bias)——2014 年沒有 EDR、沒有集中 log,2026 年有。事件數上升可能只是能見度上升。
4.倖存者偏誤(survivorship bias)——能活到 12–14 年的資產是被刻意保留的特例(通常是不能停機、不能打補丁的系統),本身就是選擇後的樣本。
5.定義漂移(definitional drift / non-comparability)——12 年間「事件」的判定門檻、嚴重度分級、CVSS 版本都變過,縱向不可比。
6.反向因果——不是資產變老所以出事,而是常出事的資產被列管、被保留、被持續掃描。
7.Simpson's paradox——分層(依部門、依資產類型)後每一層趨勢可能全部反轉。
8.生態謬誤(ecological fallacy)——用格子的群體平均去推論單一資產的風險。
9.分組假象(binning artifact)——列是 3 年一格、欄是 3 年一組,對角線才「剛好」對齊。改成 5 年分組,對角線敘事立刻消失。這是可操作的展示:同一份原始資料換分組=換結論。
10.視覺引導(highlighting bias)——這張表的粗體恰好就是對角線,等於替讀者預先選好了結論。做報表的人已經在替決策者作答。
11.德州神槍手(Texas sharpshooter)——先看到反對角線的倒 U,再回頭編一個「6–8 年是風險甜蜜點」的理由。
12.外推(extrapolation)——由對角線推「2029 年將達 400 件」,忽略該世代的資產屆時多已汰換。
那麼,除了依靠經驗,還能怎麼防弊端呢?
在ISO 27001 的核心精神「以風險管理為基礎,確保資訊的 CIA 三要素」就已經明白揭示,而其中很大的成份是INFRA功底是否紮實,資產管理有沒有及格,這時代如果還在人工盤點+Excel記錄是極度不合時宜的,資產不清,資安人員難以判斷誰是誰,正常不正常,這種企業依然可見,很危險包難做啊!其實用GPO放個PS出去就能做到的事情卻還是(無言)。
字太多了收尾。下一篇開始正式進入實戰,將安裝防禦主機與管制主機,實際建置一個大型SOC。本系列文章提到的BeakPlatform在行政運作中擔任【核】,設計工具則能把【稽】的作用自動化與AI化補人員經驗缺失。


 iThome鐵人賽
 看影片追技術