
在開始前,先說明一下有幾種不同類型的資料收集,完全取決你的資料來源
釐清後,就交給AI 幫你生成後續爬行行為,但必須注意,每次測試都必要要求AI 有過程產出。這裡的測試會需要熟悉html語法跟python,所以在每次要求gemini,chatGPT時,最好都能保有輸出,方便檢核錯誤。
下圖為GitHub Actions執行時,擷取RUN狀態的過程示範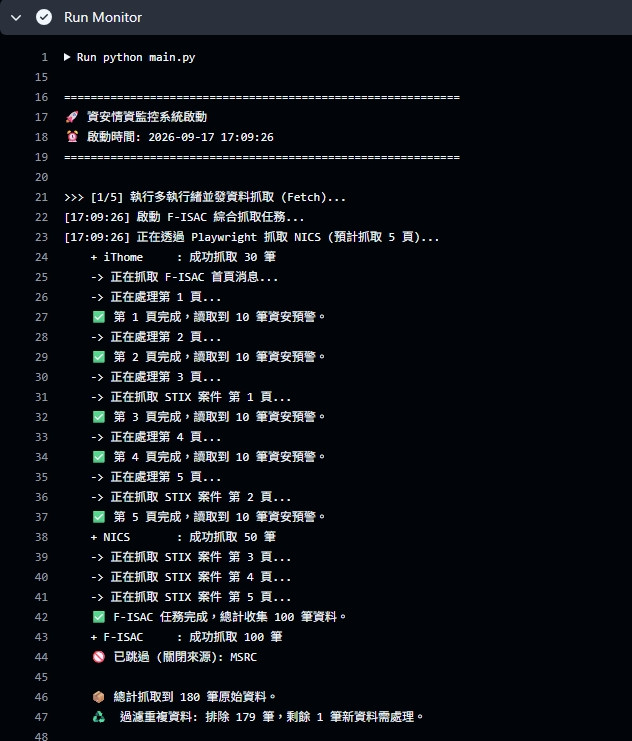
fetchers.py 爬蟲模組解析這支程式的主要任務是擔任「情報收集」,負責前往不同的資安網站與 RSS 來源,把最新的漏洞資訊與新聞抓回來,並整理成統一的格式交給主程式處理。
整支程式採用了「模組化」與「功能獨立」的設計方式,主要由四個獨立的抓取函式(Functions)構成:
fetch_msrc_updates():負責抓取微軟 (MSRC) 的漏洞安全更新 RSS。fetch_rss_news():負責抓取 iThome 的資安與一般新聞 RSS。fetch_fisac_news():負責抓取金融資安資訊分享與分析中心 (F-ISAC) 的首頁消息與 STIX 案件查詢系統。fetch_nics_news():負責抓取國家資通安全研究院 (NICS) 的漏洞預警公告。source(來源)、title(標題)、url(網址)、summary(摘要)與 raw_time(抓取時間)的字典列表 (List of Dictionaries),方便後續主程式進行標準化處理。要讓這支程式順利運行,你的環境必須滿足以下條件:
requests (發送 HTTP 請求)、feedparser (解析 RSS 格式)、beautifulsoup4 (解析 HTML 結構) 以及 playwright (模擬瀏覽器行為)。config.py):程式開頭引入了 config 模組,你的專案目錄下必須有這個檔案,並且裡面需要設定好 HTTP_TIMEOUT(連線超時時間)與 TZ(時區設定)這兩個變數。這份程式最大的亮點,在於針對不同特性的網站,採用了不同的「戰術(抓取邏輯)」:
requests 與 feedparser 來抓取,節省系統資源。playwright 啟動無頭瀏覽器 (Headless Browser) 來模擬真人讀取。&page=1 到 &page=5 來實現前 5 頁的案件抓取。page.get_by_role("button", name=str(page_num)) 的方式,模擬滑鼠點擊分頁按鈕來切換頁面。seen_urls 或 seen_in_batch 這種 set() (集合) 資料型態。在爬取當下就會檢查網址是否重複,確保回傳的資料清單不會有冗餘。這支程式在防呆與穩定性上做了很多細節處理,在維護時需特別留意:
user_agent,把自己偽裝成 Windows 系統下的 Chrome 瀏覽器,這是為了避免被目標網站的 WAF (網站應用程式防火牆) 阻擋。try-except 區塊中。這意味著如果今天 F-ISAC 網站掛了,程式只會印出「抓取失敗」的錯誤訊息,但不會導致整支程式崩潰,其他來源 (如 NICS、MSRC) 依然可以順利完成任務。wait_until="networkidle"(等待網路請求靜止)、page.wait_for_timeout(2000)(強制緩衝 2 秒)以及 page.wait_for_selector(確保特定元素出現)等語法,這些都是為了解決抓到「空殼網頁」的關鍵設定。headless=True,這代表它在執行時不會彈出真實的瀏覽器視窗,這對於要部署到 GitHub Actions 或 Linux 伺服器上自動排程執行是絕對必要的設定。下面是我一部分的資料
# fetchers.py
import requests
import feedparser
import urllib.parse
import re
from bs4 import BeautifulSoup
from playwright.sync_api import sync_playwright
from config import HTTP_TIMEOUT, TZ
from datetime import datetime

def fetch_msrc_updates():
    """抓取 MSRC RSS"""
    items = []
    rss_url = "https://api.msrc.microsoft.com/update-guide/rss"
    try:
        print(f"[{datetime.now(TZ).strftime('%H:%M:%S')}] 正在抓取 MSRC RSS...")
        response = requests.get(rss_url, timeout=HTTP_TIMEOUT)
        if response.status_code == 200:
            feed = feedparser.parse(response.content)
            for entry in feed.entries:
                title = entry.title
                cve_match = re.search(r'CVE-\d{4}-\d+', title)
                cve_id = cve_match.group(0) if cve_match else "N/A"
                url = f"https://msrc.microsoft.com/update-guide/vulnerability/{cve_id}"
                items.append({
                    "source": "MSRC",
                    "title": title,
                    "url": url,
                    "summary": entry.get('summary', '')[:500],
                    "raw_time": datetime.now(TZ).strftime('%Y-%m-%d %H:%M:%S')
                })
    except Exception as e:
        print(f"MSRC 抓取失敗: {e}")
    return items

def fetch_rss_news():
    """抓取 iThome 資安新聞"""
    items = []
    seen_urls = set()
    feeds = [("iThome資安", "https://www.ithome.com.tw/rss/news/security"),
             ("iThome新聞", "https://www.ithome.com.tw/rss")
    ]
    for name, url in feeds:
        try:
            feed = feedparser.parse(url)
            for entry in feed.entries[:1000]:
                link = entry.link

                if link not in seen_urls:
                    items.append({
                        "source": name,
                        "title": entry.title,
                        "url": link,
                        "summary": entry.get('summary', '')[:250],
                        "raw_time": datetime.now(TZ).strftime('%Y-%m-%d %H:%M:%S')
                    })
                seen_urls.add(link)
        except Exception as e:
            print(f"{name} 抓取失敗: {e}")
    return items


 iThome鐵人賽
 看影片追技術