
在前幾天的實作中,我們已經成功透過 fetchers.py 多型態爬蟲抓取了四面八方的原始情資。然而,未經篩選的情報往往伴隨著大量的雜訊。本篇將進入「情資清洗與正規化」的關鍵階段,深入探討 processor.py 如何擔任系統的決策大腦,將雜亂無章的資料轉化為可 actionable 的威脅預警。
在軟體工程與自動化管線的設計中,保持程式碼的整潔與可維護性至關重要。processor.py 的設計徹底落實了「配置與邏輯分離(Decoupling)」的理念。
keywords.py 中。processor.py 則專注於執行「分析」與「評估」的運算邏輯。當未來出現新型態威脅時,維護人員無需更動此處理器的底層程式碼,只需更新關鍵字字典即可。processor.py 採用了「威脅技術分(Threat Score)」與「目標資產(Asset)」的交叉評估模型(維度:威脅技術分 x 目標資產)。這種標靶式的情境收斂機制,能有效過濾雜訊,防止防守方陷入警報疲勞。processor.py 主要由以下幾個核心函式構成,逐步對原始內容進行清洗與標記:
**1. 精準字詞比對:match_keyword**
面對不同的語系與關鍵字特性,必須採取不同的比對策略。此函式會判斷輸入的關鍵字是否為英數字詞彙,若是,則透過正規表示式要求「單字邊界(Word Boundary)」,避免將 salesforce 誤判為 rce,或將 broadcast 誤判為 ad。若是中文詞彙,則維持子字串比對。
**2. 量化風險評分:evaluate_threat_score**
將文字描述的威脅轉化為可運算的數值是預警系統的靈魂。此函式會遍歷 IMPORTANCE_WEIGHTS 字典,比對內容中是否包含特定等級的攻擊特徵。若命中,則賦予對應的最高風險分數(例如 T1 級別的 0-day 漏洞賦予 10 分)。
**3. 資產命中檢測:detect_device_match**
此函式負責檢查情報內容是否命中了 CRITICAL_EQUIPMENT 中定義的關鍵設備或廠牌。除了回傳命中的設備名稱,還會進一步檢查是否同時命中了 EQUIPMENT_CRITICAL_THREATS 中針對該設備的高危詞彙,為後續的決策樹提供關鍵判斷依據。
**4. 核心決策與標籤分流:process_item_logic**
這是整個檔案中最核心的決策引擎。它整合了上述所有的運算結果,並依據嚴密的決策樹判定最終的標籤與發布狀態:
🔥高分警示,並強制發送通知。⚡重大漏洞 並發送警報。📦MSRC/備查,且設定 should_send = False,僅進行存檔而不發送即時通知,避免過度干擾。processor.py 嚴謹的邏輯與多維度的風險評分矩陣,我們的系統得以精準萃取具備高衝擊性的威脅指標,大幅提升了數位鑑識與事件回應的效率。

英數字用單字邊界、中文用子字串,再把 Threat Score 與關鍵資產交叉判斷,這個分層很實用。規則久了最怕關鍵字漂移;你會怎麼留下誤報與漏報樣本,定期回頭調整 IMPORTANCE_WEIGHTS 和各層門檻?

在爬蟲每一次獲取資料時,常陷入依賴靜態規則資料正確性的問題;然而,面對持續演進的環境,整套機制必須在確定性(deterministic)與機率性(probabilistic)的評估中取得平衡。針對關鍵字漂移與誤報漏報的生命週期管理,我們透過以下三個核心機制進行動態權衡與調整:
一、 建立黃金資料集(Golden Dataset)與情境脈絡保存
檢視來源資料時,確認事件為誤報(False Positive, FP)或漏報(False Negative, FN)時,必須於情資平台進行標籤化管理。我們要求確實盤點並封存觸發時的原始日誌與規則版本,同時記錄導致誤判的環境變數(如業務邏輯變更);此舉能有效隔離雜訊,並為後續門檻調校提供精確的對照基準。
last_seen.json 最後收集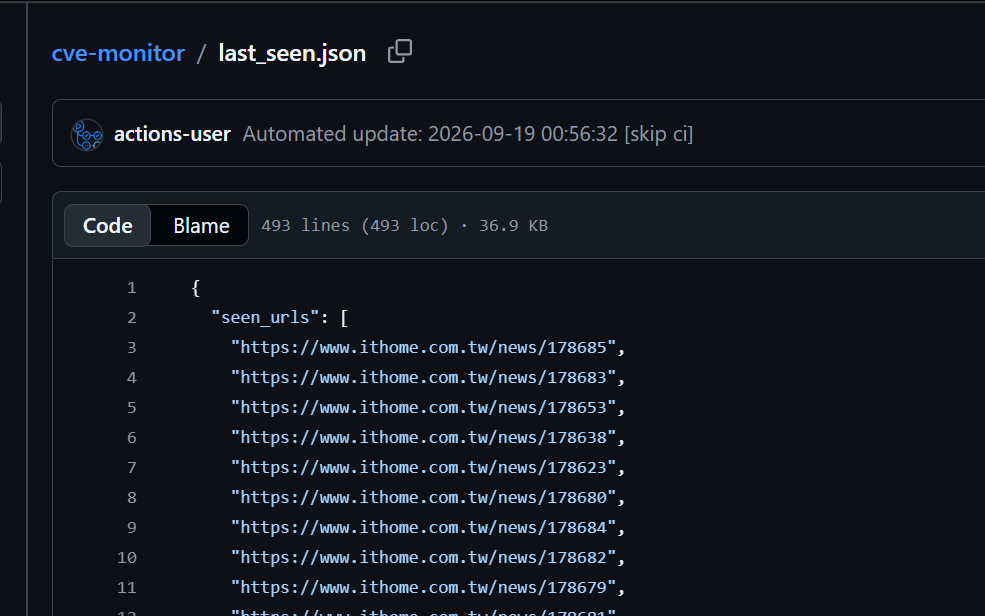
alert_history.log 最後發送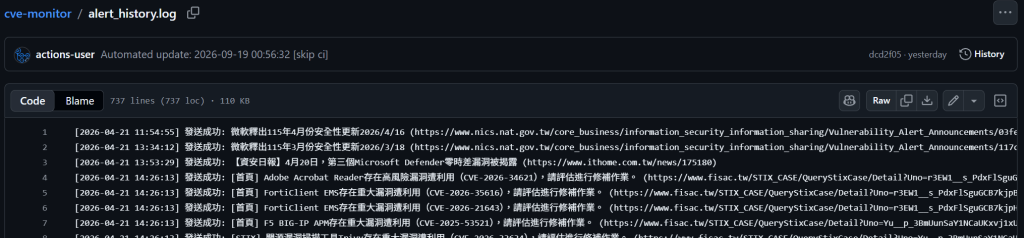
二、 導入命中率監控與衰退機制(Decay Mechanism)
為防範關鍵字漂移,我們不應等待規則失效才被動修補,而是主動稽核各層規則的觸發頻率與雜訊比。針對高度依賴字串比對的規則,系統應引入時間衰減參數(architectural debt)。
三、 透過影子模式(Shadow Mode)與關鍵資產動態聯動
在正式調整 IMPORTANCE_WEIGHTS 與各層門檻前,所有新權重必須佈署於影子模式下,並利用黃金資料集進行歷史回放測試。同時,威脅分數的加乘必須與企業的組態管理資料庫(Configuration Management Database, CMDB)定期聯動。
好詳細的解說,我懂了,非常感謝~~

 iThome鐵人賽
 看影片追技術