
還記得我們昨天說得 Attention 跟 KV Cache,目的是為了解決 Context 越長,推論成本越高 的問題。今天要談另一個在LLM上一個更直接的問題,也就是Context Window 本身就是一個固定大小的容器,而你想塞進去的東西,永遠比容器大。
你可能會覺得 Context Window 不夠?那就換一個支援更長 Context 的模型,或者從一開始訓練模型時,就直接使用更大的 Context Window 不就解決了嗎? 這方向其實不能說錯的,但會發生兩個更根本的問題。
第一個問題就是就是昨天提到的Attention 的計算複雜度會隨著序列長度快速增加,所以就算使用了 KV Cache 技術記憶體需求也會隨著序列長度增加, KV Cache 只是一個優化的方案而不是從根本上解決問題。
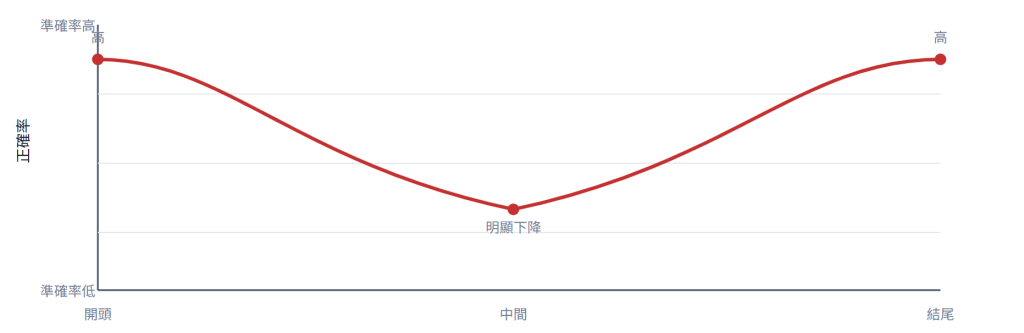
第二個問題其實更麻煩因為**就算容量塞得下,模型也不一定真的注意到相關資訊。**這裡就要提一個很有名的現象,叫做 Lost in the Middle[1],這一個研究發現了當關鍵資訊被放在 Context 的中間位置時,模型取用這些資訊的準確率可能會明顯下降,相較之下,放在開頭或結尾附近的內容,通常更容易被模型利用。
[1] Lost in the Middle paper: https://direct.mit.edu/tacl/article/doi/10.1162/tacl_a_00638/119630/Lost-in-the-Middle-How-Language-Models-Use-Long
所以當Context Window 變長時雖然能把更多資訊放進去,但它沒有直接解決模型能不能在這麼多資訊裡,找到真正重要的內容的狀況。
而在一個 Agent 在執行任務的過程中,通常不會只有我們使用者的輸入與模型回復,通常還會有System Prompt(角色設定、行為規則)、對話歷史(使用者說過什麼、Agent 回應過什麼)、工具呼叫結果(API 回傳、檔案內容、搜尋結果),只要任何需要補充的資料都要在這個 Context Window 中。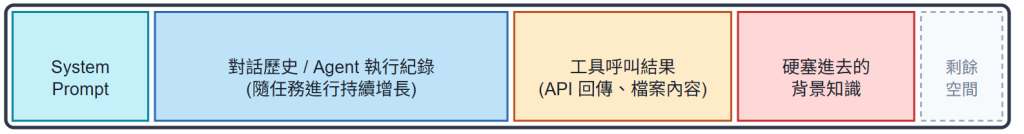
這時候你會發現, 只要把這些資訊全部塞進去,Context Window 很快就會爆掉。 畢竟參考文件可能是一份完整的技術文件、一整套 FAQ,甚至是公司內部的整個知識庫。如果每次都想把相關知識全部塞進一格 Context 中,基本上模型會直接停機給你看。
所以當你真正開始開發 Agent就會發現這其實已經不只是 Prompt 寫得好不好的問題,而是 Context Window 本身就是一個有限的資源。你可以把內容寫得更精簡、更有效率,甚至透過 Prompt 壓縮減少 Token,但不可能只靠不斷壓縮文字,就讓它無限裝進更多資訊。
對於這個問題,目前有兩種很常見的解法,而且在實際的 Agent 系統中,這兩種做法通常不是二選一,而是搭配在一起運作的。
第一種做法,就是昨天提到的將任務拆分給多個 Sub-agent,讓 Planner、Executor、Reviewer 各自維護相對精簡的 Context,而不是把所有資訊都堆在同一個、只會不斷膨脹的對話歷史中。這樣可以有效降低單一 Agent 的 Context 過度膨脹問題,讓每個 Agent 只專注在自己負責的任務與所需資訊上。
第二種做法,則是讓知識需要時再取得,而不是預先全部塞進 Context。核心概念是知識不應該被大量塞進 Context,而應該在 Agent 真正需要的時候,從外部知識庫中動態檢索出來,這就是我們經常聽到的 RAG(Retrieval-Augmented Generation,檢索增強生成)。
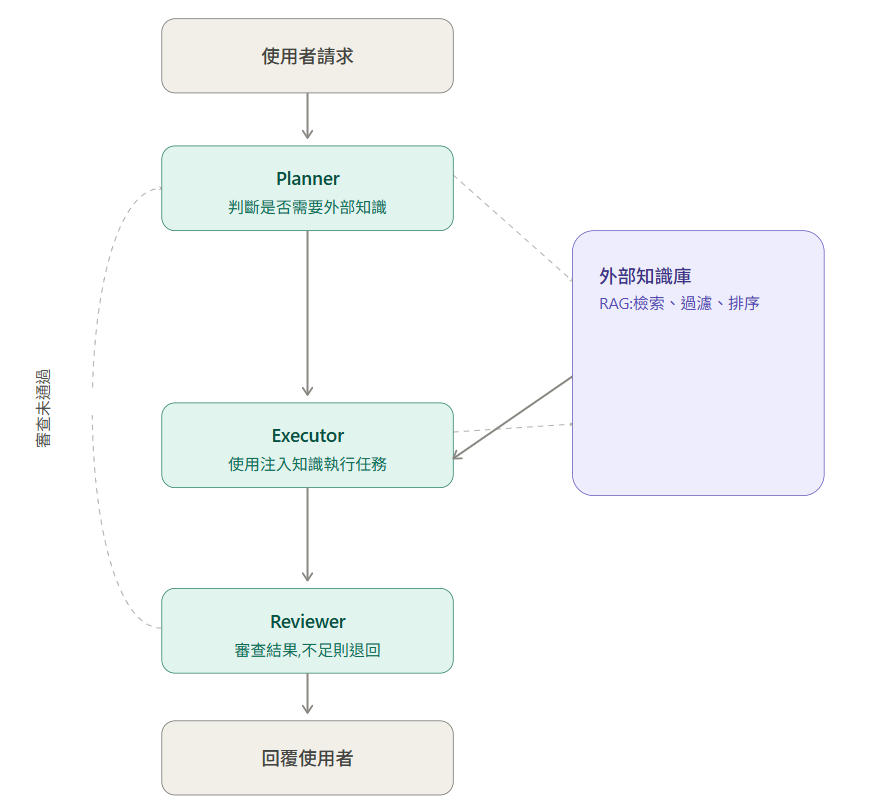
而這兩者在系統裡實際上是這樣互動的,Planner 拿到任務後,除了規劃步驟,還會判斷這次任務是否需要外部知識;如果需要就會向 RAG 發出查詢。RAG 檢索到的內容不是回給 Planner 自己用,而是經過整理、過濾、排序後,直接注入到真正要執行任務的 Executor 的 Context 中。Executor 也不是只能被動等 Planner 餵資料,當執行過程中如果發現資訊不夠,可以直接再向 RAG 查詢補充,不必每次都繞回 Planner,最後由 Reviewer 審查結果,如果不夠完整,就退回給 Planner 重新規劃,形成一個可以反覆修正的迴路。
簡單來說 Multi-agent 負責讓每個角色的 Context 保持精簡;RAG 負責讓知識不是被硬塞進系統,而是按需求動態取用。
今天我們主要是要讓你知道,Context Window 不是一個換成更大的模型就能解決的問題,它同時受到計算成本、Context 長度,以及長 Context 下的資訊利用效率等因素限制,導致它需要更好的設計與調整。這也代表,Context Window 進行短期工作記憶,其餘的資訊則需要通過外部可變動的資料進行補充與上下文推理,才能得到更好的結果。
因此明天我們要來談 Sampling,也就是模型在「選擇下一個 Token」時,究竟是如何決定要選哪一個 Token。這件事情會直接影響 Agent 在呼叫工具時的穩定性。如果你的 Agent 常常把工具參數格式寫錯,甚至明明知道該怎麼呼叫工具,實際執行時卻還是產生錯誤,那麼答案很可能就藏在 Sampling 裡。
那我們明天見!


 iThome鐵人賽
 看影片追技術