
昨天我們把 BM25 接上來湊成混合檢索,也開始了 RRF的動作,但 top_k=3 還是會導致加入太多無用的資訊,就算前面只有一塊真的相關,另外兩塊不相干的內容照樣會被塞進 Prompt,一邊吃掉 Context Window,一邊增加模型被帶偏的機會。
所以今天我們將要來補上 RAG 的最後一段,也就是 Reranking,用 Cross-Encoder 把檢索回來的候選重新打一次分數,順便拿這個分數來決定到底要塞幾塊進 Prompt。
這篇的完整程式碼一樣會放在 GitHub repo:https://github.com/AUSTIN2526/30-days-ironman-agent,可以直接下載下來執行。
我們從 Day 7 用到現在的 Embedding 模型,正式名稱叫 Bi-Encoder,意思是問題和文件各自走自己的路,分別被編碼成向量,最後才拿兩個向量來比距離。
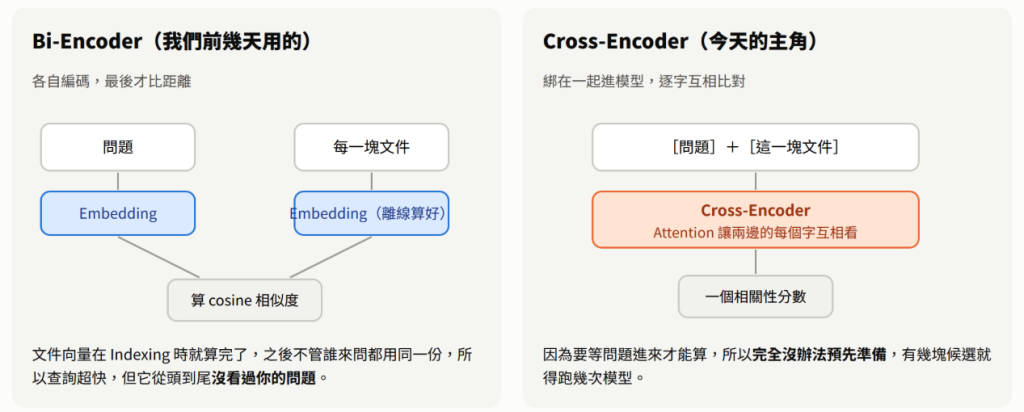
這種設計最大的好處是文件向量可以在 Indexing 的時候就先算好,之後不管誰來問都用同一份,所以查詢才能快到零點幾毫秒,但問題也在這裡,因為那份文件向量是在完全沒看過你的問題的情況下算出來的,它只能盡量把整塊內容的意思壓縮成一個向量,至於你問的是哪個細節,它其實無從得知。
Cross-Encoder 走的用另一種方式,它把問題和文件綁成一對,一起丟進模型讓 Attention 在兩邊的每個字之間互相比對,最後直接吐出一個相關性分數,既然比較準,直覺上當然會想說那就全部都用 Cross-Encoder 就好了,但它有個致命傷,就是沒辦法預先算。文件向量可以離線算好存起來,但 Cross-Encoder 的分數一定要等問題進來才能算,而且有幾塊候選就得跑幾次模型。
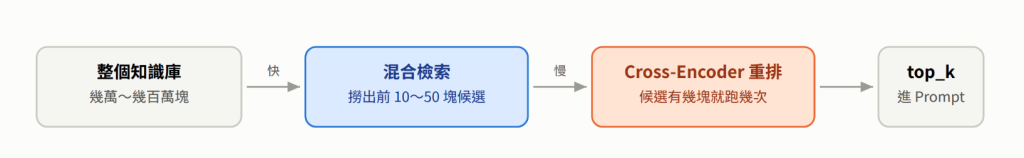
像是今天用的 bge-reranker-base 來說,它是 278M 參數的模型,等於每一塊候選都要跑一次這種等級的前向傳播,這個系統基本上可以直接關掉了,所以實務上都是做成兩段式。
第一段用便宜的檢索把範圍縮到幾十塊,第二段才讓 Cross-Encoder 在這幾十塊裡面仔細排,這裡有個重點是第一段要的是廣度而不是精度,因為重排只能在候選名單裡面挑,正解如果一開始就沒被撈進來,後面再厲害也沒用。
這次的程式其實很短,因為第一段的檢索昨天已經寫好了,今天只是多接一段:
# rerank.py
from sentence_transformers import CrossEncoder

# 直接沿用 Day 11 的混合檢索,今天只多接一段重排
sys.path.append(str(Path(__file__).resolve().parent.parent / "day11-hybrid"))
from compare import chunks, dense_rank, rrf, sparse_rank
from test_cases import test_cases

reranker = CrossEncoder("BAAI/bge-reranker-base", max_length=512)


def retrieve(query: str, n_candidates: int) -> list[int]:
    """第一段:用昨天的混合檢索撈出候選名單。"""
    return rrf([dense_rank(query), sparse_rank(query)], pool=3)[:n_candidates]


def rerank(query: str, candidates: list[int], top_k: int = 3,
           threshold: float | None = None) -> list[tuple[int, float]]:
    """第二段:把問題和每一塊候選綁成一對丟進 Cross-Encoder 重新打分。"""
    pairs = [[query, chunks[i]] for i in candidates]
    scores = reranker.predict(pairs)                      # 未正規化分數,越高越相關
    ranked = sorted(zip(candidates, scores), key=lambda x: -x[1])
    if threshold is not None:
        ranked = [(i, s) for i, s in ranked if s >= threshold]   # 不夠格的直接丟掉
    return ranked[:top_k]
注意 pairs 的格式是 [問題, 文件] 成對丟進去,這跟前幾天 model.encode(chunks) 一次編一整批文件完全不同。
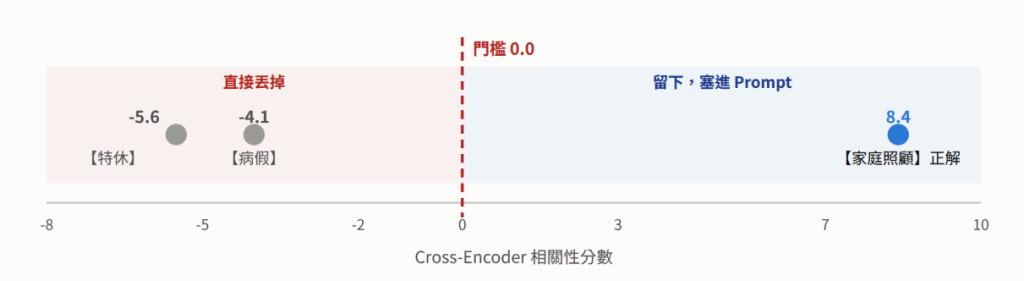
另外 predict() 吐出來的分數要特別注意,因為它到底有沒有被正規化,取決於你用哪個介面。sentence-transformers 的 CrossEncoder 在模型只有一個輸出時,預設會幫你套上 sigmoid,所以分數會乖乖落在 0 到 1 之間;但如果你改用 FlagEmbedding 的 FlagReranker,拿到的就是原始 logits,可能是 8.4,也可能是 -5.6。
現在有了計算分數之後,我們終於可以設定一個門檻來過濾資料了,以前我們只有排名,沒辦法知道第三名到底是真的相關還是硬湊的,但現在可以直接設一條線,低於這個分數的就不要了:
for th in [0.0, 0.2, 0.4, 0.6]:
    kept = []
    for query, _ in test_cases:
        kept.append(len(rerank(query, retrieve(query, 10), top_k=3, threshold=th)))
    print(f"門檻 {th}:平均每題留下 {sum(kept) / len(kept):.2f} 塊(原本固定塞 3 塊)")
這裡真的要特別注意一點,門檻真的不能抄別人的數字正確的做法是先把自己的題目跑過一輪,把分數印出來看過再決定,像爸爸住院那題,四塊候選的分數分別是 0.43、0.32、0.05、0.00,正解 0.43 雖然排第一,但跟第二名的病假只差 0.11,門檻抓 0.4 剛好只留下正解,抓 0.2 就會連病假一起放進來,最後把有沒有重排、以及候選數要抓多少一起測一遍:
python rerank.py
重排效果比較表:
| 做法 | Hit@1 | Hit@3 | 每題耗時 |
|---|---|---|---|
| 只用混合檢索 | 86% | 95% | 3.6 ms |
| 混合檢索 + 重排(候選 5) | 95% | 95% | 20.0 ms |
| 混合檢索 + 重排(候選 10) | 95% | 95% | 19.7 ms |
| 混合檢索 + 重排(候選 13) | 95% | 95% | 20.0 ms |
這時你將會發現Hit@1 從 86% 拉到 95%21 題裡多答對兩題,而且這兩題本來就在前三名裡面,只是排在第二、第三,重排把它們拉到第一,這正是重排真正在做的事,它不負責把漏掉的東西找回來,只負責把已經撈進來的候選重新排好。
Hit@3 則完全沒動維持 95%,因為那唯一失手的題目是我想在家上班,它從第一段檢索就沒被撈進候選名單,重排再強也救不了。這也呼應前面說的,第一段要的是廣度,正解沒進候選就等於出局。
但是延遲的部分則是從 3.6 毫秒變成 20 毫秒左右,整整多了五倍以上,這就是重排的造成的效能代價,這裡可以注意到候選 5、10、13 三種設定幾乎沒有差別,那是因為我們的 chunk 都很短,13 塊一次批次就算完了,GPU 或 CPU 根本還沒吃飽。等到候選數拉到幾十上百塊、每塊又更長的時候,這個差距才會真正拉開,接著是門檻的部分,我把四個值都跑過一輪:
| 門檻 | 平均每題留下幾塊 |
|---|---|
| 0.0 | 3.00 塊(等於沒過濾) |
| 0.2 | 1.19 塊 |
| 0.4 | 1.00 塊 |
| 0.6 | 0.90 塊 |
可以看到光是把門檻從 0.0 拉到 0.2,平均塞進 Prompt 的內容就從 3 塊掉到 1.19 塊,等於有六成的內容本來就是硬湊的。但也要小心另一邊,門檻 0.6 時平均只剩 0.90 塊,代表已經有題目被砍到一塊都不剩,這種情況下模型會直接說查不到,明明資料就在知識庫裡。
所以門檻這個東西是拿 Prompt 的乾淨度去換召回率,抓太鬆等於沒設,抓太緊就會把正解也一起丟掉,以我們這份資料來說,0.2 到 0.4 之間是比較安全的區間。
到這裡 RAG 的所有概念基本上是學完了,從切塊、選模型、建索引、混合檢索一路到重排,每一段我們都自己用過一次了也實際看到了效能的增長。
所以明天開始要把這些東西收成一個能用的東西,也就是把整條流程包成一個可以被呼叫的工具,並且接回 Day 7 的生成那一段,讓它真的能回答問題,這也是為了後面的 Multi-Agent 做準備,因為對 Agent 來說,RAG 不過就是它手上眾多工具的其中一個,那我們明天再見!


 iThome鐵人賽
 看影片追技術