
昨天我們遇到一題需要先查資料、再算數字的題目,模型直接把年資三年當成 365 × 3,然後很有自信地告訴我一共有 1090 天。遇到這種狀況最直覺的做法當然是換模型。實際上換成 7B 或 14B,這題就過了,因為說到底這是主模型能力不足的問題。
但我不想只靠換模型解決問題,而是讓你知道該怎麼去設計一套更好的Tool流程,因為在真實專案裡模型很多時候不是你想換就能換,可能公司只給你這張顯卡,可能資料不能送出去、只能在本地端跑,也可能這是公司自製的模型,你只能硬著頭皮用。既然模型已經被規格綁死,我們能動的就只剩模型外面的東西。
所以今天先不換模型,看看同一個模型在不增加參數的情況下,到底能不能把這題救回來。
這篇的完整程式碼一樣會放在 GitHub repo:https://github.com/AUSTIN2526/30-days-ironman-agent,可以直接下載下來執行。
昨天那一題錯的不是格式,它輸出的 JSON 完全正常;也不是工具的問題,因為計算機本來就是它需要的工具之一。真正的問題是它把一個需要兩步驟的任務,硬是用一步解決掉了,換句話說壞掉的是「規劃」,而不是「執行」。
確定問題出在規劃之後,我先試了四種最常見的 Prompt 改法:
| 策略 | 加了什麼 | 想修的毛病 |
|---|---|---|
baseline |
什麼都沒加,就是昨天那版,只告訴它有哪些工具、JSON 要長什麼樣 | 拿來當對照組 |
react |
多一個 thought 欄位,逼它動手前先把理由寫出來 |
一開口就下決定,中間沒有任何緩衝 |
fewshot |
在 Prompt 裡示範一題兩步驟的完整過程,讓它照著抄 | 不知道多步驟的題目該長什麼樣 |
rules |
把昨天踩到的雷寫成三條白紙黑字的規定 | 該查手冊卻自己假設數字 |
這四種寫法都放在同一個 prompts.py 裡,等一下會讓它們用同一個模型跑同一組題目,這樣比出來的差異才真的是 Prompt 造成的:
# prompts.py
BASELINE = """你是一個公司內部助理。你可以使用下列工具:

{tool_list}

""" + TOOL_FORMAT            # 昨天的版本,什麼都沒特別交代

RULES = BASELINE + """

特別注意以下規則:
1. 只要問題牽涉到公司規定的數字,例如天數、金額、期限,一律先用 search_employee_handbook 查手冊,絕對不可以自己假設。
2. 年資三年指的是到職滿三年,不是 365 乘以 3 天,這種換算沒有意義。
3. 需要計算時,算式裡的數字必須來自工具查到的結果,不可以自己編。"""
看到 RULES 的第二條,你可能會覺得,都已經把答案寫出來了,怎麼可能還錯?但這其實就是實務上最常見的樣子。線上系統的 Prompt 幾乎都是這樣長出來的,每一條規則背後都對應著一次真實的客訴或翻車。
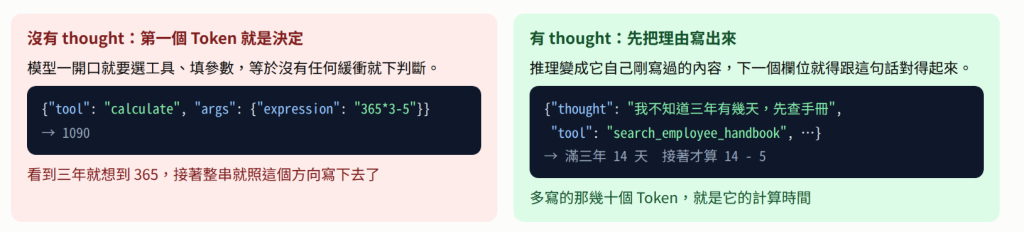
react 這個寫法值得多講一句。它的全名是 Reasoning and Acting,核心概念是不讓模型一開口就做決定,而是要求它每一步都先把想法寫進 thought 欄位再動手,背後的原理是模型沒有一個可以躲在背後默默思考的地方,它唯一的思考空間,就是它已經產生出來的文字,所以多寫一段推理,理論上後面的決定就會比較穩。
如果只看最後那句回答對不對,會漏掉一種很危險的狀況,也就是模型根本沒查手冊,只是自己講出一個剛好正確的數字,這種情況光看答案完全看不出問題。
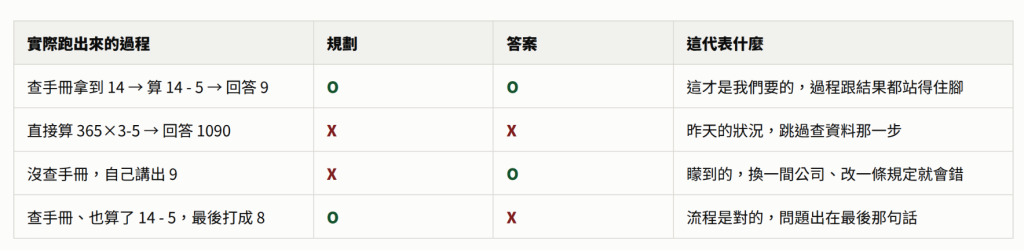
所以我把評分拆成兩欄,一欄檢查規劃,一欄檢查答案:
# cases.py
{
    "question": "我已經休了 5 天特休,年資三年還剩幾天?",
    "need_tools": ["search_employee_handbook", "calculate"],   # 要照這個順序出現
    "ban_args": ["365"],                          # 只要算式出現 365 就是自己編的
    "answer_has": ["9"],
},
準備好之後,直接跑一次看看結果:
python run.py
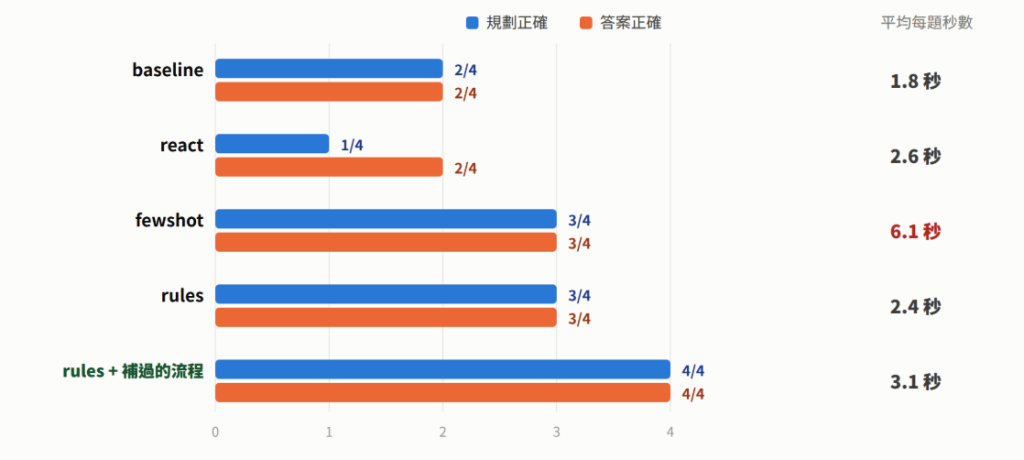
而從結果中可以發現最好的反而是最笨的那招,rules 只是把踩過的雷寫成三句白話規定,就拿到 3/4,而且速度幾乎沒變,這也說明了把規則直接寫進 Prompt,往往還是 CP 值最高的做法,反倒是最被看好的 ReAct 只拿到 1/4,比什麼都不加還差。各做法的失敗原因整理如下:
| 做法 | 失敗原因 |
|---|---|
react |
多了一個欄位要填之後,它乾脆不寫 JSON 了,整段變成純文字,程式一個工具都接不到 |
fewshot |
只學到範例的形狀,沒學到邏輯。明明只需要查手冊的題目也硬要算一次,還把手冊裡所有天數加起來,變成 49 |
rules |
最接近可用,第二題真的去查了手冊,但拿到 14 之後沒呼叫計算機,自己心算成 8 天 |
你可以發現模型會查手冊、會用計算機、也會照格式輸出,這三件事分開做都沒問題,但只要串成「先查再算」的兩步驟,就一定會在某個環節出錯,到這裡可以確定,光改 Prompt 這條路已經走不下去了。
這裡也要補充一個背景 1.5B 模型在處理較長的輸入時,比較容易出現資訊失真,所以像 Few-shot、ReAct 這類需要塞進大量上下文的做法,反而可能讓表現變差,因為他不會按照你的輸出格式回復,甚至會開始出現亂回答的景象。
這個問題在 7B、14B 等較大的模型上沒那麼明顯,之所以選 1.5B 當範例,是想讓你看到在模型小、上下文又長的限制下,還有哪些其他方法可以解決問題。
不過把這些輸出從頭讀過一遍之後我發現一件事不少失敗其實不是模型判斷錯,而是它想做的事,我們的程式接不到最明顯的就是 react 寫出來的這段:
thought: 首先,我要確認公司的年資計算方式和特休的使用規則。
tool: search_employee_han
你我都看得懂它要做什麼,就是要去查手冊,而且理由講得完全正確。是我們的 parse_tool_call 只認 JSON,才判了它死刑,既然問題出在我們的Tool,那就從我們這端修:
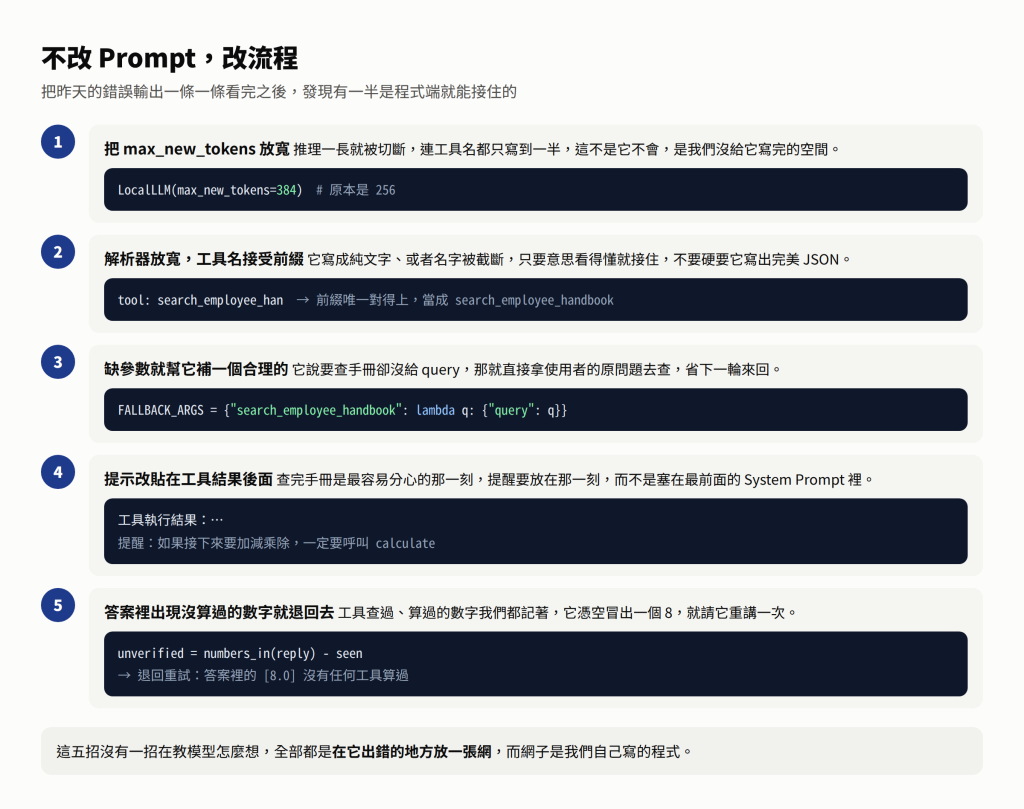
對於這個問題,我另外寫了一支 parser.py,標準 JSON、tool: xxx 這種純文字、get_today() 這種函式呼叫寫法全部都接,而且工具名稱只要前綴能唯一對應就算數:
def resolve_name(name: str) -> str | None:
    """模型常常把工具名寫一半就被截斷,只要前綴對得上而且不會搞混就接受。"""
    if name in TOOLS:
        return name
    hits = [n for n in _NAMES if n.startswith(name)]
    return hits[0] if len(hits) == 1 else None
另一個方式是我們把使用者問題裡的數字,以及每個工具查到、算到的數字,全部記在一個集合裡,只要最後的回答冒出一個沒有來源的數字,而且整輪下來根本沒呼叫過計算機,就把它退回去重講一次:
unverified = numbers_in(reply) - seen
if unverified and "calculate" not in called and not pushed_back:
    messages.append({"role": "user", "content": (
        f"你的回答裡出現了 {sorted(unverified)} 這些沒有查過也沒有算過的數字。"
        "請先用工具把它算出來或查出來,再重新回答一次。")})
這招的本質是用一個程式可以檢查的條件來把關,模型不知道自己在瞎掰,但我們知道哪些數字有來源,既然數字的來源可以查,就應該查。而這樣子補上流程之後,用同一組 rules Prompt 再跑一次:
| 做法 | 規劃正確 | 答案正確 | 平均秒數 |
|---|---|---|---|
| rules | 3/4 | 3/4 | 2.4 |
| rules + 補過的流程 | 4/4 | 4/4 | 3.1 |
這時我們卡了兩天的特休題終於解決了,其中模型的過程長這樣:
第 1 步:search_employee_handbook({'query': '年資三年還剩幾天'}) [json]
⤴ 退回重試:答案裡的 [9.0] 沒有任何工具算過
第 3 步:calculate({'expression': '5 + 9'}) [json] → 14
回答:您已經休了 5 天特休,所以還剩下 9 天的特休。
通過了多加一些檢查,換來一題的正確,我認為是相當划算的方式,而這也是為甚麼Claude在模型運算完畢後還會做很多檢查的原因。
你今天發現了,這些防護網其實都是我針對親眼看過的失敗,一張一張架起來的。換一組題目、換一種問法,就得重新寫一次。它可以撐住一個小型系統,卻很難撐住一個會持續成長的系統。
不過,這些方法本質上都是針對特定模型所做的應急措施。實際上在我們進行這些處理時,使用的模型都已經經過 Fine-tuning,因此並不會出現太多問題。但在開始 Fine-tuning 之前,我們還需要先解決一個更根本的問題不要再逼同一個模型同時負責「規劃」與「執行」。
我們要把這兩件事情拆分給不同的角色,讓模型各自負責自己擅長的事情。這也會是這個系列中,第一個真正意義上的分工。
我們明天見!


 iThome鐵人賽
 看影片追技術