
系列:「邊做邊補:用一個 AI 代理 mesh 專案,補齊 AI 工程師該有的能力」— 第 5 天
紀錄日期:2026-09-18
能力區:第 12 區 多 Agent 協作(兼第 9 區 評估)| 類型:做
多 agent 系統裡,不是每個 agent 都在生產最終答案。教材把常見角色分成幾類:產出者、複核者、規劃者、仲裁者。ai-agent-book 第 10 章講「對等協作」時特別提到交叉驗證——讓某個 agent 用獨立視角重新審視,而不是讓更多 agent 擠在同一條思維鏈上。
昨天我撞到的問題正好是這件事的反面:我的指標不知道有角色這回事。
昨天的重用率量的是「一份輸出有多少文字活到最終答案裡」。當規劃者指派一台去做複核,那台的工作就是被拿來對照,它的句子本來就不該出現在答案裡。指標卻把它記成 0%,看起來像它沒貢獻。
所以今天要做的事:讓指標看懂角色。
昨天同一題跑兩輪,只換拆解模式,重用率 0/3 對 2/3。0/3 那輪我原本以為指標壞了,去讀子任務原文才發現規劃者其實拆得很好:
Review the top five practical failure modes … from the angle of the coordinator side … Produce a ranked list … so the operator's final answer can be cross-checked against it.
最後那句講得再清楚不過:這份輸出的用途是被拿來對照。
如果我當時沒有去讀原文,只看那個 0/3,我會去改一個沒有壞的規劃者。這種事發生一次是運氣好抓到,發生第二次我不會那麼幸運——所以要把「看懂角色」寫進程式,不能靠我每次去讀。
我以為正解是去改契約:讓協調者在拆題的時候,順便給每個子任務標一個角色欄位。規劃者最知道自己的意圖,讓它直接說出來,比任何人猜都準。
這個判斷我到現在還是覺得對。但我沒有這樣做,原因是前幾天自己立的一條規矩:
還在變的東西不要往契約裡放。
契約是艦隊裡每台機器共用的東西,改一個欄位等於要求所有人一起改。而我昨天才剛證明我的指標在某些情況下會誤導自己——一個我自己都還沒摸熟的概念,沒有資格變成別人必須實作的欄位。
所以今天做的是暫時的、只在我這支手機上的版本:從規劃者自己寫的子任務文字裡,把角色讀出來。同時把「請在契約加角色欄位」寫成正式建議交出去。
export type SubtaskRole = "produce" | "review" | "unknown";

export function classifySubtask(task: string | null): SubtaskRole {
  const t = (task ?? "").trim();
  if (!t) return "unknown";
  // 0. 明確的交付語勝過一切:編輯型先對照來源、最後還是產出答案的那個人。
  if (/\b(produce|write|give|deliver)\b[^.]{0,40}\bfinal\s+(version|answer|draft)\b/i.test(t)) return "produce";
  // 1. 目的子句說「這份東西是要被拿去對照的」。
  if (/\bso\s+(the|that)\b[^.]{0,90}\b(cross[- ]?check|verif|double[- ]?check|validate)/i.test(t)) return "review";
  if (/\b(cross[- ]?check|fact[- ]?check)\b[^.]{0,60}\b(against|it|accuracy)\b/i.test(t)) return "review";
  // 2. 開頭是複核動詞。
  if (/^(review|inspect|audit|critique|evaluate|assess|verify|validate)\b/i.test(t)) return "review";
  // 3. 開頭是產出動詞。
  if (/^(write|draft|produce|compose|list|explain|summari[sz]e|answer|act as editor)\b/i.test(t)) return "produce";
  return "unknown";
}
三個設計決定:
規則有順序,而且最具體的在前面。 這不是偶然。昨天那個複核型子任務裡面就出現了 "final answer" 四個字——如果我用「有沒有出現 final answer」當產出者的判準,它會被判錯。所以第 0 條要求那個詞必須緊跟在交付動詞後面四十個字元內,而複核型那句是「產出一份排序清單……以便操作者的最終答案可以對照」,"Produce" 和 "final answer" 中間隔了整整一句話,不會誤中。
讀不懂就回 unknown,而 unknown 照樣計入指標。 這是保守的方向:寧可把一份其實是複核的算進分母(讓數字偏低),也不要把一份其實有貢獻的排除掉(讓數字偏高)。一個會低估的指標還能用來做決策,一個會高估的不行。
它只是啟發式,不是契約。 我在函式註解裡寫死這句話,因為三個月後看到這段程式的人(包括我)很容易把它當成系統的事實。
it("reads a reviewer from the purpose clause, even when it says final answer", () => {
  expect(classifySubtask(
    "Review the top five practical failure modes … so the operator's final answer can be cross-checked against it.",
  )).toBe("review");
});

it("reads a producer, including an editor who checks sources on the way", () => {
  expect(classifySubtask(
    "Act as editor. Take the plain-English draft and check it against the project files for accuracy. Produce the final version: plain English, under 200 words.",
  )).toBe("produce");
});
每一條字串都是協調者在 9/16 和 9/17 真的派出去過的,只有長度做了裁切。
這件事我認為比測試數量重要:用真實資料當 fixture,測試才會擋住真實的錯誤。 如果我自己編幾句「Review this」「Write that」,分類器會 100% 通過,然後在真實的長句子上錯得一塧糊塗——因為真實的規劃者寫的是三行長、夾雜目的子句和條件的句子。
順序本身就是設計,值得逐條講一次,因為每一條都是被真實句子逼出來的:
第 0 條(交付語)為什麼要排最前面。 有一種子任務長這樣:「當編輯。把白話草稿拿去對照專案檔案檢查正確性,產出最終版本。」它從頭到尾都在講「檢查」,但它交付的是最終答案。如果讓「檢查」的規則先匹配,這個產出者會被排除,分母就少了最重要的那一份。先問「誰負責交出東西」,再問「誰在檢查」。
第 1 條(目的子句)為什麼比動詞重要。 「Produce a ranked list … so the operator's final answer can be cross-checked against it.」開頭的動詞是 produce,但整句的意圖是 review。動詞說的是形式,目的子句說的是用途,而角色是由用途決定的。
第 2 條和第 3 條只看開頭。 因為長句子的中段幾乎一定會出現各種動詞。只信開頭的那個,是為了讓規則可預測——我寧可它在模糊的句子上回 unknown,也不要它從第三行栀到一個 review 就翻盤。
第 4 條的 unknown 為什麼計入。 這是整組規則裡唯一一個「錯了會怎樣」的決定。把 unknown 排除,指標會偏高(少算了沒被採用的);把 unknown 計入,指標會偏低。我選偏低,理由跟前兩天一樣:一個只往一個方向錯的指標,還能拿來做決策。
複核型的列不再記 0%,而是根本不進分母:
if (role === "review") {
  return { adapter_id: a.adapter_id, task: a.task, role, reuse: null, adopted: false, reason: "review" };
}
回傳多一個 reviewers 計數,畫面上多一行說明:
子任務文字重用 1/1(100%;門檻 15% …) 另有 2 份是複核型子任務,不列入計算
ipad-sim/app-local-groq 15%
m5/agy 複核·不計    m5/claude 複核·不計
而且每個被判為複核的參與者,在它的子任務前面會多一個「複核」標籤。這一點是給使用者的:「為什麼這台的輸出沒進最終答案」是使用者真的會問的問題,現在畫面自己回答了。
修完之後,我用昨天那個 0/3 的完全相同題目和參與者重跑「拆成子任務」。
我預期會看到:兩份被標成複核、排除,分母剩一份,變成 0/1 或 1/1。
實際看到的是:
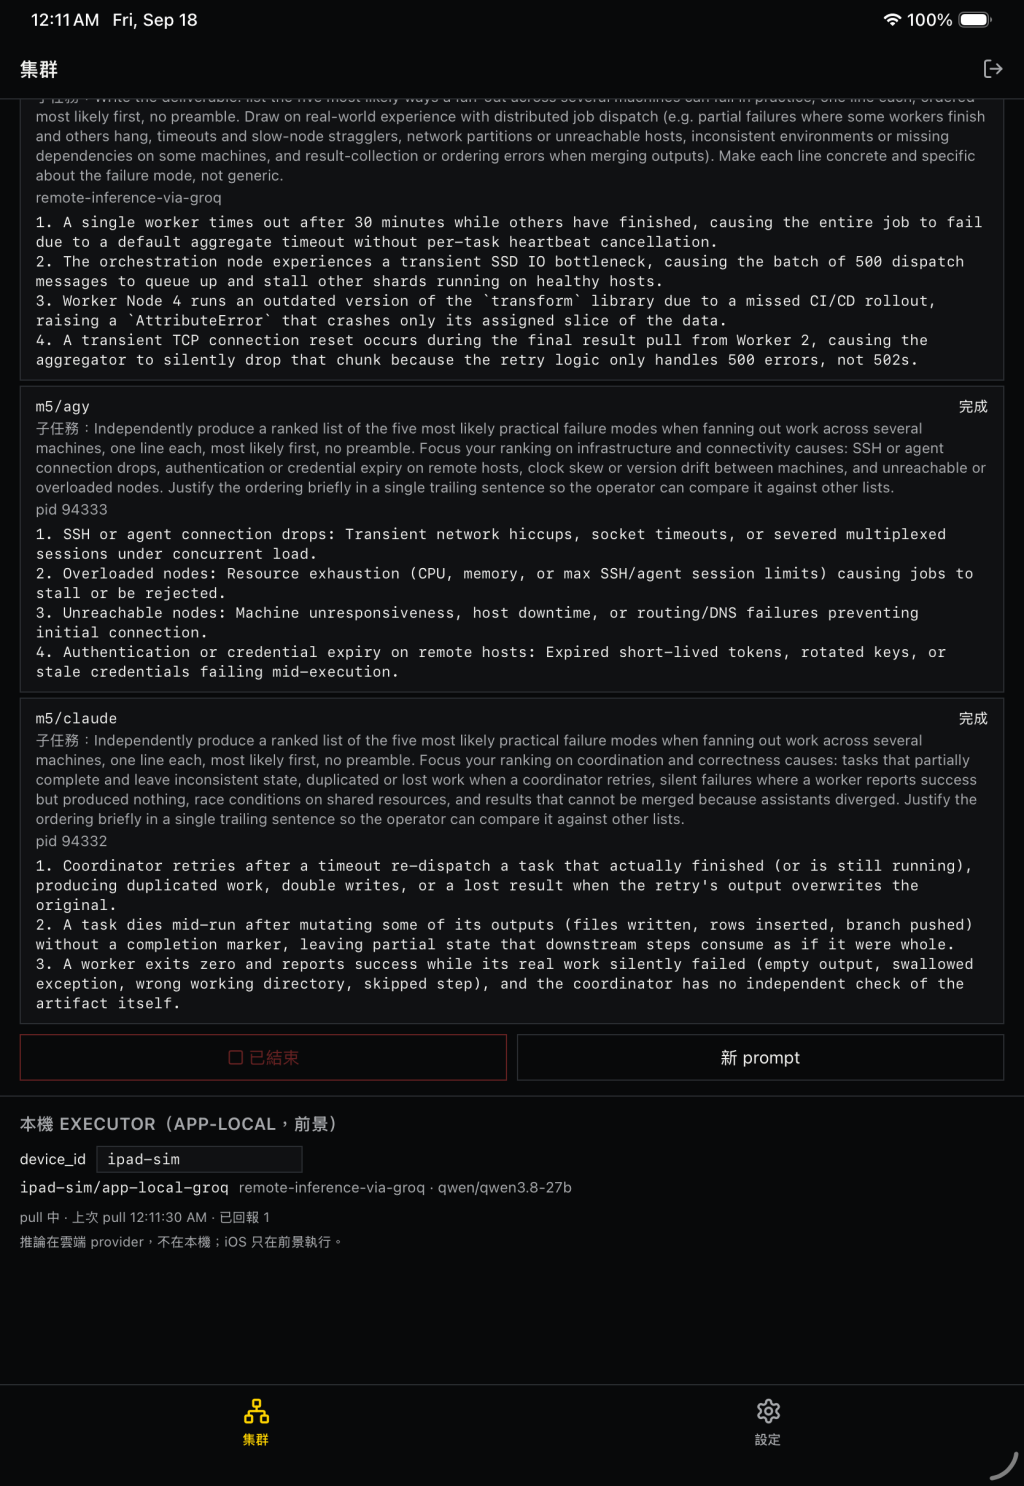
規劃者這次一份複核都沒派。 三份子任務長這樣:
Write the deliverable: list the five most likely ways a fan-out … can fail
Independently produce a ranked list … Focus your ranking on infrastructure and connectivity causes: SSH or agent connection drops, authentication or credential expiry, clock skew or version drift, unreachable or overloaded nodes.
Independently produce a ranked list … Focus your ranking on coordination and correctness causes: tasks that partially complete, duplicated or lost work when a coordinator retries, silent failures, results that cannot be merged.
同一題、同一組機器、同一個模式,昨天拆成「一個產出、兩個複核」,今天拆成「三個產出、各管一個面向」。規劃者本身就是隨機的。 這件事我昨天沒意識到,因為昨天只跑了一次。
於是分類器排除了 0 份,指標照算:
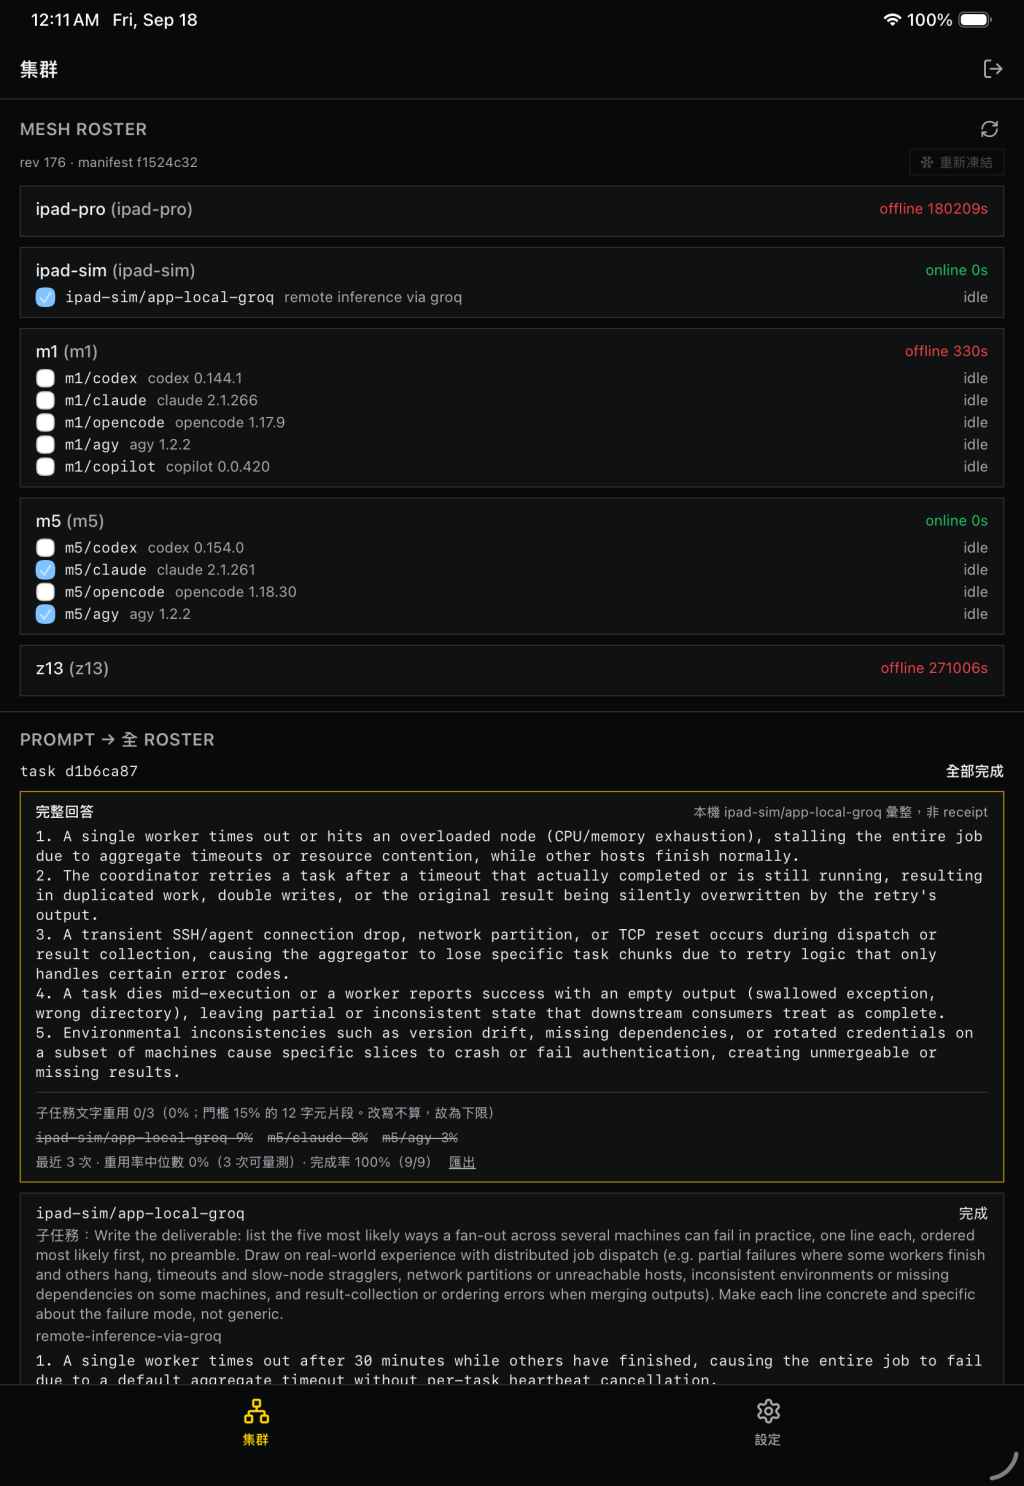
子任務文字重用 0/3(0%;門檻 15% 的 12 字元片段。改寫不算,故為下限)
ipad-sim 9% m5/claude 8% m5/agy 3%
最近 3 次 · 重用率中位數 0%(3 次可量測)· 完成率 100%(9/9)
還是 0/3。
昨天的 0/3 是指標誤判:兩份輸出根本不該被計分。
今天的 0/3 是真實訊號:三份都是產出型,都被計分,而它們的文字確實一句都沒進最終答案。
但這裡有第三種可能,而且它才是對的。去讀最終答案:
- A single worker times out or hits an overloaded node, stalling the entire job…
- The coordinator retries a task after a timeout that actually completed…
- A transient SSH/agent connection drop, network partition, or TCP reset…
- A task dies mid-execution or a worker reports success with an empty output…
- Environmental inconsistencies such as version drift, missing dependencies…
第 1、3、5 條是 m5/agy 那份(基礎設施與連線)的主題;第 2、4 條是 m5/claude 那份(協調與正確性)的主題。三份輸出的內容全部都進了最終答案。
只是合併的模型把每一句都重寫過了。
所以正確的結論是第三種:即使只計產出型,逐字重用仍然嚴重低估語意貢獻,因為合併模型傾向重寫而不是引用。
這一輪最讓我意外的不是指標,是同樣的輸入拆出了完全不同的結構。
昨天:一個產出、兩個複核。
今天:三個產出,各負責一個面向。
題目一字沒改,參與者一台沒換,拆解模式也一樣。唯一的差別是時間。
這件事對評估的意義很大:規劃者本身是一個隨機來源。所以任何「這次拆得好/不好」的敍述,如果只跑一次,講的其實是運氣,不是系統。我昨天就犯了這個錯——我在文章裡寫「規劃者拆得很好,昨天那個毛病完全沒出現」,那句話現在看起來太滿了。它應該寫成「這一次拆得很好」。
也因為這樣,第二個發現才更值得記:今天這種「三個產出者各管一個面向」的拆法,其實比昨天那種「一產出兩複核」更適合清單題。 三個面向的清單合併起來,涵蓋面比一份清單加兩份意見更廣。最終答案的五條剛好橫跨兩個面向,就是證據。
但我不能說「所以這種拆法比較好」——因為我還是只看了一次。
把這三天串起來看:
| 我以為問題是 | 實際上是 | |
|---|---|---|
| 9/16 | 沒有指標 | 做了一個逐字重用的下限 |
| 9/17 | 指標數字難看=系統有問題 | 指標把複核型誤判成沒貢獻 |
| 9/18 | 排除複核型就對了 | 排除之後才看到:合併會重寫,逐字比對本來就量不到 |
每一層都要修掉上一層,才看得到下一層。這不是走冤枉路——如果我 9/16 就直接做語意相似度,我不會知道「複核型」這個角色問題存在,因為語意相似度會把複核型的內容也算成高分(它們談的是同一批失敗模式),結果變成另一種誤判。
先做粗的、誠實的下限,讓它出錯,從錯的方式裡讀出系統的結構——這是今天最想留下來的方法。
第二層的解法我已經想清楚形狀了,但今天不做:
這三題裡最好處理的是清單題(E2)。每份輸出是五條、最終答案也是五條,所以可以問一個更精確的問題:最終答案的每一條,最接近哪一份輸出的哪一條? 這叫條目層級的對應,比整篇的字元重疊精確得多,而且輸出天然就有編號。
它需要的東西:把輸出切成條目(清單題很好切)、算條目之間的相似度(這裡才需要 embedding 或一個小模型)、做一個最佳配對。成本比整篇相似度低,因為比對的是短句對短句。
今天不做的理由跟昨天一樣:我還沒有足夠的資料去驗證它是不是真的比較好。 現在有三筆紀錄。等三種題型各跑幾次、累積到十筆以上,我才有東西可以拿來比較「字元重疊」和「條目對應」哪個更貼近我用眼睛判斷的結果。
寫到這裡有個明顯的替代方案:與其猜「哪份輸出被採用」,不如直接要求合併的時候標註每一條來自誰。那樣就完全不需要指標了,直接數就好。
想了一下,沒做,原因有三個:
所以順序是:先用不干擾系統的方式量,量不準再想辦法,最後才考慮改變系統本身來配合量測。 最後那一步通常代表你已經放棄理解原本的系統了。
unknown 有多少比例我沒在追。 如果哪天大部分子任務都落到 unknown,這個分類器就只是裝飾。應該把角色分布也記進每次的紀錄裡。| 分母是誰 | 0% 代表什麼 | 已知會錯在哪 | |
|---|---|---|---|
| 9/16 v1 | 所有完成的輸出 | 文字沒被重用 | 改寫看不到;複核被誤判 |
| 9/17 v1(加歷史) | 同上 | 同上 | 同上,但至少會累積 |
| 9/18 v2(加角色) | 只有產出型與讀不懂的 | 產出型的文字沒被重用 | 改寫仍看不到;角色是猜的 |
| 下一版 | 產出型的每一條 | 這一條沒有對應條目進答案 | 條目切割會失敗;需要相似度模型 |
每一列都比上一列少錯一件事,但沒有一列是對的。指標的演化跟程式的重構是同一回事:你不是在逼近真理,你是在一次減少一種特定的錯法,而且每次都要說得出這次減少的是哪一種。
一個好的指標不只告訴你系統有多好,它會告訴你系統的結構。
今天的 0/3 沒有回答「這次跑得好不好」,但它回答了另一個更有用的問題:合併這個環節在做的事情是重寫,不是組裝。我原本以為合併是把幾份東西拼起來、去掉重複;實際上它是讀完之後重新寫一份。
這兩件事對整個系統的意義完全不同。如果合併是重寫,那麼:
這三個推論我今天都還不能證實,但它們是從一個「難看的數字」裡讀出來的,而不是從我對系統的想像裡。
今天這段可以搬走的部分:
Day 06|評估|做。把三種題型各跑一輪,讓紀錄從三筆長到六筆,同時把角色分布(幾份 produce、幾份 review、幾份 unknown)也記進去。有了這個,第 3 點的「分類器是不是裝飾」就有數字可以回答。
參考:ai-agent-book 第 10 章「多 Agent 協作」的交叉驗證一節;hello-agents 第十二章。


 iThome鐵人賽
 看影片追技術