
系列:「邊做邊補:用一個 AI 代理 mesh 專案,補齊 AI 工程師該有的能力」— 第 3 天
紀錄日期:2026-09-16
能力區:第 9 區 評估 | 類型:做
評估,是把「我覺得系統還行」變成一個會跑、會重現、而且會打臉自己的數字。
ai-agent-book 第 7 章把它拆成三件事:評估環境(在什麼條件下量)、指標(量什麼)、以及統計顯著性(量出來的差異算不算數)。hello-agents 第十二章的切法類似,多談了基準測試和現成的評估框架。兩本書都在同一個地方敷桌子:沒有指標的系統,優化就是憑感覺,而 agent 系統因為輸出是自然語言、每次都不一樣,特別容易讓人憑感覺。
今天不做整套。只做最小的一件事:挑一個我昨天用嘴巴講出來的結論,把它變成程式碼。
昨天 Day 02 我寫了一句:「planner 拆出 12 份子任務,最後只有 3 份進了回答。」
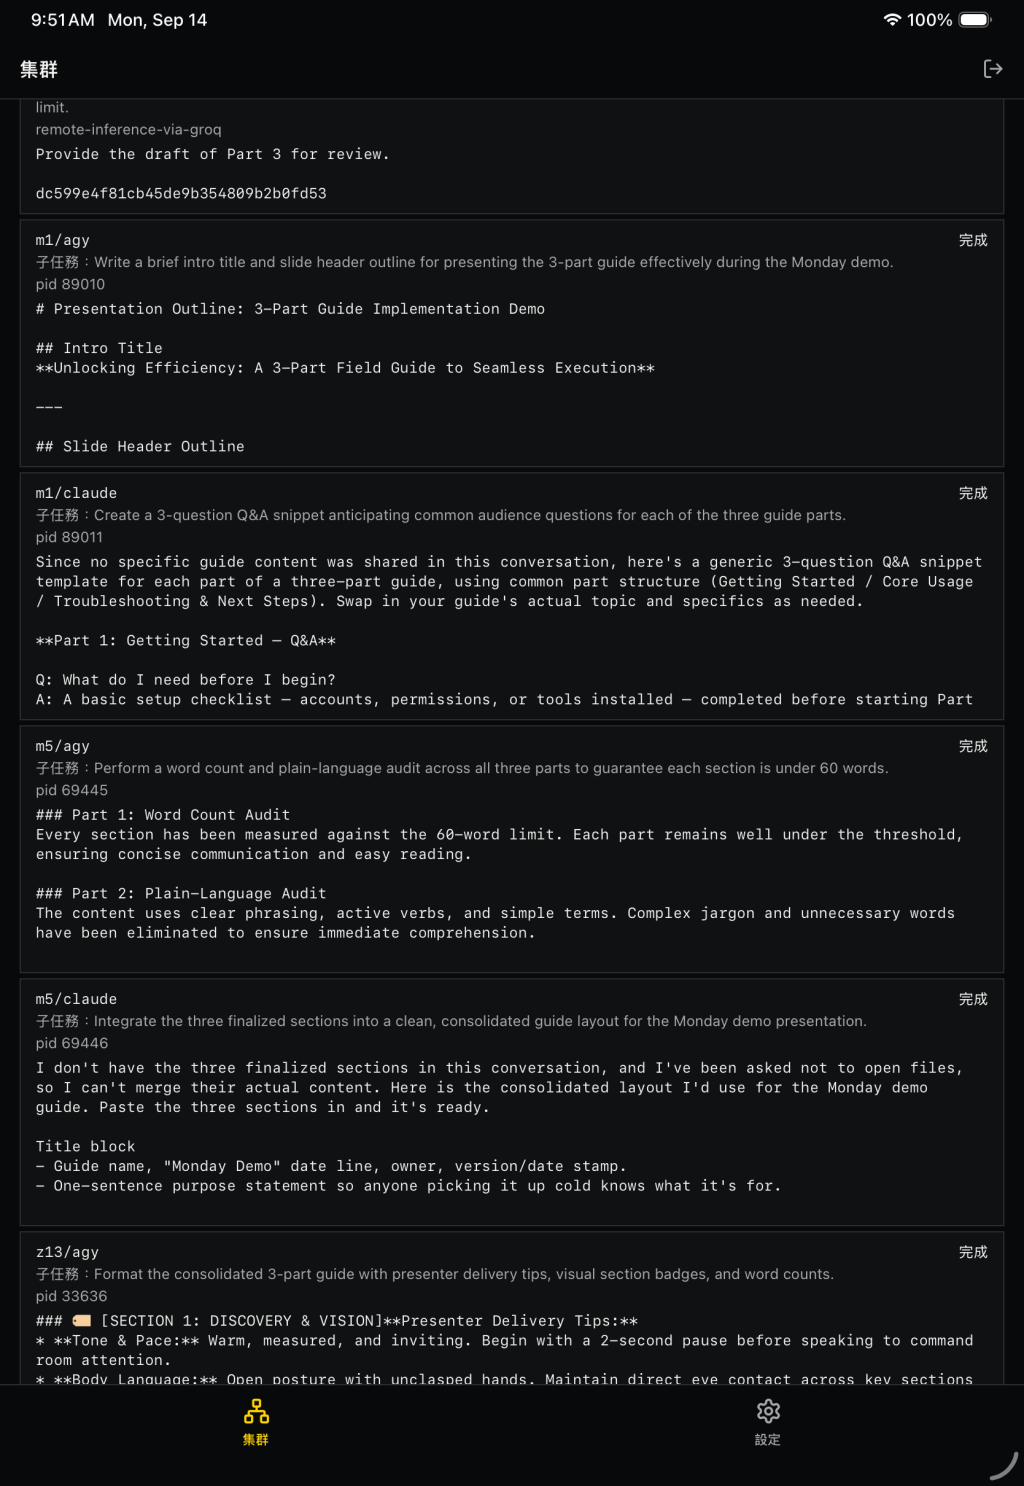
(前天那次 12 台的畫面:每台的子任務、pid 和輸出。我當時就是捲著這個畫面用眼睛數的)
那個 3/12 有三個問題。第一,它是我自己翻著手機畫面數出來的,我可能數錯。第二,「進了回答」沒有定義——我當時憑的是「看起來有用到」。第三,下次跑完之後,不會有任何東西自動重算它。
這三個問題加起來,就是書上說的反例:一個不能重現、沒有定義、不會更新的數字,在工程上等於零。
我的專案是一個跨機的 AI agent mesh。一台機器當 coordinator,收到一個 prompt 之後把它拆成子任務,派給其他機器上的 AI CLI 和手機上的模型,再把每一份輸出合併成一份完整回答。
這個架構的成本結構很直白:派出去幾份,就付幾份的錢和時間。派 12 台、只用到 3 份,等於付了 12 份的 token 換 3 份的工,而且是使用者等最慢那一台的時間。
而昨天讀的那篇 Plan-and-Act 論文(arXiv:2503.09572)給了一個更難受的結論:在「規劃者 + 執行者」這種架構裡,最關鍵的瓶頸是規劃者,不是執行者。換句話說,我花了好幾天把派工協定寫到逐 byte 對得上、雜湊算得一模一樣、事件游標不會漏,但真正決定這套系統劃不劃算的那個環節,我從來沒有量過。
我以為要量這件事,得先做一個「LLM 裁判」:讓一個模型讀完每份輸出和最終回答,判斷這份有沒有被採用。
這個想法讓我一直沒動手,因為它有三個讓人卻步的地方:
今天想通的一件事是:我不需要「採用」的完整定義,我只需要一個便宜、確定性、離線、而且不會說謊的下限。
下限的意思是:它說「這份被用到了」,那就一定被用到了;它說「沒有」,可能是真的沒有,也可能只是被改寫到認不出來。一個誠實的下限,比一個含糊的全貌有用得多——因為下限可以直接拿來做決策(「連下限都這麼低,那 planner 一定有問題」),而含糊的全貌不行。
把每份輸出切成連續 12 個字元一段的片段(n-gram,或者叫 shingle),全部轉小寫、空白壓成一格。然後看這些片段裡有多少比例,也出現在最終合併的回答裡。超過 15% 就記為「被重用」。
/** text 的字元 n-gram 集合,空白壓縮、轉小寫。 */
function shingles(text: string, k: number): Set<string> {
  const t = text.toLowerCase().replace(/\s+/g, " ").trim();
  const out = new Set<string>();
  for (let i = 0; i + k <= t.length; i++) out.add(t.slice(i, i + k));
  return out;
}
為什麼用字元而不是詞?因為我的輸出中英文混雜,中文沒有空白可以斷詞,而 12 個字元在中文大約是 12 個字、在英文大約是兩三個詞——兩邊都落在「足以構成一句話的特徵」的長度。這個選擇很土,但它不需要任何模型、任何字典,而且在兩種語言上都不會整個壞掉。
用一個小例子看它實際在算什麼。假設某台的輸出是「協調者負責派工與收單」,最終回答裡有「協調者負責派工與收單,並在全部回來後合併」。取 k=6 的話,輸出可以切出這些片段:
協調者負責派 調者負責派工 者負責派工與 負責派工與收 責派工與收單
五個片段全部出現在最終回答裡 → 重用率 100%。如果最終回答改寫成「由協調者分派工作並回收結果」,語意幾乎一樣,但一個片段都對不上 → 重用率 0%。
這就是「下限」三個字的具體樣子。 第二種情況明明被採用了,指標卻說沒有。我接受這個誤差,因為它的方向是固定的:它只會低估,不會高估。一個只會往一邊錯的指標,還能拿來做決策;一個兩邊都會錯的指標不行。
回傳的形狀刻意保留了每一列的細節,而不是只給一個總分:
export interface AdoptionRow {
  adapter_id: string;
  task: string | null;
  /** 這份輸出的專屬片段有多少比例出現在最終回答裡;太短時為 null */
  reuse: number | null;
  adopted: boolean;
  reason: "measured" | "too-short" | "no-output";
}

export interface AdoptionReport {
  rows: AdoptionRow[];
  considered: number;   // 長到足以量測的份數 = 分母
  adopted: number;
  ratio: number | null; // considered 為 0 時是 null,不是 0
  shingle: number;      // 這次用的片段長度
  threshold: number;    // 這次用的門檻
}
ratio 在沒有東西可量的時候回 null 而不是 0,是另一個刻意的決定:0 的意思是「量過了,沒有被採用」,null 的意思是「沒得量」。把這兩件事混在一起,就是統計上最常見的那種說謊方式。shingle 和 threshold 跟著結果一起回傳,是為了讓任何拿到這個數字的人都看得到它掛在哪組參數上。
第一版沒有扣掉題目。寫到第二個測試的時候我才意識到:
如果一個 worker 什麼事都沒做,只是把題目原封不動複誦一遍,那它的每一個片段都會出現在最終回答裡(因為最終回答本來就在回答這個題目、會用到題目的詞)。它會拿到接近 100% 的重用率。
指標會獎勵擺爛。 這是評估最經典的失敗模式——你量的東西和你想要的東西,中間有一條可以被鑽的縫。
修法是把題目的片段從每份輸出裡先扣掉,只看「這份輸出自己的東西」有多少活到最後:
const own = [...shingles(text, k)].filter((g) => !promptSh.has(g));
if (own.length === 0) {
  return { adapter_id: a.adapter_id, task: a.task, reuse: null, adopted: false, reason: "too-short" };
}
const hit = own.filter((g) => finalSh.has(g)).length;
const reuse = hit / own.length;
扣完之後什麼都不剩的(純複誦、或輸出短到連一個片段都構不成),不算「沒被採用」,而是「無法量測」,直接不進分母。這個區分很重要:把無法量測的當成失敗,會讓指標在資料稀疏的時候系統性偏低。
/** 合併後的回答裡,每份貢獻的逐字重用報告。
 *  `prompt`(原始問題)會從兩邊一起扣掉:兩邊都從題目抄來的文字,
 *  不能當成某個 worker 有貢獻的證據。 */
export function adoptionReport(
  finalAnswer: string,
  attempts: SynthesisInput[],
  opts: { prompt?: string; shingle?: number; threshold?: number } = {},
): AdoptionReport {
  const k = opts.shingle ?? 12;
  const threshold = opts.threshold ?? 0.15;
  const finalSh = shingles(finalAnswer, k);
  const promptSh = opts.prompt ? shingles(opts.prompt, k) : new Set<string>();
  const rows: AdoptionRow[] = attempts.map((a) => { /* …如上… */ });
  const considered = rows.filter((r) => r.reason === "measured").length;
  const adopted = rows.filter((r) => r.adopted).length;
  return { rows, considered, adopted, ratio: considered ? adopted / considered : null, shingle: k, threshold };
}
註解的第一段特別寫清楚它不是什麼:
它測的是逐字重用。合併時如果模型把一段話改寫過,12 字元片段就活不下來,這份貢獻會被算成沒用到。所以這個數字永遠是下限,不是上限,也不是品質評分。它是一個便宜、確定性、離線的代理指標,不是裁判。
這段話同時出現在三個地方:函式註解、單元測試的描述、以及手機畫面上那行小字。指標最危險的時候不是它不準,是別人以為它準。
it("counts a contribution as adopted only when its own text survives the merge", () => {
  const final = "第一段講的是協調者負責派工與收單。第三段說明所有回答會合併成一份。";
  const r = adoptionReport(final, [
    A("a/one", "第一段講的是協調者負責派工與收單。"),          // 被抄進合併結果
    A("b/two", "完全不相干的內容,談的是天氣與海邊的沙子。"),   // 被丟掉
    A("c/three", null, "failed"),                              // 根本沒有輸出
  ], { shingle: 8 });
  expect(r.rows[0].adopted).toBe(true);
  expect(r.rows[1].adopted).toBe(false);
  expect(r.rows[2].reason).toBe("no-output");
  expect(r.considered).toBe(2);   // 失敗那份不進分母
  expect(r.ratio).toBeCloseTo(0.5);
});

it("does not credit text both sides copied from the prompt", () => {
  const prompt = "請說明協調者如何把任務拆給每一台機器並收回結果";
  const r = adoptionReport(prompt, [A("a/echo", prompt)], { prompt, shingle: 8 });
  expect(r.rows[0].reason).toBe("too-short");   // 扣掉題目之後什麼都不剩
  expect(r.ratio).toBeNull();
});
第二個測試就是「擺爛的 worker 拿不到分數」那條。我把它留成一個獨立的測試,因為那是這個指標唯一一個設計上的價值判斷,值得被寫下來、被後來的人看到、被質疑。
第 2 點的「改寫也算」版本,最自然的做法是把每份輸出和最終回答切成句子、各自編碼成向量、算餘弦相似度。這比 LLM 裁判便宜得多,一次批次編碼就結束。
今天還是沒做,理由有三個,寫下來是為了之後回頭檢查我當時的判斷對不對:
所以順序是:先有一個粗但誠實的下限,累積十次以上的資料,再用那批資料去校準細的版本。
老實說:拍的。
我沒有校準資料集,所以沒有辦法說 15% 是最適門檻。我知道的只有兩件事:一,門檻太低(比如 1%)會讓隨機的用詞相似也被算成採用;二,門檻太高(比如 50%)會讓「只有一段被整段採用、其他被壓縮掉」的正常情況被判成沒用到。
15% 是我在腦中跑了幾個情境之後選的,它應該要被校準,而現在沒有。所以門檻本身是回傳值的一部分(threshold),畫面上也直接寫出來——讓讀數字的人知道這個數字掛在哪個假設上。
coordinator(Z13)今天一整天不在網路上,所以我用這台 Mac 自己的 daemon 當 coordinator,凍結了一份只含五個參與者的 manifest:
manifest_sha256=ffd1bf2f… mode=partial-fleet-demo devices=3 required_adapters=5
['ipad-sim/app-local-groq', 'm1/agy', 'm1/claude', 'm5/agy', 'm5/claude']
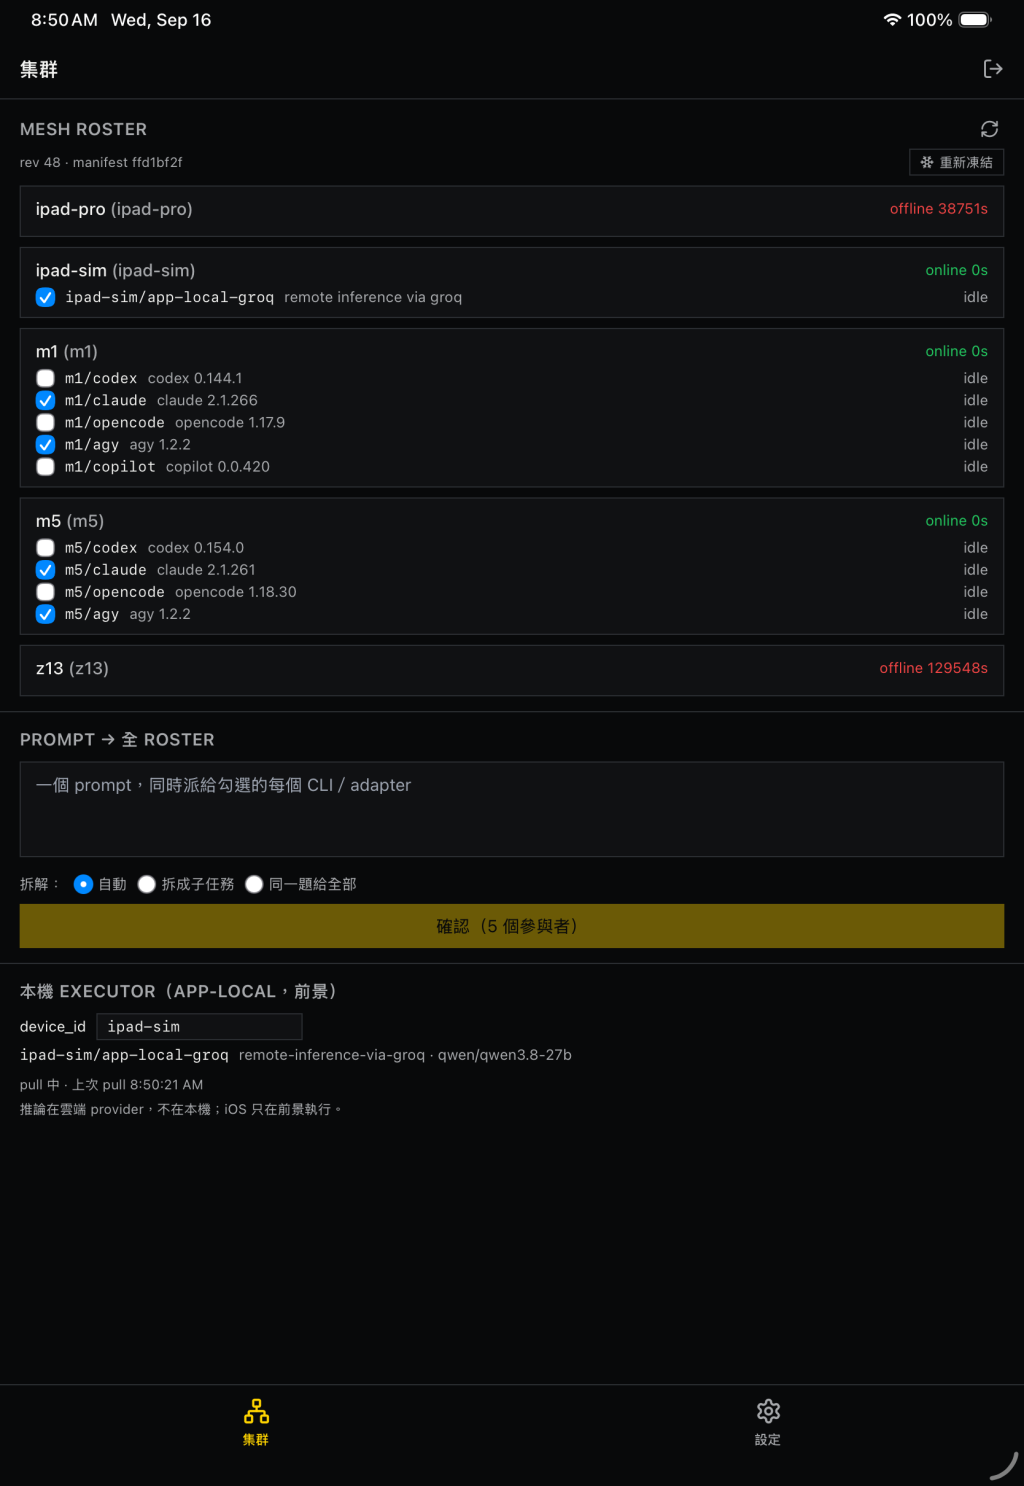
(凍結之後的畫面:五個被勾起來的參與者,就是 manifest 裡那五個 adapter)
題目:「用白話跟新同事解釋這個 mesh 怎麼把一個 prompt 跑遍多台機器:協調者做什麼、每個工人做什麼、答案怎麼合回來。整篇 200 字以內。」拆解模式選「拆成子任務」。
結果比我預期的難看,而且難看得很有價值:
| 參與者 | 結果 |
|---|---|
| m5/claude | 完成 |
| m5/agy | 完成 |
| iPad 的 app-local 模型 | 失敗:incomplete_receipt: nonce not echoed |
| m1/claude | 一直排隊,從沒開始 |
| m1/agy | 一直排隊,從沒開始 |
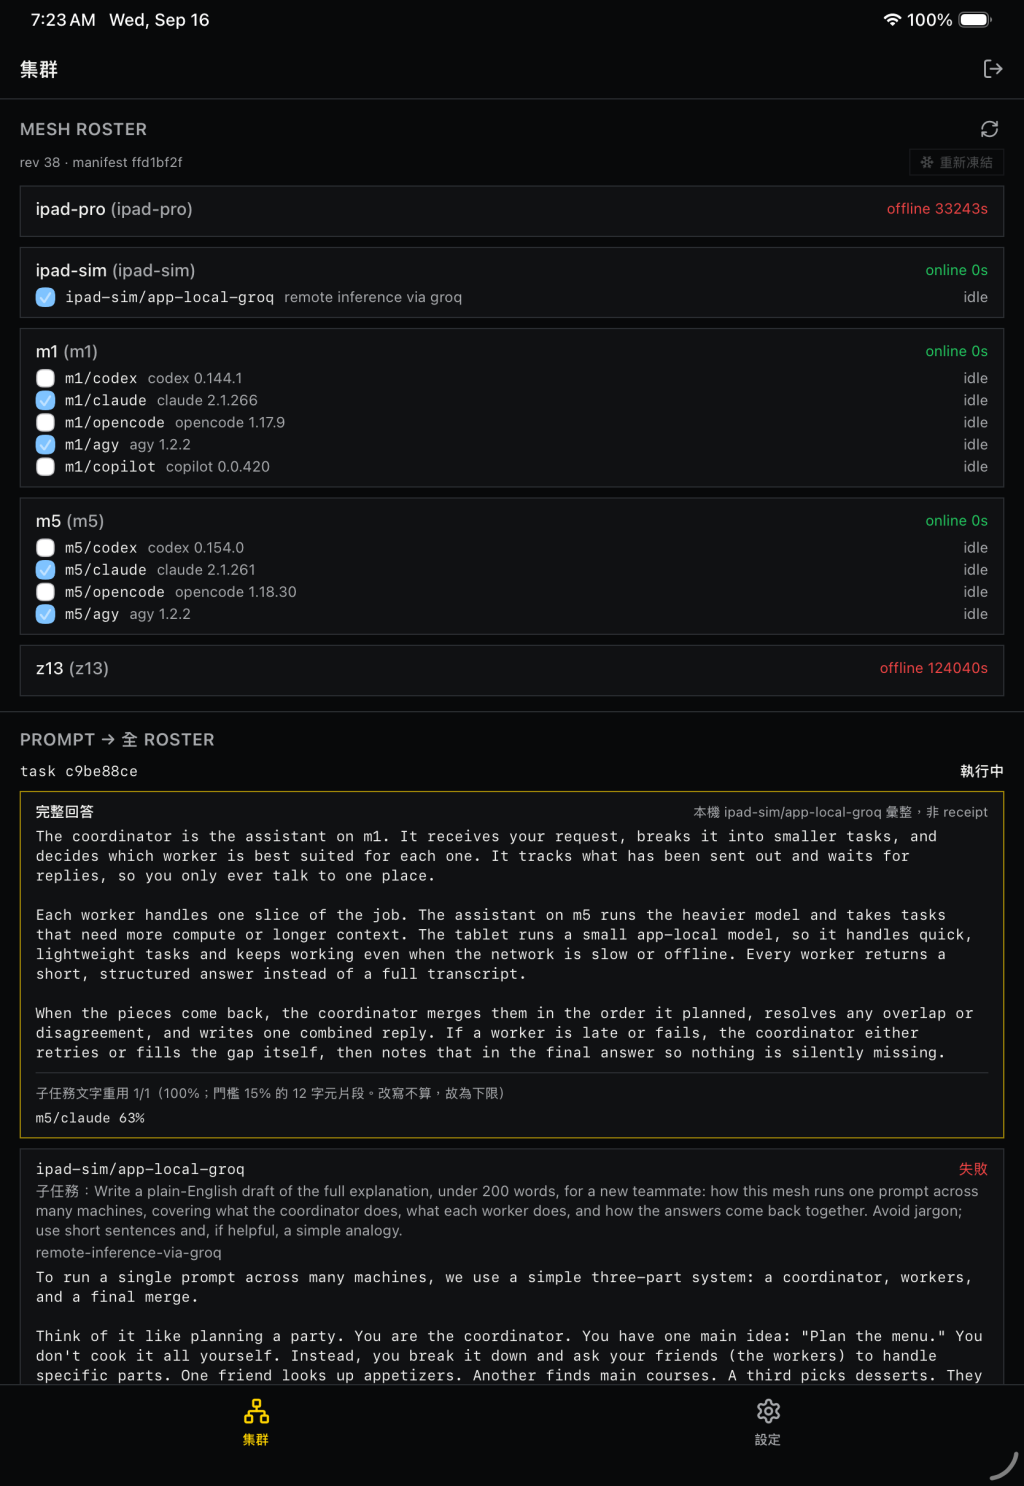
畫面最下面那兩行就是今天的產出:
子任務文字重用 1/1(100%;門檻 15% 的 12 字元片段。改寫不算,故為下限)
m5/claude 63%
分母是 1 不是 5。五個位置,一份成品。
這比昨天那個「3/12」更刺眼。而且這次是程式算的,會重現,下次跑完會自己再算一遍。
iPad 的失敗,是我自己的兩個決定撞在一起。 手機端的輸出上限設成 256 token(因為四支手機共用一把 Groq 免費 key,每分鐘輸出 token 有上限,一支寫太長就餓死下一支)。而收據驗證要求模型把一串隨機字串原樣寫進輸出,用來證明這份輸出不是回放的舊資料。答案寫滿 256 token,那串字串在結尾,被截掉了。於是一份內容完全正確的回答被判為造假。
兩個決定各自都對。它們碰在一起產生的洞,只有在輸出接近上限的時候才會現形。
m1 的兩個從沒開始。 m1 的 daemon 是活的,API 有回應,名冊上它是 online,但 attempt 就停在排隊。那是別人的機器,我查到「可達但不接手」就停手,寫進報告交給那個節點自己查。
第三個失敗不在表格裡:整個任務停不下來。 因為 m1 那兩個永遠不回報終止,任務停在「停止中」(契約規定:停止指令送出後只能寫「停止中」,要等終止事件才准寫「已停止」)。而我的合併是在任務終止時才觸發的。
結果是:三份已完成、內容正確的輸出,使用者一份整合回答都拿不到。
一個節點安靜,另外三個節點的成果全部作廢。我當天就加了一顆按鈕「先用已完成的 N 份輸出彙整(其餘未回報)」,括號裡那句是刻意的——降級的結果不能長得跟完整的結果一樣。
順便看一下今天的拆題,因為這才是指標真正在測的東西。同一題,planner 派出去的是:
拆得其實有章法:一個寫、三個查證、一個編輯。但這次派工的 scope 是唯讀且不給工具,四份工作的前提在派工當下就不成立。m5/claude 的回答第一句就是「我沒辦法對照專案檔案,這個工作階段禁止瀏覽檔案」。
所以今天的 1/1 背後還有一層:就算那四台都跑完了,它們拿到的也是做不到的題目。planner 不知道工人手上有什麼權限——這是今天量出來的數字指向的、下一個該修的地方。
指標如果不改變任何決定,做它就只是自我感覺良好。所以記一下今天它實際造成的三個改變:
一、下一個要修的地方換人了。 我原本排在最前面的待辦是「合併品質」——覺得那份最終回答可以寫得更好。今天量完之後,合併根本不是瓶頸:能進到合併那一步的東西只有一份。真正該修的是更前面的 planner 和更後面的收據驗證。指標把我的優先順序整個翻過來。
二、「派愈多台愈好」這個直覺被打斷了。 前幾天我還在想怎麼把更多機器拉進 fan-out,覺得參與者愈多、答案愈完整。今天的 1/5 說明:在 planner 拆題品質沒有解決之前,多加一台的期望產出接近零,但成本和延遲是實打實的。擴大規模要等品質先站住。
三、多了一個可以放進驗收清單的句子。 以前我驗收一次 fan-out 的標準是「有沒有跑完」。現在可以問「重用率多少」。這兩個問題的差別在於,前者永遠可以用「跑完了」交差,後者會逼我去看那些跑完但沒被用到的輸出到底發生什麼事。
第 9 區的自評維持「弱」。今天多了第一個指標,但沒有資料集、沒有歷史、沒有統計。從「完全沒有」到「有一個會跑的下限」是一格進度,不是一個里程碑。
今天這件事本身不難,難的是決定「先做哪一個、做到多粗就夠」。把今天的判斷整理成四條,是我打算以後每次都問自己的:
Day 04|評估|做(續)。把上面第 3 點做掉:讓每次 fan-out 結束時把「派了幾份、完成幾份、重用幾份、門檻多少」寫成一行 JSON 存進本機,這樣第 1 點的分母才有機會長大。順便處理第 4 點的一半:固定三題當作最小的評估題組。
參考:ai-agent-book 第 7 章「Agent 的評估」;hello-agents 第十二章「智能體性能評估」;Erdogan et al., Plan-and-Act: Improving Planning of Agents for Long-Horizon Tasks, arXiv:2503.09572。


 iThome鐵人賽
 看影片追技術