
今天回頭加強 Feed 功能,看看原本陽春的做法會有什麼問題。
Day 3 我們做出了最陽春的 Feed 邏輯:
SELECT *
FROM posts
WHERE author_id IN (
    SELECT followee
    FROM follows
    WHERE follower = :user_id
)
ORDER BY created_at DESC
LIMIT 20;
流程是:Feed 被打開的當下,才去查詢「這個人追蹤了誰」,接著撈這些人的貼文,排序後回傳。這種「讀取當下才即時組裝」的做法,叫做 Fan-out on Read。
在使用者少的時候完全沒問題,但假設 Pikachu 追蹤了 2,000 個人呢?
每一次 Pikachu 打開 Feed、往下滑、甚至只是重整頁面,Server 都要進行這些內容:
查詢 Pikachu 追蹤的 2,000 個人
      ↓
向這 2,000 個作者查詢最新貼文
      ↓
把結果全部混在一起排序
      ↓
取出前 20 筆回傳
而尷尬的是,這 2,000 個人的貼文內容,在這幾秒鐘之間幾乎不會改變,但我們卻要為了每一次 Feed Read 都重新算一次。
使用者越活躍、越常滑 Feed,這個昂貴的查詢就被重複執行越多次,Database 的負擔也隨之飆高。
問題的本質是:
我們把「組裝 Feed」這件昂貴的事,放在使用者最頻繁觸發的「讀取」路徑上。
既然讀取的頻率遠高於發文的頻率,那能不能反過來想:
在有人發文的當下,就把這篇貼文直接送到每一個追蹤者的 Feed 裡
這樣可讓「讀 Feed」變成一次單純的查詢,而不是每次都重新運算,這就是 Fan-out on Write。
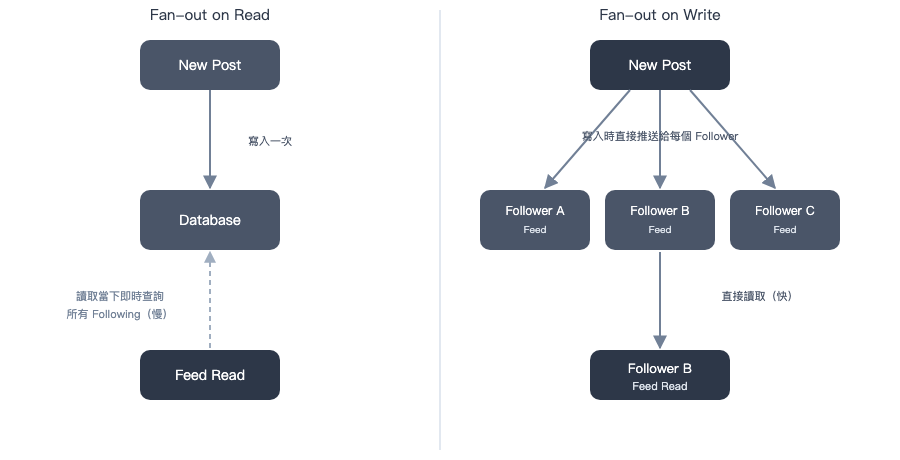
實作上,每個使用者會有一份自己專屬、已經排好序的 Feed(例如存在 Redis 的 List 裡)。當 Charmander 發布一篇新貼文:
Charmander 發布 Post
        ↓
查出 Charmander 的所有 Follower
        ↓
把這篇 Post 直接寫進每個 Follower 的 Feed List
之後 Pikachu 打開 Feed,Server 只需要做一件事:
直接讀取 Pikachu 自己的 Feed List
        ↓
回傳
從「DB 撈資料」變成「Cache 查表」,Read 的成本大幅下降。
Fan-out on Write 把成本從讀取端搬到了寫入端,這個 Trade-off 在大部分情況下很划算,因為大部分使用者的追蹤者數量都是合理範圍。
但如果發文的人剛好是川投顧和馬投顧,或是超級巨星、流量網紅之類擁有幾千萬追蹤者的帳號呢?
他只是發了一篇貼文,系統卻要因此產生幾千萬次寫入。
把這篇貼文塞進每一個追蹤者的 Feed List 裡,這不只會有效能問題,甚至可能瞬間打爆 Message Queue 與 Feed Store 的寫入能力,這就是典型的「Hotspots(熱點)」問題。
面對這類問題,比較直覺的想法就是分類處理。
一般使用者適合 Fan-out on Write,可是熱門帳號會把 Fan-out on Write 拖垮,業界的做法通常不是二選一,而是依帳號類型混用兩種策略,也就是 Hybrid Fan-out:
Follower 讀 Feed 時,除了直接讀自己的 Feed List(已經包含一般朋友的貼文),還要額外用 Fan-out on Read 的方式,即時查詢自己追蹤的熱門帳號有沒有新貼文,兩邊的結果在讀取當下合併、排序後才回傳給使用者。
| Fan-out on Read | Fan-out on Write | Hybrid Fan-out | |
|---|---|---|---|
| 何時計算 | 讀取當下即時運算 | 發文當下就推送 | 依帳號類型混用 |
| Read 效能 | 慢,使用者越活躍負擔越重 | 快,直接查表 | 多數情況快 |
| Write 成本 | 低,只需寫入一次 | 高,追蹤者越多成本越高 | 一般帳號低,熱門帳號改為讀取時處理 |
| 最大風險 | 追蹤數多的使用者拖慢自己的 Read | 熱門帳號一發文就炸掉寫入端 | 實作複雜度最高 |
| 適合場景 | 追蹤者數量分佈平均、規模較小 | 一般社群平台的多數帳號 | 追蹤者數量落差極大的大型社群平台 |
Twitter 或 Facebook 這類擁有大量「一般使用者」與少數「超級大帳號」並存的平台,正是採用 Hybrid Fan-out 的典型案例。
這次把 Feed 從最陽春的 Fan-out on Read,一路演化到能同時應付一般使用者與熱門帳號的 Hybrid Fan-out:
不過「熱門帳號」的問題其實不只發生在 Feed 上,一篇爆紅的貼文、一個瞬間湧入大量流量的使用者,會用各種形式讓系統的某個角落被打爆,即使整體系統其實還有餘裕。


 iThome鐵人賽
 看影片追技術