
昨天在討論 Fan-out 時提到,擁有幾千萬追蹤者的帳號一發文,就可能讓 Fan-out on Write 的寫入量瞬間爆炸,所以今天就把這個狀況抽出來單獨討論。
回想這個系列一路做的事:Load Balancer 把 Request 分散到多台 Server,Sharding 把資料分散到多個 Database 節點,Hash-based Sharding 甚至刻意打散資料,避免大家擠在同一個地方。
這些設計背後都有一個共同假設:流量會平均分散在各個節點、各個 Key 上。
但真實世界不是這樣運作的,假設有個世界知名人物叫老川,他發了一篇引起世界關注的貼文,短時間內湧入的按讚、留言、瀏覽,全部都集中在同一篇貼文、同一個使用者身上:
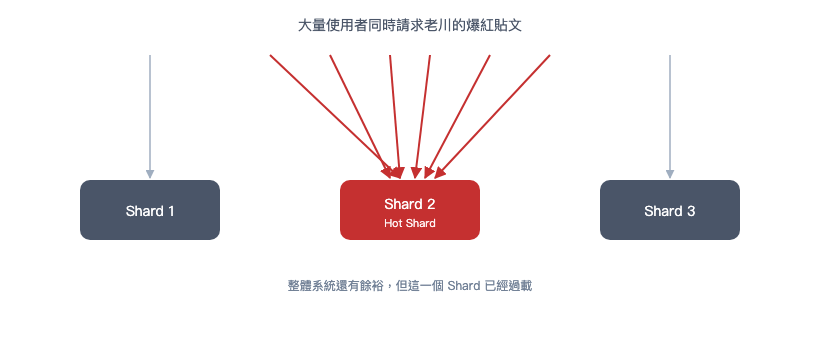
即使整個系統理論上還有很多餘裕,別的 Shard 很閒、別的 Cache Key 幾乎沒人查,但只要負責老川這篇貼文的那一個 Shard 被瞬間打爆,使用者感受到的就是「系統掛了」。
這種現象叫 Hot Key(或 Hot Partition、Hot Shard),跟「整體流量太大」是完全不同的問題。
整體流量大加機器通常有效,但流量太集中在少數幾個 Key 上,加再多機器也沒用,因為其他機器根本分不到這些 Request。
老川這篇貼文的內容,會被大量使用者在短時間內反覆查詢。如果每次都直接打 Database,即使只是同一個 Shard 承受,也足以讓它撐不住。
最直接的做法是加強 Cache,把這篇熱門貼文的內容,用足夠長的 TTL 快取起來,讓絕大多數 Request 直接被 Cache 擋下,不需要碰到 Database。
但這裡有個容易被忽略的細節:如果這個 Cache Entry 剛好過期,會發生什麼事?
假設同一秒有上萬個 Request 都發現 Cache Miss,它們會同時跑去查 Database、同時想把結果寫回 Cache,Database 瞬間被這波「重新整隊」的流量打爆,這種現象叫 Cache Stampede(快取雪崩的一種)。
常見的緩解方式包括:讓 TTL 加上一點隨機值,避免大量 Key 在同一時間點集體過期;或者採用「鎖」的機制,只讓第一個發現 Cache Miss 的 Request 去查 Database,其他人先等待,等它把資料寫回 Cache 後大家再一起讀。
對真的特別熱門的內容,甚至可以進一步把這份資料複製到多個 Cache 節點,分散讀取壓力而不是全部集中打到同一個 Cache。
不過背後藏著另一個問題:Request 進來的時候,要怎麼決定該去問哪一個 Cache 節點?
最直覺的做法,跟 Day 18 提到的 Hash-based Sharding 一樣:
node_id = hash(key) % N // N 是目前的節點數量
這個公式在節點數量固定時運作得很好,但只要 N 一變,不管是加新的還是有一台掛掉,幾乎所有 Key 算出來的 node_id 都會跟著改變。
這正是 Day 18 提過的 Resharding 頭痛問題:% N 這個公式只要 N 改變,等於把整個對照表打掉重練,原本存在 Node A 的 Key,突然被算成該去 Node C,快取瞬間大量失效,Database 又要重新扛一波打過來的流量,等於自己製造一次 Cache Stampede。
Consistent Hashing(一致性雜湊) 解決的正是這個問題:當節點數量改變時,只讓一小部分 Key 需要搬家,而不是全部重新洗牌。
核心概念是把「節點」跟「Key」都用同一個 Hash Function,算到同一個環狀的數值空間上(想像成一個時鐘錶面,從 0 一路排到最大值之後又繞回 0)。規則很簡單:每個 Key 沿著環順時針走,遇到的第一個節點,就是負責它的節點。
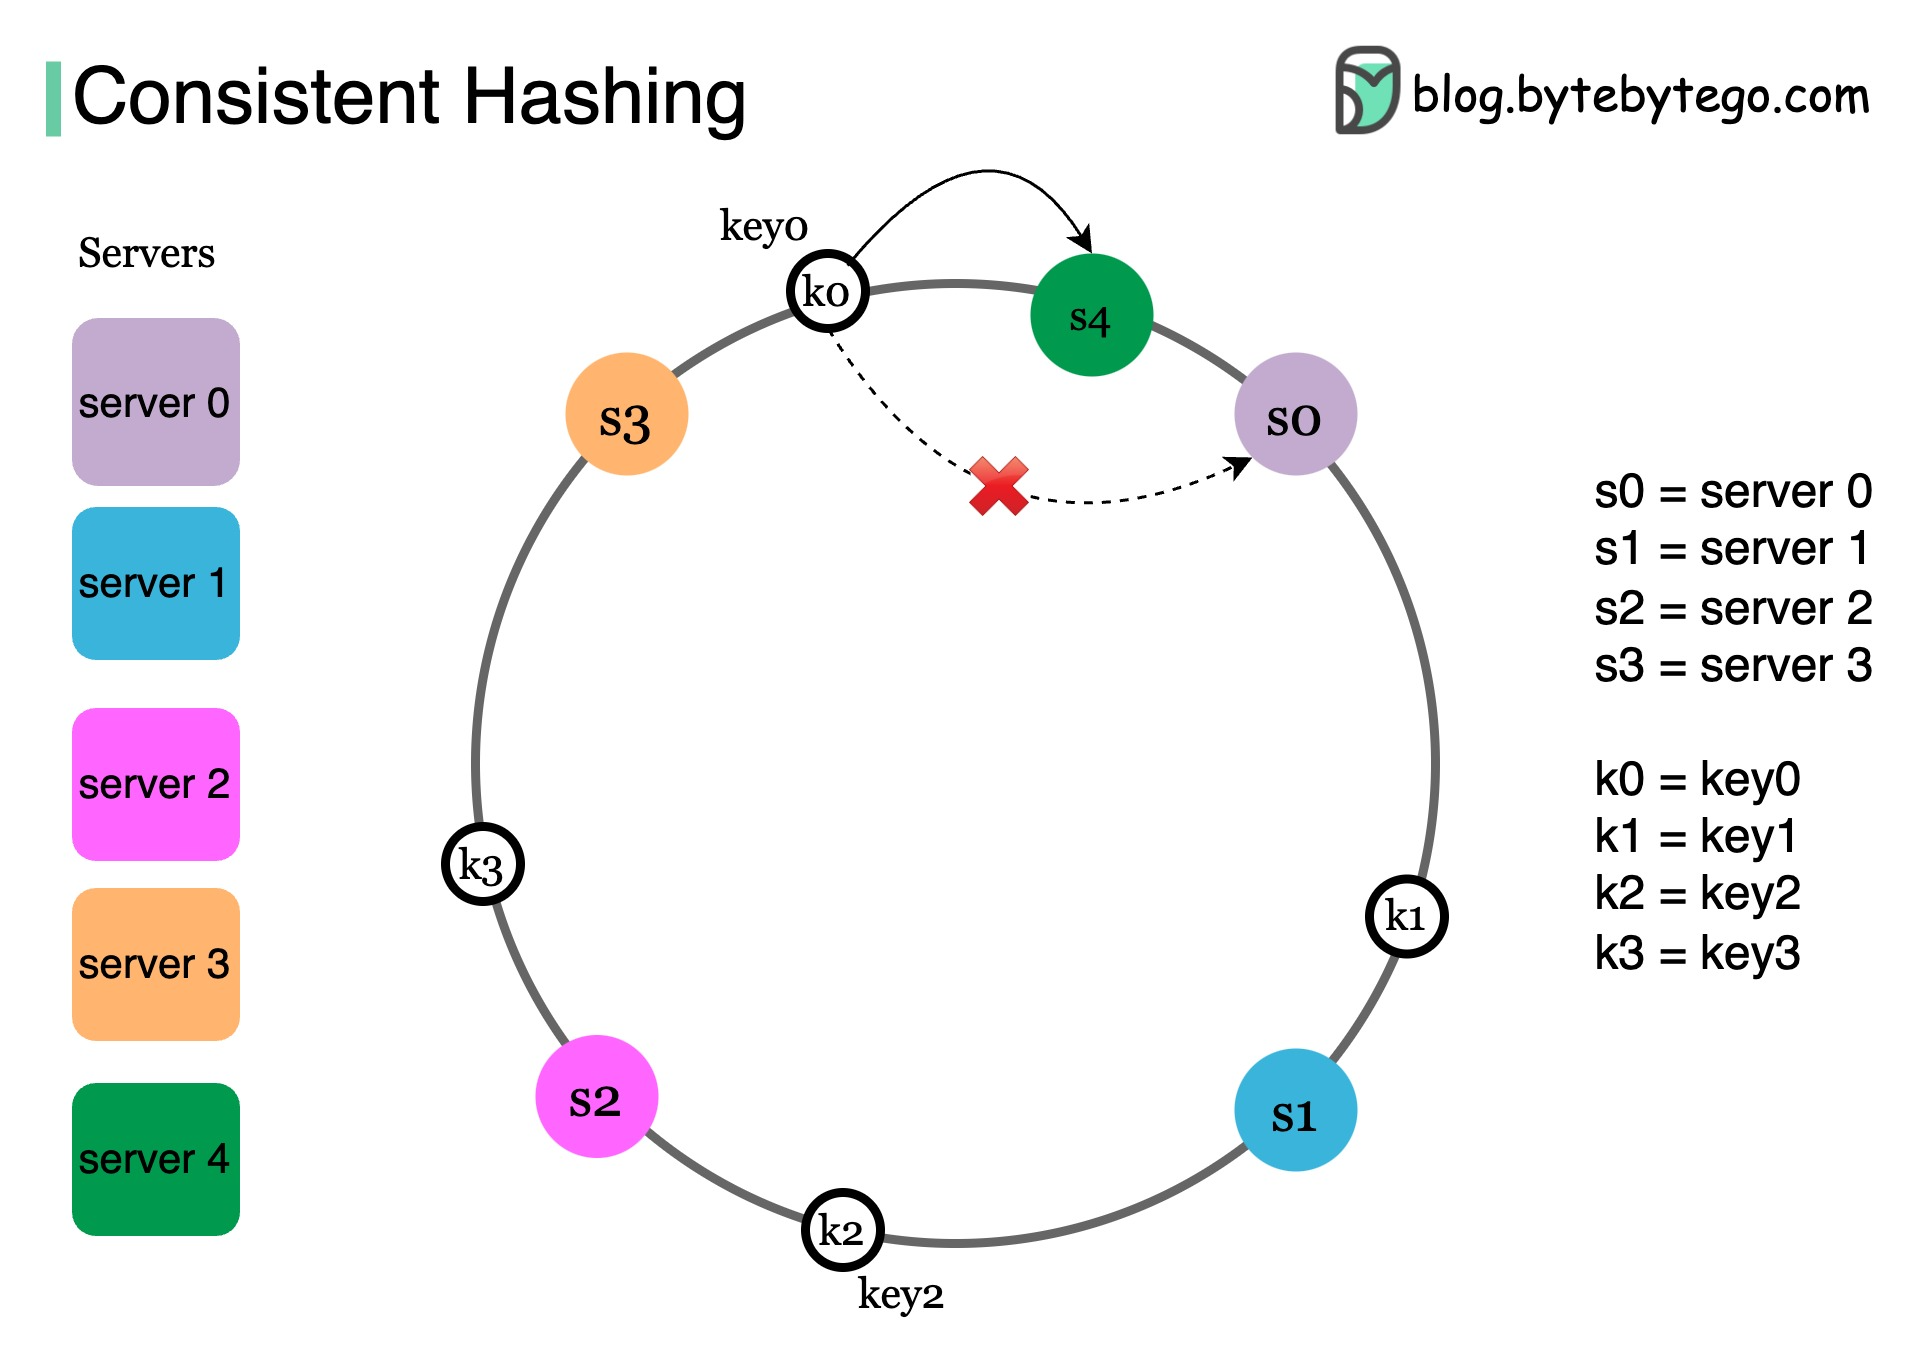
(參考 ByteByteGo 的圖)
如上圖,新增節點 S4 時,只要把它的 Hash 值算出來、放到環上 S0 跟 S3 之間的某個位置:只有「原本要繞過去找 S0」的 Key(也就是 K0),會改成找到 S4;環上其他位置的 Key,繞的還是原本那個節點,完全不受影響。
反過來,如果拿掉一個節點,效果也一樣:原本由它負責的那一段 Key,會改成順時針找到下一個節點,其他節點負責的範圍完全不變。
想像捷運環狀線,每一站負責照顧自己跟下一站之間的這段路線。如果哪天在兩站中間新開一個站,只有原本那一小段路線的乘客會改成在新站上下車,其他站的乘客完全不受影響,不需要重新規劃整條路線。
跟 hash(key) % N 那種「牽一髮動全身」的做法比起來,Consistent Hashing 讓水平擴展(加節點)跟故障移除(減節點)都只造成局部的資料搬遷。
這對「動態增加 Cache 節點分攤熱門內容流量」特別重要,增減節點時不會因為重新分配把大部分快取瞬間打掉重練,不會反而自己製造一次 Cache Stampede。
實務上通常還會搭配 虛擬節點(Virtual Nodes):讓每個實體節點在環上對應好幾個位置,而不是只有一個點,避免節點分佈不均、其中一段落差太大又變成新的 Hot Spot。
比讀取更棘手的是寫入,假設這篇爆紅貼文同時湧入大量的 Like,而 Like Count 是資料庫裡的一個欄位,用最直覺的方式實作:
UPDATE posts SET like_count = like_count + 1 WHERE id = :post_id;
當上萬個 Request 同時對同一列資料執行這個 Update,它們會互相搶鎖、排隊等待,這一列資料就成了名符其實的 Hot Row。常見的緩解方向有兩種:
與其讓所有寫入都搶同一列,不如把 Like Count 拆成好幾份子計數(例如依照 Request 隨機分配到 10 個 shard 計數器之一),寫入時只更新其中一個子計數器,讀取時再把所有子計數器加總。
這樣寫入的壓力就被分散到多個獨立的資料列,而不是全部擠在同一列上。
回顧之前提到的 Message Queue,與其讓每一次 Like 都同步搶著更新 Database,不如先把這個事件丟進 Queue,由背後的 Worker 慢慢批次處理、定期彙總更新,用非同步、緩衝的方式吸收這波瞬間流量,而不是讓 Database 直接硬扛流量海嘯。
今天討論的問題,跟這個系列前面一路做的「均勻分散」剛好相反:
% N 一樣牽一髮動全身值得記住的是:一個系統的整體容量夠不夠,跟它能不能扛住「集中在單一 Key 上」的極端流量,其實是兩個不同的問題,後者往往才是真正把系統打垮的原因。


 iThome鐵人賽
 看影片追技術