
我們的 PokeThreads 走到現在,已經是一個具備 Load Balancer、Stateless Server、Sharded Database、Cache、CDN、Message Queue 的系統了,但有一個使用者天天在用、我們卻從來沒認真設計過的功能:搜尋。
Pikachu 想找某篇提到「寶可夢」的貼文,或是想直接搜尋 Charmander 這個帳號,這種需求聽起來理所當然,但要做好一點都不簡單。
先看最陽春的寫法:
SELECT *
FROM posts
WHERE content LIKE '%寶可夢%';
看起來簡單又完全合理,反正資料都在 Database 裡,查一下不就好了?
在資料量很小的時候,這樣寫確實沒問題,但隨著 PokeThreads 一路走到今天的規模,這支 Query 會出大問題。
Database 的 Index(索引)本質上是排序過的資料結構,適合用來加速「等於」「範圍」「前綴比對」這類查詢,例如 WHERE content LIKE '寶可夢%'(只有結尾是萬用字元)還可能用得上索引。
但 LIKE '%寶可夢%' 這種前面也有萬用字元的寫法,Database 沒辦法用索引快速定位起點,只能整張表逐筆比對,這就是 Full Table Scan(全表掃描)。
回想 Day 18 我們把 Posts 表 Sharding 成好幾個獨立的 Database Node,這對一般依照 Shard Key 查詢的操作很有幫助,但對「搜尋」這種需求完全是反效果,因為我們不知道符合關鍵字的貼文分散在哪些 Shard,只能對每一個 Shard 都做一次 Full Table Scan,再把結果合併起來。
Shard 越多,一次搜尋要付出的代價反而越高。
就算不考慮效能,LIKE 查詢在語意上也做不到真正的搜尋引擎會做的事:
真正的搜尋引擎不會每次現場掃描全部文件,而是預先建立一份反過來的索引。
一般的資料表是「每一列存一篇文章」,而 Inverted Index 反過來,是「每一個字,對應一份出現過這個字的文章清單」:
一般索引:Post ID -> 文章內容

Inverted Index:
"寶可夢" -> [Post 1, Post 5, Post 42, ...]
"訓練家" -> [Post 5, Post 9, ...]
"神奇"   -> [Post 3, Post 42, ...]
當使用者搜尋「寶可夢」,系統不需要掃過所有文章,只要直接去 Inverted Index 查「寶可夢」對應的清單,就能立刻拿到候選結果,這個查詢複雜度跟資料總量幾乎無關,只跟這個字出現的次數有關。
前面提到,LIKE 查詢有個天生的限制:沒辦法處理同義詞、模糊比對。
Inverted Index 解決的是效能問題,但這個語意上的限制其實還在,如果 Pikachu 搜尋「跑得很快的寶可夢」,貼文裡寫的卻是「敏捷」「速度型」,關鍵字比對完全抓不到這種意思相近、字面卻不同的內容。
這正是這幾年業界普遍導入 AI 的地方:把每一篇貼文丟給一個 Embedding Model,轉換成一組能代表「語意」的向量(Vector),意思相近的內容,向量在空間中的距離也會相近。搜尋時把使用者輸入的關鍵字也轉成向量,直接找出向量空間裡最接近的貼文,這種做法叫 Semantic Search(語意搜尋),也稱 Vector Search。
實務上很少整個換掉 Inverted Index,而是兩者混用,稱為 Hybrid Search:關鍵字比對負責精準比對(例如帳號名稱、Hashtag 這類需要完全命中的內容),Vector Search 負責語意相關的內容,兩邊的結果再一起排序合併。
這代表 POST /posts 除了寫 Database,還要多等 Search Index 也寫入成功才能回應,等於在寫入路徑上多綁了一個依賴。
如果 Search Index 那端變慢或暫時掛掉,連帶拖累使用者發文這個核心操作,這正是 Day 11 我們在同步 Notification 上踩過的坑。
這才是實務上更常見的做法:
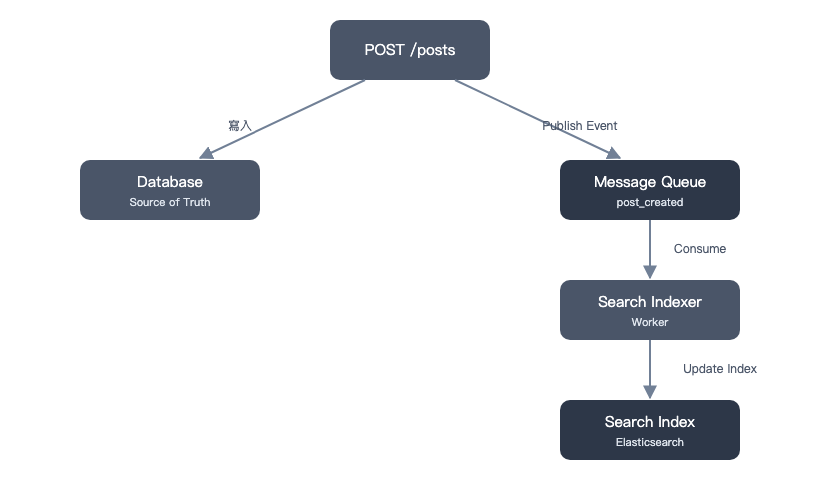
發文流程維持原本的樣子,Database 依然是 Source of Truth,額外多發布一個 post_created 事件到 Message Queue,由一個獨立的 Search Indexer Worker 消費這個事件,把新貼文的內容寫進 Search Index。
把索引更新變成非同步之後,會有一段時間差:Pikachu 剛發的文章,可能要過幾百毫秒甚至幾秒鐘,才會真正出現在搜尋結果裡。
這其實就是 Day 17 談過的 Eventual Consistency,Search Index 不追求跟 Database 完全即時同步,而是接受「最終會同步」這件事。
對搜尋功能來說,這個延遲通常完全可以接受:沒有人會期待自己剛發的文章,一秒鐘內就出現在全站搜尋結果的第一名。
搜尋看起來只是加一個搜尋框,但背後其實是完全不同的資料結構與查詢方式:
PokeThreads 現在多了一條資料流:Database 負責寫入與讀取真相,Search Index 透過 Message Queue 非同步更新、專門負責回答「哪些文章符合這個關鍵字」。
這也再次印證一件事:不是所有查詢需求都該塞給同一個 Database 解決,該用什麼工具取決於問題本身。


從 LIKE 全表掃描一路接到 inverted index、vector 與 hybrid search,選型脈絡很順。既然資料庫是 Source of Truth、索引又非同步更新,漏事件、重複事件或文章刪除時,你會怎麼補償與定期 reindex?


 iThome鐵人賽
 看影片追技術