

Day 3 做完之後,Visual Learning Lab 已經可以把一段文字送給 GPT,然後回傳 Quick Summary、Key Concepts、Relationships 和 Suggested Visualization。
昨天最後測試三相感應馬達時,GPT 不只整理內容,還主動建議這份內容適合用:
所以 Day 4 我決定先從最簡單的一個開始。
既然 GPT 說這東西適合 Flow,那我就真的把它畫出來。
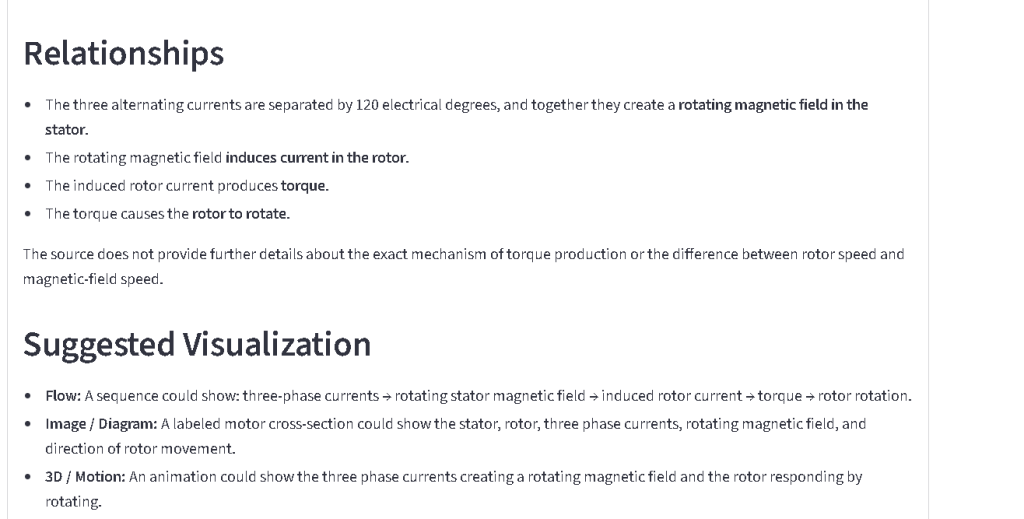
昨天 GPT 已經可以分析概念關係,也會判斷這份內容適合什麼視覺化方式。
Day 3 的 Relationships 已經可以整理出像這樣的東西:
Three-phase currents
↓
Rotating magnetic field
↓
Induced rotor current
↓
Torque
↓
Rotor rotation
人看到這些文字,其實已經可以大概理解流程,但對 Visual Learning Lab 來說還不夠。
因為我真正想做的不是讓 GPT 回傳「這應該畫成流程圖」,而是:
GPT 判斷完之後,網站真的自己把圖畫出來。
所以今天我開始做第一個真正的 Visual Flow。
這次我第一次碰到一個滿有趣的問題。
昨天 GPT 回傳的 Relationships 是給人看的,例如:
Three-phase currents create a rotating magnetic field.
The rotating magnetic field induces current in the rotor.
The induced rotor current produces torque.
人類看完全沒問題。
但程式如果要自動畫圖,就需要更固定的資料格式。
它需要知道:
誰
↓
透過什麼關係
↓
連到誰
所以今天我讓 Codex 把 GPT 的輸出改成更結構化的形式,概念上大概像:
{
  "source": "Three-phase currents",
  "relation": "create",
  "target": "Rotating magnetic field"
}
這種東西對人來說比較醜,但對程式來說反而很好用。
因為只要知道 source、relation 和 target,網站就可以把它轉成:
Three-phase currents
        │
      create
        ↓
Rotating magnetic field
這也是我今天第一次比較明顯感受到,AI 產生的內容不一定只是在「回答人」。
有時候 AI 是先產生一份讓程式可以繼續處理的資料,再由程式把它變成最後真正給人看的結果。
畫圖的部分今天先用 Graphviz。
原因很簡單:現在不是要追求全世界最炫的互動圖,而是先確認整條流程真的可以跑。
也就是:
原始文字
↓
GPT 理解
↓
Structured Relationships
↓
Graphviz
↓
Visual Flow
重新跑一次昨天那段三相感應馬達內容後,Visual Learning Lab 第一次真的自己畫出一張圖。
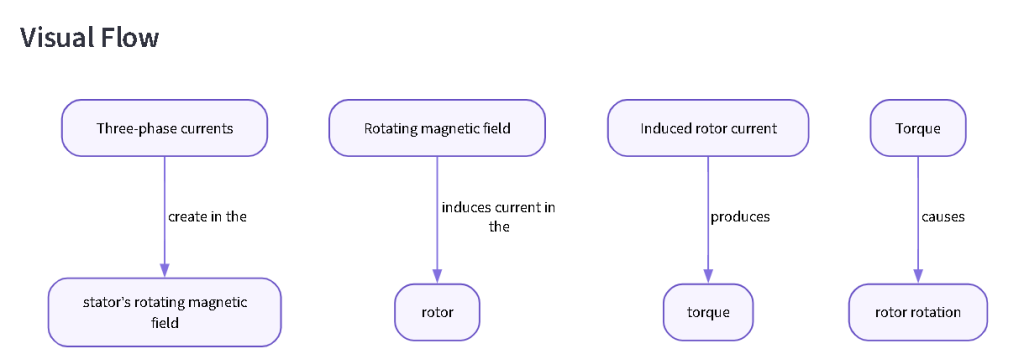
Visual Learning Lab 的第一張真正視覺化結果。
看到圖跑出來那一刻,其實滿有感的。
Day 2 的時候,Flow 還只是一張寫著「未來會做」的功能卡片。Day 3 的時候,GPT 只會告訴我「這段內容適合 Flow」。到了 Day 4,它終於真的開始畫了。
但第一張圖一出來,我也馬上發現問題。
第一版馬達流程圖沒有完全串成一條線,而是變成幾組分開的節點。
例如 GPT 一邊寫:
stator's rotating magnetic field
另一邊又寫:
Rotating magnetic field
人一看就知道這兩個其實是在講同一個東西。
但程式不知道。
對程式來說:
"stator's rotating magnetic field"
和
"Rotating magnetic field"
就是兩個不同名稱,所以 Graphviz 會把它們當成兩個不同節點,這個 Bug 我反而很直接地看到:
AI 看得懂,不代表程式也知道它們是同一件事。
後面應該要再想辦法讓 GPT 先建立一份固定的節點清單,再要求 Relationships 裡只能引用那些節點名稱,這樣才不會每次換個說法就產生新的 Node,但今天我先沒有急著把這件事情修完,我比較想先確認另外一件事:
這個 Flow 到底是真的根據內容生成,還是只是剛好對馬達有效?
所以我又丟了一段完全不同的內容進去,這次測的是水循環:
Water evaporates from oceans and lakes due to heat from the sun. The water vapor rises, cools, and condenses into clouds. When water droplets become heavy enough, precipitation falls to the ground. Water then collects in rivers, lakes, and oceans, beginning the cycle again.
這次 GPT 一樣先分析出:
Relationships 也變成:
Sun's heat
↓ causes
Evaporation
↓ produces
Water vapor
↓ rises and cools into
Clouds
↓ produce
Precipitation
↓ collects in
Rivers, lakes, and oceans
Suggested Visualization 則推薦:
接著 Visual Learning Lab 也真的重新畫出另一張完全不同的圖。
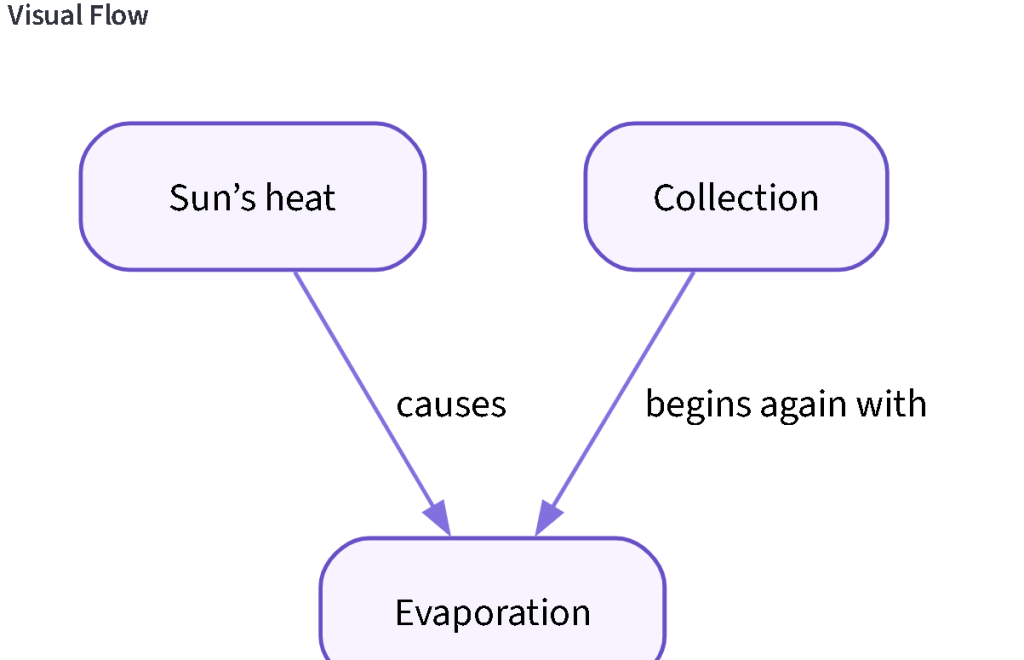
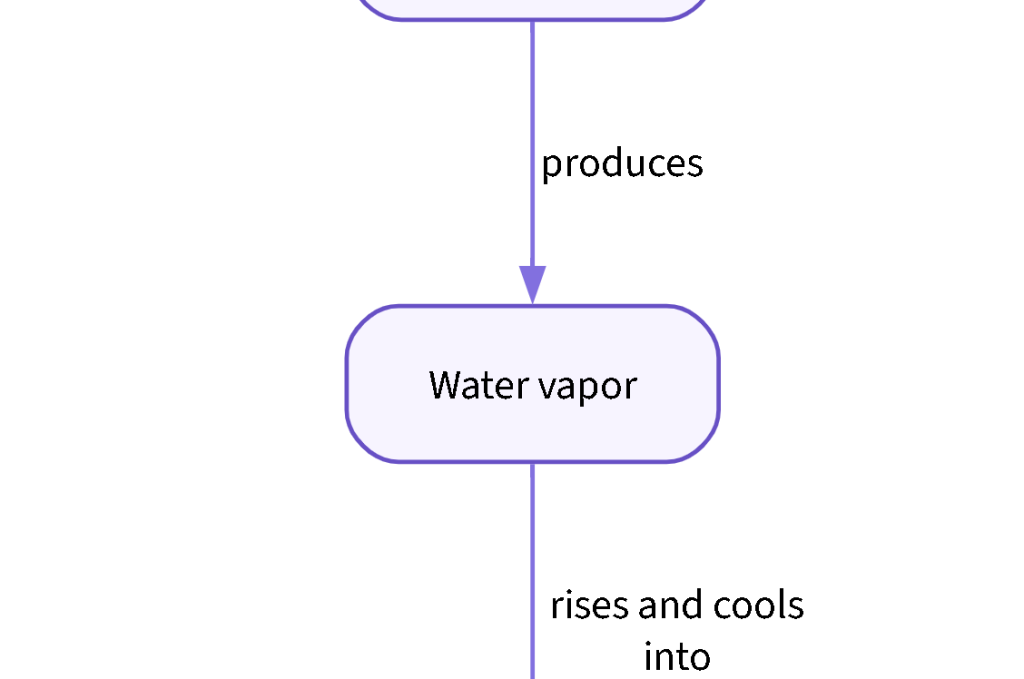
把輸入換成水循環後,Visual Flow 也會跟著內容重新生成。
這張圖對我來說比第一張還重要。
因為第一張馬達圖成功時,我還不能確定這是不是只是某種「剛好能跑的 Demo」。
但第二個完全不同的主題也可以生成,就代表目前至少真的有一條:
不同內容
↓
GPT 找出關係
↓
網站自動畫出不同的圖
而不是我先把馬達流程寫死在程式裡。
水循環圖雖然有成功生成,但下一個問題也馬上出現:
它超大。
只要節點稍微多一點、文字稍微長一點,Graphviz 就會為了塞下所有內容,把整張圖越撐越長,截圖都截不完。
像:
Rivers, lakes, and oceans
或:
rises and cools into
這類比較長的文字,很容易讓 Node 和箭頭間距越來越大。圖是畫出來了,但第一版的版面還完全稱不上漂亮。所以今天雖然第一次有真正的視覺化,但我也開始遇到「有圖」和「圖很好看」完全是兩回事。
後面還要處理的東西至少有:
也就是說,今天其實只是讓它第一次「畫得出來」。
要做到真的「好懂」,還有一段距離。
回頭看前幾天的進度:
Day 1
有一個想法

Day 2
做出介面

Day 3
GPT 開始看得懂內容

Day 4
GPT 看懂的內容第一次真的被畫出來
我覺得今天算是這個專案第一次比較對得起「Visual Learning Lab」這個名字。
現在它已經不只是把教材整理成另一堆文字,而是開始嘗試把「概念之間的關係」轉成真正的圖。
而且我也越來越確定後面的方向不應該只是:
所有東西都畫成 Flow。
真正想做的應該是:
讓 GPT 先判斷內容最適合怎麼呈現,再交給不同的視覺化工具。
有的內容適合 Flow,有的適合 Concept Map,有的可能適合 Comparison,後面如果做得出來,有些內容甚至可以真的進到 3D / Motion。
今天先讓第一張圖活起來,再慢慢讓它變得更像真的視覺學習。
GitHub Repo:
https://github.com/f24131128-lgtm/visual-learning-lab


 iThome鐵人賽
 看影片追技術