
🚦 任務狀態要記到別人接得下去:現在做到哪、在等誰、等到了從哪裡繼續。只有一個
running,誰也接不下去。
昨天在 Day 3|工具都接上了,事還是做不完:Agent 動手前、動手時、做完後,環境各要準備什麼,我們確認環境在 Agent 動手前、動手時、做完後,都給得出它需要的東西。接下來還有另一件事:任務跑到一半停下來等人,或是跑它的程式重啟了,系統要怎麼知道現在做到哪裡?
假設客服系統裡有一個 agent 在處理退款。使用者送出申請,Harness 開始跑 Day 1 那個 loop:模型先要求查訂單,再要求算金額,最後提出「送出退款」這個工具呼叫。這個工具被設成要主管核准才能執行,Harness 攔下呼叫、送出核准請求,loop 就停在這裡等一個人。
問題在停下來之後。申請的人看到的頁面只有 running。五分鐘後可能只是主管還沒看到;隔天還在轉,就分不出是主管真的沒批,還是跑這個 loop 的 process(下面叫 worker)已經掛了。值班的人重啟 worker,新的 worker 能查到的還是只有 running,它不知道該繼續等、從查訂單重來,還是再送一次退款。
這裡的 worker 指跑這個 loop 的 process:它打模型的 API、執行模型要的工具、把結果組回下一輪。同步版就是處理那個 HTTP request 的 handler,佇列版就是從 queue 撿任務來跑的常駐程式。模型在別人的伺服器上,worker 手上只有工具和自己的記憶體。
Day 1 的 loop 每轉一圈只做一件事:模型說要呼叫哪個工具,Harness 去執行,結果塞回下一輪,幾秒鐘就一圈。主管不是這種工具。核准請求送出去之後,沒有東西會馬上回傳,主管可能幾天後才在另一個頁面按下同意。這幾天 loop 轉不了,只能停下來,而 loop 本身沒有地方寫「我停在送退款這一步、在等主管」。
這段進度全在 worker 的記憶體裡:對話走到哪、查訂單和算金額的結果、停在送退款前這一步,worker 一掛就全沒了。所以 agent 跑起來之後,下一件事是把運行狀態搬到記憶體外面,也就是持久化。這篇先做第一步:決定要記什麼、記成什麼樣。以這筆退款來說是三件事:現在做到哪、在等誰、等到了從哪裡接著做。記清楚了,畫面才分得出正在做事、等人和真的卡住,接手的 worker 才知道從哪一步繼續。至於存在哪裡、worker 掛了怎麼從存檔接回來,Day 7 會詳細講。
所以今天要看的是:任務停下來等人、或換一個 worker 接手時,Harness 要記住哪些東西? 下面照這個順序:先看這份紀錄誰要讀、該掛在對話還是任務上;再看各家 SDK 怎麼切這件事;然後把狀態分好,定出最少要存的兩份紀錄;然後看等人時 loop 怎麼切成兩半、答案怎麼回來,最後處理兩個 worker 撞在一起。
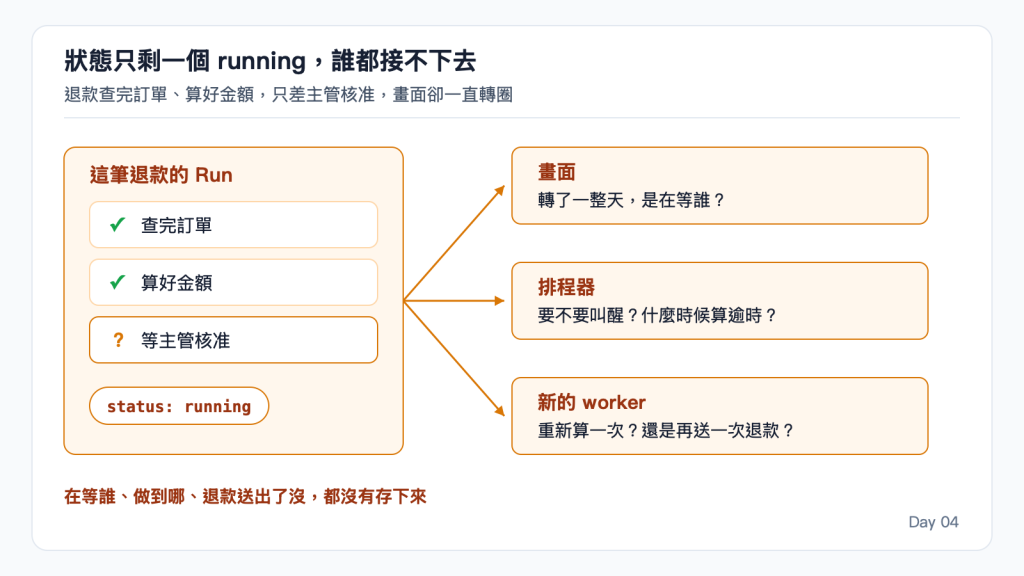
圖:同一個 running 傳到畫面、排程器和新 worker,三邊都不知道工作在等誰、做到哪一步,或退款有沒有送出去。
running 是給誰看的?退款那筆的狀態,至少有三個地方要讀:畫面要告訴使用者在等誰;排程器要知道什麼時候叫醒工作,什麼時候該當作 worker 失聯發告警;接手的 worker 要知道從哪一步繼續。這些事只藏在對話紀錄裡,其他服務很難可靠地查到。
排隊、等補資料、等核准、卡在服務故障,後續要做的事都不一樣;已經取消的工作,就算結果晚到,也不能自己繼續。這些全寫成 running,三個消費者拿到同一個字,誰也做不了下一步。
不過狀態也不用越拆越細。我會看這個差別有沒有影響通知、deadline、retry、資源使用或負責人。兩種狀態後續處理完全相同,先合併就好;一個要等使用者幾天,另一個要請管理者處理,就值得分開。後面要不要多拆一個狀態,都可以拿這個當作評估依據。
使用者還開著對話、退款還沒處理完、模型正在產生回答,這是三件事。全用一個 active=true 表示,連線一斷,就分不出哪一件還在、哪一件已經停了。所以先講清楚狀態掛在哪個東西上,還是用退款的例子:
這三個名字是我為了討論取的,各家 SDK 怎麼叫,下一節對照。
一個 Run 會跑好幾輪模型和工具,也可能中途等人。模型這一輪沒有再要求工具,不代表 Run 完成了。 它可能只是在問缺的資料,這時記 waiting_input;退款真的送出去、符合完成條件,才記 completed。
一步失敗是 Attempt 加一;整件事失敗要從頭重做,就開一個新 Run,記下它接的是哪筆原任務。別把舊 Run 的狀態改回 running,那會把它失敗的紀錄蓋掉。
我翻了幾家 SDK 的文件和原始碼,看它們怎麼切同一件事。這一節只看概念,不看具體存放邏輯。依據是 2026 年 9 月中的版本,之後可能會改。名字本身不重要,每家都不一樣,讀文件時要對的是邊界切在哪。
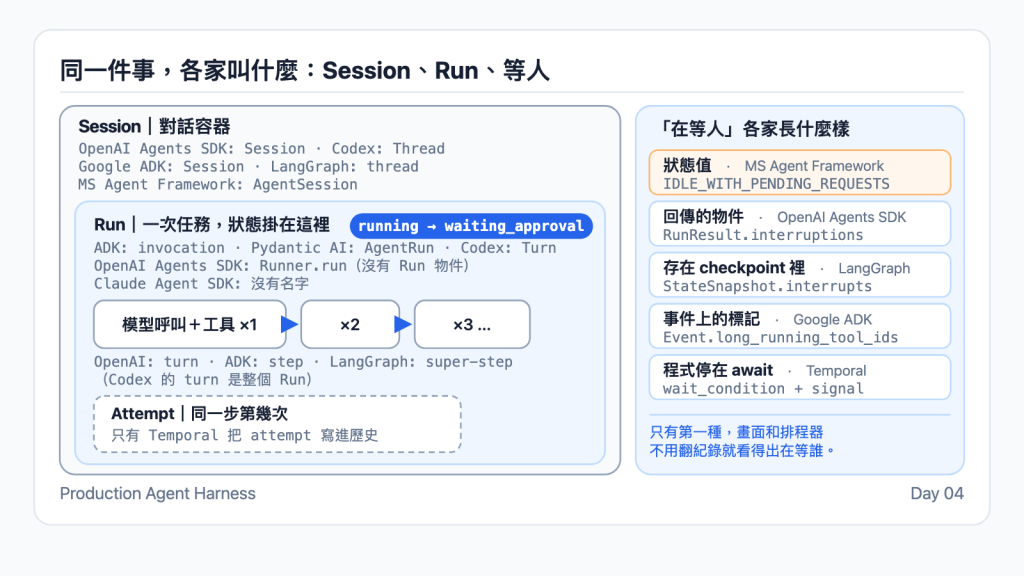
圖:各家怎麼切對話、一次任務、loop 一圈,右邊是等人記在哪。圖上的名字以各家文件為準。
最好認的邊界是「一次輸入到最後回覆」:使用者一句話或一個外部訊號進來,模型呼叫幾次工具,最後回一句話。各家的執行入口都是這個單位:OpenAI Agents SDK 的 Runner.run()、Google ADK 的 invocation、Codex CLI 的 Turn、Pydantic AI 的 AgentRun、Claude Agent SDK 的一次 query()。LangGraph 開源版沒有名字,要用它的 Agent Server 才有帶 status 的 Run。
往上一層是對話:把好幾次輸入到回覆串起來,共用同一段歷史。名字不是 Session 就是 Thread,意思都一樣。
往下一層是 loop 裡的一圈:一次模型呼叫,加上它引出的工具呼叫。OpenAI Agents SDK 叫 turn,max_turns 限的就是這個;ADK 叫 step,LangGraph 叫 super-step。只有一個字要小心:Codex 的 Turn 是整個一次輸入到回覆,OpenAI 的 turn 是裡面的一圈。看到 turn,先確認是哪一個。
這篇的 Run 跟上面哪一層都不一樣。處理一筆退款,順利的話就是一次輸入到回覆:申請進來、查訂單、算金額、送退款、回覆完成。但只要模型停下來問「要退哪一筆」,或是等主管核准,這一次回覆就結束了,事情還沒做完;等使用者補了資料、主管批了,再進來的那一次,還是在做同一筆退款。框架只認「一次輸入到回覆」,不認「同一筆退款」,所以 Run 這個單位要自己定義、自己存。Attempt 也是:OpenAI Agents SDK、LangGraph、Pydantic AI 的 retry 只是數到第幾次,程式一結束就沒了;只有 Temporal 把每一次嘗試當成一筆有編號的紀錄寫進歷史。
再來是等人。loop 停在「送出退款」前面等主管的那一刻,要留下三樣東西,對應後面 Run 上的三個欄位:
status):畫面和排程器問一句就知道,不用把整段對話或事件翻一遍。waiting_for):「送出退款」這個呼叫還沒執行,要主管點同意。checkpoint):查好的訂單、算好的金額、那個還沒執行的呼叫都留著,主管批了直接送,不用從查訂單重來。各家框架停下來等人時,這三樣給了哪幾樣,差別在「在等」這件事是誰記的、記在哪:
所以三樣裡,多數框架給的是後兩樣,「這筆在等」這一樣多半要自己記。這就是 Run 上要有 status 和 waiting_for 這兩欄的原因:框架不替你記,畫面和排程器就沒東西可讀。
下面沿用一組方便說明的狀態名稱,實際可以對應到現有系統,不用照著新增一套 API。用退款當例子:
| 狀態 | 屬於 | 意思 | 退款的例子 |
|---|---|---|---|
queued |
進行中 | 排到了,還沒有 worker 接 | 申請剛送進來 |
running |
進行中 | 有 worker 在跑 loop | 正在查訂單、算金額 |
waiting_input |
停下來等 | 等使用者補資料 | 模型問「要退哪一筆」 |
waiting_approval |
停下來等 | 動作已提出,等人核准 | 送出退款前等主管 |
blocked |
停下來等 | 卡在憑證或必要服務,昨天說的「做不成」 | 金流服務連不上 |
cancelling → cancelled |
結束 | 正在取消 → 確認相關工作都停了 | 使用者撤回申請 |
completed |
結束 | 符合完成條件 | 退款送出且收到回應 |
failed / expired |
結束 | 這次嘗試失敗 / 等超過期限 | 主管兩天沒批 |
outcome_unknown |
結束 | 外部請求送了,回應沒收到 | 退款送了,金流沒回 |
停下來等的三種都能回到 running;結束的不能再回去,要重做就另建 Run。
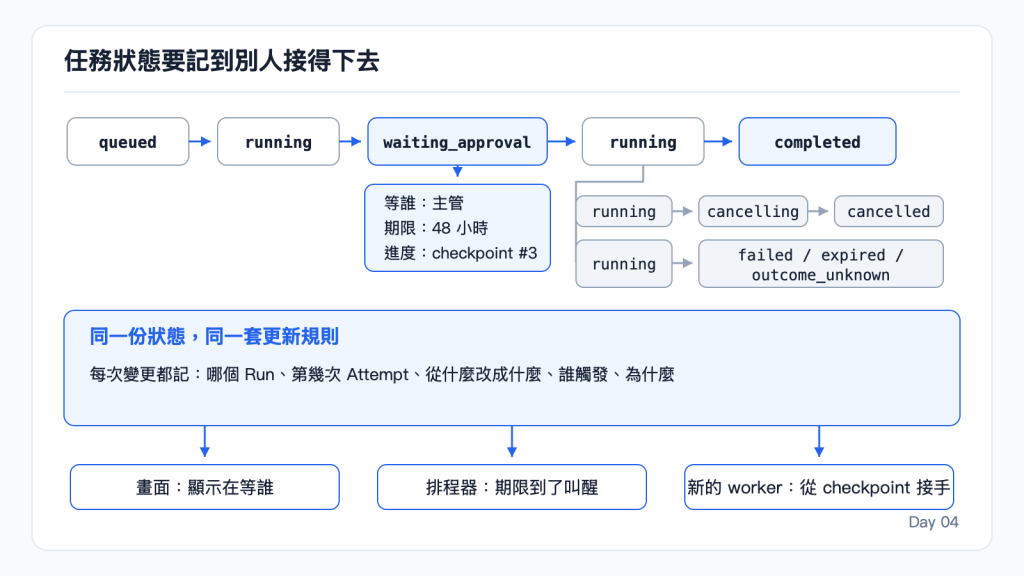
圖:退款這筆 Run 走過的狀態。等人時記清楚等誰、期限和進度,更新都走同一套規則,畫面、排程器和新 worker 讀的才是同一份。這是示意,不用照搬。
cancelling 和 cancelled 為什麼要分開:AutoGen Core 0.5.5 的文件說得很直接,runtime 的 stop() 不會自動取消正在處理的 handler,底下的呼叫還要配合 cancellation token,也就是一路往下傳、用來通知「請停下」的那個物件。停止接新工作和取消手上的工作是兩件事(這裡引用的是該版本,其他 SDK 要另外確認)。Temporal 也把取消(讓程式收拾)和終止(直接關掉)分成兩個操作、兩個狀態,同樣的道理。
failed 之後是另建 Attempt 還是留在 retrying,由產品決定。outcome_unknown 要先查帳再決定下一步,不能當作沒成功,也不能直接再送一次。
把上面講的落成東西,最小的版本是兩份紀錄加一個寫入用的 function。存在資料庫、SQLite 還是檔案都可以,先看要有哪些欄位。
第一份是 Run 的目前狀態,一個 Run 一筆,會被改。用退款卡在等主管那一刻的值來看,順便標每一欄是誰在讀:
| 欄位 | 退款卡在等主管時 | 誰讀、拿來做什麼 |
|---|---|---|
status |
waiting_approval |
畫面、排程器 |
waiting_for / wait_deadline |
approver:manager / 48 小時後 |
畫面顯示在等誰;排程器到期叫醒或告警 |
checkpoint |
做到第 3 步 | 接手的 worker 從這裡繼續 |
external_ref |
空,退款還沒送 | 接手的 worker 判斷能不能再送 |
version / attempt |
7 / 1 | 寫入時擋掉過期更新;這一步第幾次嘗試 |
owner / lease_until |
空,worker 已放掉 | 排程器:租約過了還是 running 就是失聯 |
id / session_id |
— | 連回對話 |
第二份是 變更紀錄,每改一次狀態就追加一筆,不改舊的。同一筆退款從等主管到完成,會留下這幾筆:
| seq | from → to | event | actor | at |
|---|---|---|---|---|
| 7 | running → waiting_approval | ApprovalRequested | worker-7 | 09-18 10:02 |
| 8 | waiting_approval → running | Approved | user:manager | 09-20 09:15 |
| 9 | running → completed | ToolFinished | worker-3 | 09-20 09:16 |
seq 跟著 Run 的 version 走。接手做完的是 worker-3,不是原本的 worker-7,從紀錄就看得出來;要帶原因就多一欄 reason。
寫入只走一個 function,UI、worker、排程器都不直接改 Run:
# pseudocode:所有狀態變更都經過這裡
def transition(run_id, expected_version, event, actor, reason=None, **fields):
    with store.transaction():
        run = store.load_run(run_id)
        new_status = next_status(run.status, event)   # 規則集中在這一個 function
        if new_status is None:
            return rejected(run.status, event)        # 例如 completed + RetryRequested

        # 條件更新:只有版本還是 expected_version 才寫得進去
        ok = store.update_run_if_version(
            run_id, expected_version,
            status=new_status, version=expected_version + 1, **fields)
        if not ok:
            return conflict()                         # 別人先改了,重新讀再決定

        store.append_transition(run_id, seq=expected_version + 1,
                                from_status=run.status, to_status=new_status,
                                event=event, actor=actor, reason=reason, at=now())
        return accepted(new_status)
條件更新和追加紀錄要在同一個 transaction 裡,不然 Run 改了、紀錄沒寫,或反過來,之後就對不起來。
呼叫 transition() 的有三種程式:跑 loop 的 worker、收畫面操作的 API server、看期限的排程器。用這筆退款走一遍:
| 誰呼叫 | 什麼時候 | event | 結果 |
|---|---|---|---|
| worker | loop 跑到「送出退款」被攔下 | ApprovalRequested | running → waiting_approval,一起填 waiting_for、wait_deadline、checkpoint |
| API server | 主管在後台按同意 | Approved | waiting_approval → running,Run 回 queue |
| worker | 退款送出、拿到回應 | ToolFinished | running → completed,external_ref 補上退款單號 |
| 排程器 | wait_deadline 過了主管還沒批 | Expired | waiting_approval → expired,發告警 |
| worker | 使用者已取消,工具結果才回來 | ToolFinished | 維持 cancelled,結果另外記 |
| API server | 有人對已完成的 Run 按重試 | RetryRequested | 拒絕;要重做另建 Run,連回原任務 |
每一次呼叫都帶著自己讀到的 version 進來,被人搶先改過就拿到 conflict,重讀再決定;後面「兩個 worker 同時接手」那節會用到。
next_status() 就是這張表左三欄對右欄的規則,集中在一個 function 裡,這種 function 常叫 reducer。規則集中,UI、API server、worker 和排程器才不會各自解讀。尤其任務已經取消,工具才回報完成,紀錄可以留,狀態不能改回執行中。
至少要有的就這幾樣:狀態掛在 Run 上,而不是掛在連線或 process 上;等誰、等到什麼時候;進度存在哪、外部操作的識別是什麼;一個版本號讓過期的更新被拒絕;每次變更留一筆。欄位可以再加,這幾樣少一個,前面某個讀者就做不了下一步。
退款要等主管核准,可能等上好幾天。同步版的 request 撐不了三天,佇列版讓 worker 掛著等也不划算。所以等人的時候,loop 要切成兩半,中間沒有任何 process 在等:
worker A
  loop 跑到「送出退款」,被攔下
  → transition(ApprovalRequested):status=waiting_approval、waiting_for=主管、
    checkpoint=目前的對話和那個還沒執行的工具呼叫
  → 發核准請求(待辦、通知),然後結束,process 可以死
  (幾天。沒有 process 在等,排程器只看 wait_deadline 有沒有過)
主管在後台按同意 → 一個全新的 HTTP request 打進 API server
  → transition(Approved):status=running → Run 丟回 queue
worker B(另一個 process)
  撿到 Run → 讀 checkpoint → 執行那個待送的「送出退款」→ loop 接著跑
後端做過金流 callback 或 webhook 的人對這個形狀很熟:發請求和收回應的不是同一個 process,靠一個 id 和一筆存起來的狀態接起來。Run 表就是那筆狀態。接回來的那半,程式大概長這樣:
# pseudocode:主管按下同意
def on_approval(run_id, expected_version):
    transition(run_id, expected_version, event="Approved", actor="user:manager")
    queue.push(run_id)

# pseudocode:worker 撿到 Run
def resume(run_id):
    run = store.load_run(run_id)
    state = load_checkpoint(run.checkpoint)      # 對話到目前為止、待執行的工具呼叫
    result = execute_tool(state.pending_call)    # 送出退款
    continue_loop(state, result)                 # 回到 Day 1 的 loop
各家框架差在前半怎麼存:前面三種立場裡,記成狀態和寫進存檔的,暫停本來就存著;當結果交給你的,要自己把回傳的暫停狀態存起來。LangChain 的 runtime 文章講的「等人時釋放執行資源、之後從 checkpoint 接手」就是這件事,這是 LangSmith Deployment 和 Agent Server 的能力,不是裝了 LangGraph 就有。
回來之後哪些動作能沿用、哪些要重做,還有 checkpoint 要存成什麼才撐得過 process 死掉,是 Day 7 的題目,這裡先不展開。
前面講的都是「重啟後接得下去」。還有一個相反的狀況:舊 worker 沒死透,新 worker 也接手了,兩邊同時改同一筆狀態。
Run 的 version 那一欄就是為這件事準備的:transition() 裡的 update_run_if_version 是條件更新,目前版本仍是 7 才能更新成 8,版本檢查和寫入放在同一個原子操作,一個 worker 寫成功後,另一個就得重新讀取再決定。owner 和 lease_until 則讓接手的 worker 先確認租約過期,才能把 owner 改成自己。Hermes Agent 的做法是在 SQLite 裡放一張租約表,記錄這段對話目前由誰在跑、什麼時候到期,其他 process 要等租約過期才能接手。
這些只保護資料庫裡的更新。已經送出去的退款、寄出的信、第三方寫入,version 和 checkpoint 都撤不回,要靠 external_ref 去查、下游去重或人工對帳,才知道重做會不會多生效一次。從 checkpoint 接回來也有同樣的問題:LangGraph 的文件明講恢復時那一格從頭重跑,暫停前做過的外部動作可能再做一次。所以送外部請求之前,先把要用的識別(例如退款的 idempotency key)寫進 external_ref,接手的人才查得到有沒有送過。
前幾天的寫法,對正在自己刻 Harness 的人來說可能有點抽象。所以從這篇開始,每篇最後固定留一節:如果你從頭實作 Harness,這篇講的東西要從哪裡切入、怎麼開始比較好,再對回上面的說明,整套怎麼運作會比較好懂。
假設你照 Day 1 從頭刻 Harness,loop 已經跑得起來:一個 process 收到訊息,把對話放在一個 list 裡,打模型、跑工具、回覆。接下來照這個順序加:
先給對話一個身分。 把對話紀錄搬出記憶體,用 session id 存起來,一開始一張表或一個 JSON 檔都行。每個 request 帶 session id 進來,Harness 照 id 把歷史載回來、接上新訊息、跑 loop,跑完寫回去。這步做完,process 重啟後對話還在,同一個使用者開好幾個對話也不會混在一起。Session 之間預設互相看不到:A 對話的歷史不會進到 B 的模型輸入,要跨對話記住東西(使用者偏好、上次做過什麼),得另外定寫入規則和有效期,那是 Day 12 的題目。歷史越長越貴,什麼時候該摘要、摘要能不能蓋掉原文,Day 11 再談。
再把工作從對話裡拆出來。 loop 第一次要停下來等人,或工具一跑就是幾分鐘,就是開 Run 表的時候。先把這篇的兩份紀錄和 transition() 做出來,狀態用 queued / running / completed / failed 四個起步;等人時填 waiting_for 和 wait_deadline,畫面和排程器一起讀這幾欄。用現成框架也一樣:先看它停下來等人時給了三樣裡的哪幾樣,缺的補在 Run 表,框架交回來的暫停狀態存起來就是 checkpoint。已經有 workflow engine,就讓它管等待、派工和恢復,Harness 接上任務目標、工具和完成條件就好。
然後測幾個容易出事的時間點。 兩個 worker 同時接手、取消後才收到工具結果、完成後又收到舊核准。這些事件可以記下來,但不能讓已結束的任務自己重新開始。上線後看各狀態待了多久、多少超過 deadline、多少次更新被拒絕,就知道要不要再拆狀態。
短而同步、沒有外部寫入、整段重跑也便宜的工作,做到第一步就夠,Run 表可以晚點開。需要等人、跨 request,或工具很昂貴,再補更細的等待原因。
這兩份紀錄後面幾天會一直被加東西:Day 5 講狀態是由哪些事件推出來的、順序亂了誰說了算;Day 6 把取消放進同一條順序;Day 7 講 checkpoint 要存成什麼、worker 消失後怎麼從存檔接回來。今天不用一次想完,先把 Session 和 Run 的邊界定下來,後面加的東西才有地方放。
回到那筆退款:主管還沒核准,worker 就先退出了,這一定算失敗嗎?新的 worker 只讀到 running,又能不能直接再送一次退款?
等人可以是正常狀態,前提是等待對象、期限和接續位置都有保存;只有 running 則不足以判斷該從哪一步繼續,更不能據此重做外部操作。
任務狀態要記到別人接得下去:現在做到哪、在等誰、等到了從哪裡繼續。 名稱可以依產品調整,畫面、排程器和接手的 worker 要讀到同一個意思。
今天的變更紀錄每改一次狀態追加一筆,順序由 seq 定。明天看的是事件本身:工具結果同時回來、畫面斷線重連,畫面、worker 和模型各自收到的順序可能不一樣,得先講好哪一份紀錄說了算。
stop() 不會自動取消執行中的 handler;用來說明 cancelling 和 cancelled 要分開記。Session 等幾種接續對話的方式,以及 turn 的定義(一次模型呼叫加它引出的工具呼叫);文件是 v0.22.3 當時的內容。Thread 與 Turn 的定義,Turn 涵蓋回應一句 prompt 的所有事件。invocation 和 step 的定義寫在 docstring 裡,含層級示意。session_id、resume、fork_session 的用法;一次任務沒有獨立的名字。thread 的定義,以及 checkpoint 以 super-step 為單位。AgentRun 物件;retry 只是計數器。WorkflowRunState 的七個值,其中兩個代表有請求還沒回;引用的是 main 分支該 commit。interrupt() 把 graph 狀態和待回的 Interrupt 存進 checkpoint,恢復時 node 從頭重跑。interruptions 列出待核准的工具,RunState 是可序列化的暫停邊界。long_running_tool_ids 標記未回的工具,is_final_response() 在這種情況也回 True。session_turn_leases 租約表,記錄目前由誰在跑、何時到期。

 iThome鐵人賽
 看影片追技術