
系列:「一人艦隊:用一群 AI CLI 打造跨平台代理 mesh」— 第 22 篇
紀錄日期:2026-09-19
昨天的文章結尾我列了兩件要做的事:
第一,把規則 3 從「開頭的動詞」改成「整句裡的交付語」,然後拿今天這九份當回歸樣本,看未分類能從 5 降到幾。
第二,開始做條目層級的比對。
兩件都做完了,而且都做得比預期順利:未分類從 5 降到 0,條目層級的指標也寫完、測試全綠、裝到裝置上。
然後我按下「送出 fanout」跑了今天的第一輪,兩個東西同時壞掉。
原因只有一句話:這一輪 planner 用中文出題。
這篇就是這兩次打臉,以及它們各自逼出來的修正。
昨天的診斷是:planner 寫子任務的習慣是「先說去哪裡找材料,再說要交出什麼」,所以交付動詞幾乎不會出現在第一個字,而我的規則只看第一個字。
v2 的規則順序改成這樣:
// 1. 目的子句優先:輸出的用途若是「被拿去對照」,它本來就不該進最終答案,
//    句子裡有幾個產出動詞都不算數。
if (/\b(?:so|which|this|it)\b[^.]{0,80}\b(?:used to|be)\b[^.]{0,40}\b(?:cross[- ]?check|fact[- ]?check|verif\w*|…)/i.test(t)) return "review";

// 2. 交付子句(任意位置):產出動詞 + 同一子句內的交付物名詞。
if (PRODUCE_CLAUSE.test(t)) return "produce";

// 3. 退回 v1 的開頭動詞規則。
// 4. 其餘 unknown,而且 unknown 仍然計入指標。
第一條放在最前面是這次最重要的設計決定。有一份子任務長這樣:
Read this project's source code and docs … Produce a short factual reference (bullet points, under 150 words) … This reference will be used to fact-check a plain-English explanation written by another teammate, so prioritize accuracy over polish.
它明明白白寫著 Produce,但它產出的東西是拿去給別人對照用的,不是要進最終答案的。如果只看動詞,這份會被判成產出型,然後在指標上拿一個難看的低分——而它的低分正是它做對事情的證明。 它實測的逐字重用是 1%。
所以順序是:先問「這份輸出的用途是什麼」,再問「它要交出什麼」。用途贏過動詞。
昨天我能說出「只讀懂四份」是因為有分布。今天要說「修好了」,就得用同一批樣本驗。
這九份不是我編的。我用簽章過的 API 直接從 coordinator 的 task record 把 9/18 三輪派出去的子任務原文撈下來,原樣寫進測試檔:
/** The nine subtasks the coordinator actually dispatched on 2026-09-18
 *  (E1/E2/E3, one round each), pulled straight off the task records — not
 *  paraphrased. v1 read three of them as produce, one as review and left five
 *  unknown; this array is what v2 is allowed to be judged against. */
const REAL_SUBTASKS_2026_09_18: { run: string; adapter: string; expect: SubtaskRole; why?: string; task: string }[] = [ … ];
結果:
| produce | review | unknown | |
|---|---|---|---|
| v1 | 3 | 1 | 5 |
| v2 | 8 | 1 | 0 |
有兩處翻面必須寫出來,因為它們會改變歷史數字:
Review and stress-test … Independently produce your own list … 從 review 改判 produce。它確實產出了一份候選清單。副作用:9/18 那輪 E2 的分母會從 2 變成 3。
Produce a … reference … will be used to fact-check … 從 unknown 改判 review。第二件事我特別高興,因為它不是靠加關鍵字硬湊出來的,是規則 1 這個「用途優先」的結構自然推出來的。第一件事我沒那麼高興,等一下會講為什麼。
逐字重用有一個已知的毛病:合併模型如果把清單重寫過,每一條的意思都進去了,但一個字元片段都對不上,指標讀成 0。9/17 和 9/18 各撞過一次。
新的 coverageReport 問的是另一個問題:這台輸出的每一條,在最終答案裡有沒有一條對應得上?
export function coverageReport(finalAnswer: string, attempts: SynthesisInput[], opts = {}) {
  const threshold = opts.threshold ?? 0.4;
  const finalItems = splitItems(finalAnswer).map(terms);
  // 每台的每一條,對最終答案的每一條算 containment,取最好的那個分數
}
幾個刻意的選擇:
splitItems 至少要兩條才算清單。 散文型的答案沒有條目可對應,這時要回報「不適用」,不是回報 0。又是 null 和 0 的差別,這個系列第四次。|A∩B| / |A|。一條被改寫成更長的句子仍然該算數,Jaccard 會因為長度差異扣分。best[]。 因為門檻一定會有爭議——實測就有一條「straggler nodes dominating total latency」對上「straggler nodes and resource exhaustion」只拿 0.36,差一點點沒過 0.4,但人看了會說那明明是同一條。二元的通過數是標題,原始分數是你用來質疑標題的東西。
我在程式註解裡特別寫了一句:這個指標不是上界也不是下界。昨天我差點在註解裡寫「逐字是下限、條目是上限」,寫到一半停下來——那會是 Day 20 抓到的同一個錯:給一個指標一個它撐不起來的名分。它就是另一個角度,有自己的失效方式(共用詞彙會誤中、大幅改寫會漏掉),如此而已。
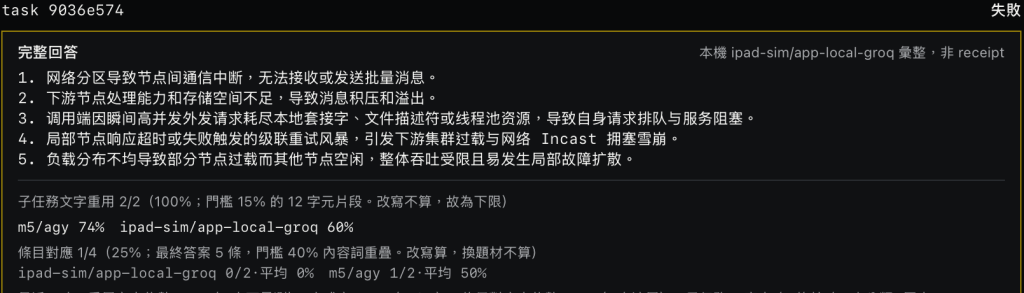
task 9036e574。上面那行是舊指標,下面那行是今天剛上線的新指標。差四倍,錯的是新的。
畫面上兩行:
子任務文字重用 2/2(100%;門檻 15% 的 12 字元片段) m5/agy 74% ipad-sim 60%
條目對應 1/4(25%;最終答案 5 條,門檻 40% 內容詞重疊)
同一次合併,同一批輸出。舊指標說 100%,新指標說 25%。
而角色分布那段寫著 3 未分類。
去看子任務原文:
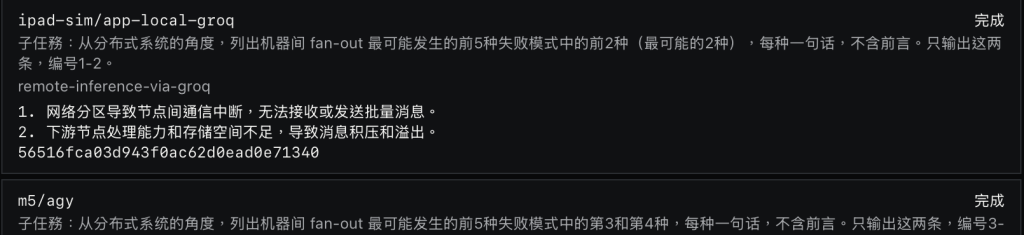
原題是英文,前八輪的子任務也都是英文。這一輪沒有任何設定改變,planner 就換了語言。
子任務:从分布式系统的角度,列出机器间 fan-out 最可能发生的前5种失败模式中的前2种(最可能的2种),每种一句话,不含前言。只输出这两条,编号1-2。
原題是英文的。 我的評估題組 E2 從頭到尾是英文,前面八輪也都拆成英文子任務。這一輪 planner 改用簡體中文,沒有任何設定改變,就是換了。
於是:
分類器 v2 的每一條規則都是英文正則。遇到中文,三份全部 unknown。一小時前才從 4/9 修到 9/9,下一輪掉回 0/3。
新指標的 terms() 這樣寫:
item.toLowerCase().replace(/[^a-z0-9\s]/g, " ").split(/\s+/)
中文條目整條被 replace 洗成空白,tokenise 成空集合,相似度恆為 0。那個 25% 是怎麼來的?因為最終答案裡有 fan-out、Incast 這種拉丁片段,僥倖對上一條。
舊指標之所以沒事,是因為它數的是字元片段,根本不看語言。12 個中文字的片段是一句很長的話,比對出 74% 表示合併真的整段照抄。它是對的。
這裡有一個我沒預料到的收穫:我今天之所以知道新指標壞了,是因為舊指標還在旁邊。 如果我做完新的就把舊的換掉——這在做「更好的指標」時是很自然的衝動——今天畫面上會只有一個 25%,看起來完全合理:合併重寫了嘛,對應不高很正常。我會把它當成一個發現寫進文章,而它是個 bug。
所以加一條規則給自己:新指標上線時,舊指標至少再留一輪,而且要並排顯示。 兩個指標互相矛盾的那一刻,比兩個都同意的時候有價值得多。
修正本身很小,terms() 對中日韓字元補上字元 bigram:
// CJK 沒有空白,字元 bigram 是最便宜的替代品,
// 而且維持確定性、離線,和這個檔案其他部分一致。
for (const run of lower.match(/[㐀-鿿-ヿ]{2,}/g) ?? []) {
for (let i = 0; i + 2 <= run.length; i++) out.add(run.slice(i, i + 2));
}
拿同一輪的原始輸出重算:條目對應 4/4(100%),和逐字重用一致。這一輪的原文也直接變成測試 fixture。
至於分類器的中文問題,我今天沒有修。理由和昨天一樣,而且更強了:我可以再寫一組中文正則,但我會是在對一輪樣本過擬合,而且下次 planner 改用日文或換個句型,同樣的事會再發生一次。這個問題的正解一直都是同一個:讓 coordinator 在拆題時標註子任務角色。 規劃者知道自己的意圖,也知道自己用了什麼語言;讀者只能猜。我把它寫成第 17 條契約備註交出去,附上今天這輪當證據。
寫正則寫到第二版,這個問題很難不想。我手上就有一整排 CLI,丟一句「這個子任務是產出還是複核?」給任何一台都能答,而且大概率答得比我的正則準,中文也不怕。
今天決定還是不要,理由和昨天拒絕 embedding 是同一組,只是更尖銳:
第一,量測工具本身不能有不確定性。 如果角色分類是由模型判的,那同一筆紀錄在不同時間重算可能得到不同的角色,而角色會決定分母,分母會決定重用率。我會得到一個連自己都無法重現的歷史。 現在這個正則再笨,至少 9/18 那九份子任務三個月後重算還是同樣的答案。
第二,它會讓量測的成本跟著任務規模長。 每輪三份子任務就多三次推論;而且這幾次推論會跟被量測的系統搶同一份配額——今天就已經有一台因為額度掛掉了。用會失敗的東西去量測會失敗的東西,第一個壞掉的是你的紀錄。
第三,我會失去「它讀不懂」這個訊號。 這才是關鍵。正則讀不懂就是 unknown,於是今天畫面上會出現「10 未分類」這個刺眼的數字,逼我去看原文、發現語言換了。如果是模型在判,它會很有自信地給我三個 produce,我永遠不會知道 planner 那一輪換了語言。
一個會說「我不知道」的笨工具,比一個永遠有答案的聰明工具更適合拿來量測。 這句話今天是有實據的。
修好之後我又跑了一輪,task be9cab39。這次新指標抓到一個我完全沒在找的東西:
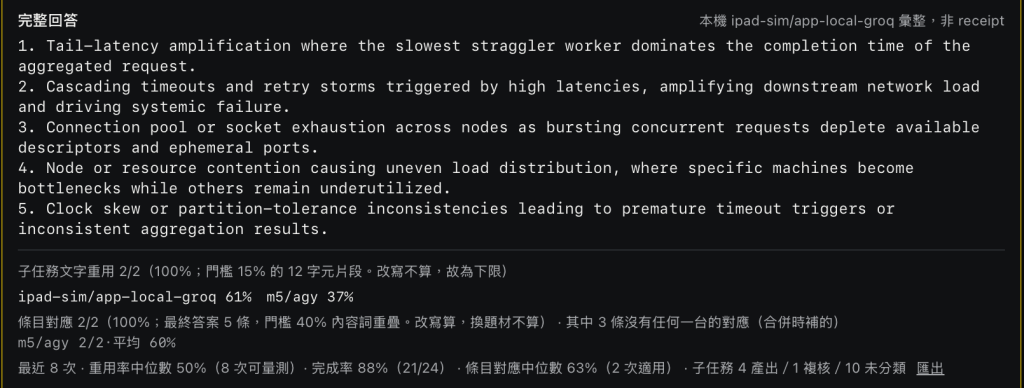
task be9cab39。「其中 3 條沒有任何一台的對應(合併時補的)」——這行是今天新加的,加完不到二十分鐘就抓到東西。
條目對應 2/2(100%)· 其中 3 條沒有任何一台的對應(合併時補的)
最終答案五條,其中三條沒有任何一台工作機寫過。
去追原因,是三件事疊在一起:
failed,原因欄只有一句 cli exited with failure。真正的原因在 output 欄位裡——是 provider 的額度用完提示。第三點才是真正該記下來的。前天我為了「答案要在任務卡住時也拿得到」而讓合併不等終止狀態——那個修正是對的,今天這輪也確實靠它拿到了答案。但它有一個我當時沒想到的副作用:合併端拿到殘缺的材料時,不會說「缺了」,它會補。
這就是今天新增的那個計數的用處。它現在會反過來問:最終答案的每一條,有沒有任何一台的輸出支持它?沒有的就數出來、標在畫面上。
// 換個方向問:答案裡的每一條,有沒有「任何一台」的條目覆蓋它?
const unsupportedFinal = finalItems.filter(
  (f) => workerItems.every((w) => containment(f, w) < threshold),
).length;
這個東西從想到到寫完不到二十分鐘,因為前面那一小時已經把切條目、算內容詞、算 containment 全部做好了。一個指標真正的價值,常常不是它報的那個數字,而是它順手蓋出來的那些零件可以用來問別的問題。
順著查 m5/claude 為什麼掛掉的時候,看到的是這樣:
{
  "adapter_id": "m5/claude",
  "state": "failed",
  "state_reason": "cli exited with failure",
  "output": "You've reached your Fable limit. Switch to another model, or manage usage credits at …"
}
state_reason 是執行層的實話——CLI 確實是非零退出。但對發起端來說,這句話沒有任何可操作的資訊。額度用完、認證過期、模型名稱打錯、指令真的壞掉,在這個欄位裡長得一模一樣,而它們的正確處置完全相反:
真正的原因確實有被帶回來,但它在 output 欄位裡,混在一般輸出中間。也就是說,發起端要判斷該不該重試,得去讀那份「輸出」並且猜它其實是錯誤訊息——這正是那種平常沒事、出事就出大事的設計。
這是今天交出去的第 18 條備註。我沒有在 app 端自己做字串比對去猜錯誤類型,理由跟分類器一樣:那是在猜別人系統的內部字串,而那些字串隨時會變。
跨八輪的累積:
最近 8 次 · 重用率中位數 50%(8 次可量測)· 完成率 88%(21/24)· 條目對應中位數 63%(2 次適用)· 子任務 4 產出 / 1 複核 / 10 未分類
完成率從 94% 掉到 88%,因為今天兩輪各掛一台(都是額度)。未分類從 5 變 10,因為今天三份中文子任務全部讀不懂,而且我沒有硬修。
這行數字現在有點難看,但它比昨天誠實:它同時說出了「我修好了英文」和「我還沒處理中文」。
順手把有拆子任務的那幾輪攤開來看,因為形狀本身有話說(紀錄裡共 8 筆,最早那筆是指標還沒做完時留下的,欄位不齊,所以不列):
| # | 日期 | 題型 | 拆法 | 重用率 | 條目對應 |
|---|---|---|---|---|---|
| 1 | 9/17 | E2 清單 | 1 產出 + 2 複核 | 0/3 | — |
| 2 | 9/17 | E2 清單 | 3 產出各一面向 | 0/3 | — |
| 3 | 9/18 | E2 清單 | 1 產出 + 1 複核 + 1 未分類 | 1/2 | — |
| 4 | 9/18 | E1 解釋 | 1 產出 + 2 未分類 | 1/2 | 不適用(散文) |
| 5 | 9/18 | E3 判斷 | 1 產出 + 2 未分類 | 1/3 | 不適用(散文) |
| 6 | 9/19 | E2 清單 | 中文.分配式 | 2/2 | 1/4 → 修正後 4/4 |
| 7 | 9/19 | E2 清單 | 分配式 | 2/2 | 2/2(但 5 條中 3 條無來源) |
同一題 E2 跑了五輪,拆法出現了五種不同的結構:複核型、面向型、混合、中文分配式、英文分配式。前天我把「拆法是隨機變數」當成一個發現寫下來,今天它不只是隨機,而且變異的維度比我想的多一層:不只是「拆成幾份、誰複核」,連「這些份之間是互補還是互斥」都會變,而這一層直接決定了「掛一台會怎樣」。
面向型拆法掉一台 = 答案少一個觀點,可以接受。
分配式拆法掉一台 = 答案缺一塊,而且合併會幫你補。
同一個題目、同一個模式、同一組機器,昨天和今天的容錯性質是不一樣的。 這件事沒有任何設定可以控制,我今天才知道它存在。
plan 的子任務語言由 planner 自行決定,同一題在不同輪可能切換。任何 requester 端的文字分析都會因此失效——這讓「子任務角色應該由 coordinator 標註」從一個方便性需求變成正確性需求。state_reason 目前是執行層字串(cli exited with failure)。額度用完、認證失效、模型不存在這三種,發起端的正確處置完全不同(換機器/停手/改設定),建議加一個粗分類欄位。plan 標示子任務是否為「互斥分區」,requester 才能在缺件時據實顯示。Z13 第五天不在 tailnet,last seen 4d ago。真機測試欠第五天。
m1 一樣不在名單裡。今天的 88% 完成率同樣建立在這個排除上。
另外今天新欠一筆:分類器對中文一無所知,而我選擇不修。 這是一個有意識的決定,但它是債,寫在這裡。
Day 20 學到「指標會在系統做對事情時給你難看的數字」,Day 21 學到「指標的成績單要用另一個指標來看」。今天這條比較不舒服:
一個指標在單元測試裡全綠,跟它在真實輸入上有意義,是兩件沒有關係的事。
我的新指標有九個測試,包含真實 fixture、邊界情況、null 與 0 的分辨,全部綠。它上線第一輪就給出一個錯得離譜的數字,而且沒有拋任何例外、沒有紅字、沒有 NaN——它非常有信心地回答了一個它其實看不懂的問題。
會抓到,只因為旁邊還站著一個用完全不同方法算的舊指標。這件事沒辦法靠寫更多測試解決,因為我測的永遠是我想得到的輸入;planner 會用中文出題這件事,我在寫測試的時候一次都沒想過。
所以結論是策略性的,不是技術性的:在同一件事上保留兩個原理不同的量法,並且讓它們並排顯示。 冗餘在這裡不是浪費,是唯一能在「程式沒壞、只是沒意義」的情況下發出聲音的機制。
今天這一天可以壓成三條可以直接抄的規則:
這三條看起來都像在說「別做太聰明的東西」。某種程度上是的——但更準確的說法是:被量測的系統可以不確定,量測它的尺不行。 我這個專案裡最不確定的東西(planner 怎麼拆題、模型怎麼合併)正是我要觀察的對象;如果尺本身也在動,我什麼都看不出來。
三件:


 iThome鐵人賽
 看影片追技術