
系列:「一人艦隊:用一群 AI CLI 打造跨平台代理 mesh」— 第 21 篇
紀錄日期:2026-09-18
昨天結尾我寫了一句承諾:
讓 planner 在拆題時標註每個子任務是「產出」還是「複核」。指標只對產出型計算重用率。
今天做完了,但做完之後看到的東西跟我預期的差很多。預期是「排掉複核型,數字會變好看一點」。實際發生的是三件事:指標第一次給了分(而且其中一輪高到 78%)、我的分類器被自己的統計抓包只讀得懂九份子任務裡的四份、以及 planner 拆同一題的方式根本是隨機的。
還附帶撿到一個全新的失敗模式,是這個專案寫了三週以來第一次看到。
Z13 今天第四天不在 Tailscale 網路上。coordinator 一樣是這台 Mac 的 daemon,凍結名單一樣是 f1524c32:iPad 上的 app-local 模型、這台機器上的 claude 和 agy。m1 一樣被排除在外,一樣是債,這點等一下會再提。
昨天我加了一個叫 classifySubtask 的東西,從 planner 自己寫的子任務文字判斷這份工作是「產出」還是「複核」。複核型不列入重用率的分母——因為一份複核型輸出不出現在最終答案裡才是做對了,用逐字重用率去打它的分數,等於懲罰規劃者做了正確的拆解。
問題是:那個判斷結果只活在畫面上。合併一跑完、畫面一換,它就沒了。
這跟前天那個「採用率只顯示不儲存」的毛病一模一樣,而我昨天才剛修過那個毛病。差別只在於,昨天我修的是「數字」,今天要修的是「這個數字是怎麼算出來的前提」。
如果我要回答「這個分類器到底是不是裝飾品」,我需要的不是某一輪的畫面,是跨輪的分布。 九份子任務裡,有幾份被讀成產出、幾份被讀成複核、幾份根本讀不懂?這個比例本身就是分類器的成績單。
所以今天的程式改動只有一句話可以描述:每一行紀錄多帶一個角色分布。
export type RoleCounts = Record<SubtaskRole, number>;

export interface RunRecord {
  // …原本的欄位
  /** 這一輪各角色的份數;沒有子任務文字可讀時為 null */
  roles: RoleCounts | null;
}
寫這段的時候踩到跟前天一樣的坑,只是換了個位置。
buildRunRecord 收到的是一串 attempt。我把它的型別從 { state } 改成 { state; task? },然後對每一份跑分類器。但這裡有兩種「沒有角色」長得很像:
第一種是「我不知道」,第二種是「我知道,答案是零」。如果兩種都寫成 {produce: 0, review: 0, unknown: 0},那這個欄位以後完全不能拿來分析,因為你永遠分不出「這輪真的沒拆」和「這輪的資料漏了」。
所以:
// 「沒人傳 task」和「planner 沒拆子任務」是兩件事,
// 只有後者值得記一個零。
const knowsTasks = input.attempts.some((a) => a.task !== undefined);
const roles = knowsTasks
  ? input.attempts.reduce((acc, a) => {
      acc[classifySubtask(a.task ?? null)] += 1;
      return acc;
    }, { ...ZERO_ROLES })
  : null;
同一個原則在跨輪加總那邊也要守住:昨天以前寫下的紀錄沒有 roles 這個欄位,它們必須被排除在加總之外,而不是被當成三個零。不然我會看到一個被稀釋過的分布,然後對著它下錯結論。
const withRoles = runs.filter((r) => !!r.roles);
// …
runs_with_roles: withRoles.length,
roles: withRoles.length ? roles : null,
這件事我這三天寫了三次,位置都不一樣:採用率的 ratio、完成率的 completion_rate、今天的 roles。三次都是同一個問題:平均值和比率天生會把「沒資料」偽裝成「資料是零」,而零看起來非常像一個結論。
畫面上多一句話:
最近 6 次 · 重用率中位數 42%(6 次可量測)· 完成率 94%(17/18)· 子任務 3 產出 / 1 複核 / 5 未分類
測試三支檔案 42 個綠、tsc 零錯。(全庫另外有 15 個既有的失敗測試,跟這次改動無關——我在改動前後各跑了一次確認數字相同,這種事必須自己先確認過再寫出來。)
新加的三個測試我刻意不自己編字串,一律用 coordinator 這幾天實際派出去過的子任務原文當 fixture:
it("reads the split off the planner's own wording", () => {
  const r = buildRunRecord({
    // …
    attempts: [
      { state: "completed", task: "Write the deliverable: a ranked list of five items with one sentence each." },
      { state: "completed", task: "Review the other answers for factual errors and list any you find." },
      { state: "completed", task: "Consider whether the ordering holds." },
    ],
    adoption: null,
  });
  expect(r.roles).toEqual({ produce: 1, review: 1, unknown: 1 });
});
第三句 Consider whether … 就是我故意留成 unknown 的那種——它既不是明確的產出也不是明確的複核,而我寧可讓它掛在未分類,也不要用一條「猜起來像產出」的規則把它塞進分母。自己編的測試字串會讓分類器看起來比實際準,因為我編字串的時候用的是跟寫規則同一顆腦袋。
另外兩個測試分別守住上面說的 null 與全 unknown 的區別、以及跨輪加總時舊紀錄要被排除。第三個測試的註解我寫的是 // recorded before Day 21——三個月後看到這行,至少知道那個 null 不是 bug。
前天我固定了一組三題的評估題組:E1 解釋型、E2 清單型、E3 判斷型。固定題目的理由前天寫過:兩次跑分只有在問題一樣的時候才可比。今天第一次把三題各跑一輪,同一組參與者、同一個 manifest、都選「拆成子任務」。
| 題型 | task | 狀態 | 重用率 | 各台 | 角色分布 |
|---|---|---|---|---|---|
| E2 清單 | 6783d7ea |
全部完成 | 1/2(50%) | ipad-sim 29% ✓、m5/agy 2%、m5/claude 複核·不計 | 1 產出 / 1 複核 / 1 未分類 |
| E1 解釋 | f2da70f6 |
失敗 | 1/2(50%) | m5/claude 78% ✓、m5/agy 1% | 1 產出 / 0 複核 / 2 未分類 |
| E3 判斷 | 5c4606f1 |
全部完成 | 1/3(33%) | ipad-sim 23% ✓、m5/agy 13%、m5/claude 3% | 1 產出 / 0 複核 / 2 未分類 |
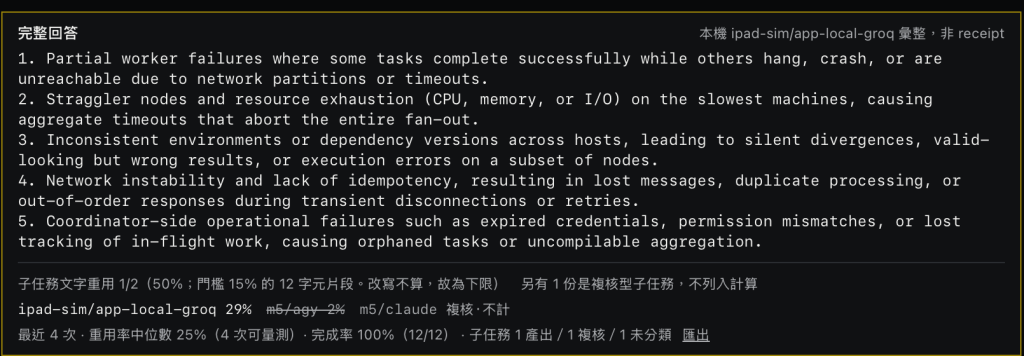
E2 清單型,task 6783d7ea。三台全部完成;m5/claude 被判為複核型,退出分母。
上面這張是 E2 那輪的畫面。看那行小字:
子任務文字重用 1/2(50%;門檻 15% 的 12 字元片段。改寫不算,故為下限) 另有 1 份是複核型子任務,不列入計算
ipad-sim/app-local-groq 29%m5/agy 2%m5/claude 複核·不計
這是這個指標第一次不是零。前天和昨天連續兩輪 0/3,昨天我已經寫下「合併模型傾向重寫而不是引用」當成結論。今天這一輪就把那個結論削掉了一半。
最極端的是 E1 那輪:
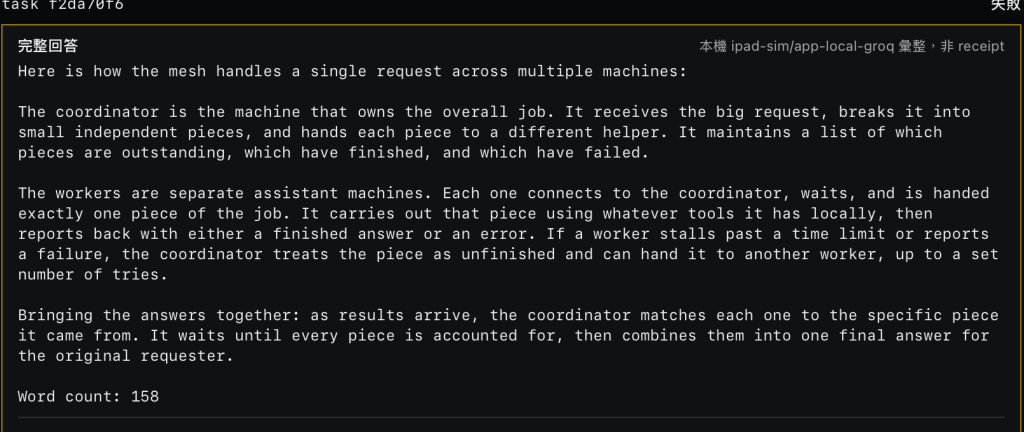
E1 解釋型,task f2da70f6。m5/claude 78%——合併模型幾乎整段引用。同一輪也是唯一一次 incomplete_receipt。
m5/claude 78%。這台的輸出有將近八成的字元片段原封不動出現在最終答案裡——合併模型幾乎是整段抄過去的。
回頭看題目就懂了。E1 是「用白話跟新同事解釋這個 mesh 怎麼跑」,輸出是一段散文。散文型的答案,合併的時候最省力的作法就是挑最好的那一份、微調、送出。而 E2 是「列出五個最可能的失敗方式,一行一個」,清單型的答案,合併的時候必須把三份清單去重、重排、重寫成一致的語氣——每一條都會被改寫,逐字重用自然趨近於零。
所以昨天那句「合併在重寫」不是通則,是清單型題目的行為。
這件事對指標的意義比對系統的意義大:
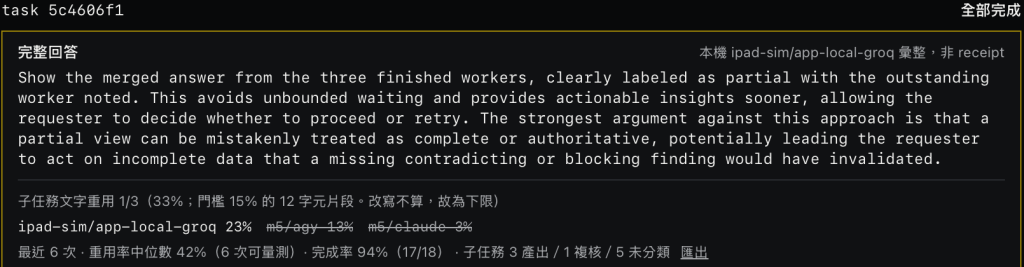
六輪累積下來的那一行。最後一段「子任務 3 產出 / 1 複核 / 5 未分類」是今天新加的。
E3 是判斷型:「一個任務卡住了,三台完成、一台永遠不回報。該給發起人一份合併的答案,還是什麼都不給直到全部回報?給一個建議,以及反對它的最強論點,120 字以內。」
這題有趣在它逼出一個結構完全固定的答案:一句建議 + 一句反論。三台的重用率分別是 ipad-sim 23%(過門檻)、m5/agy 13%、m5/claude 3%,合計 1/3。
去讀原始輸出就會發現這個 33% 其實低估得很嚴重。planner 這次把題目拆成「寫最終交付」「建立支持合併的論據」「建立反對合併的論據」,最終答案的兩句話分別來自後兩台的立場——支持方的「避免無界等待、更早給出可行動的資訊」和反對方的「部分視圖可能被誤當成完整或權威」都完整進了答案,只是被重寫成一句話。
換句話說,這一輪三台全部有實質貢獻,指標說 1/3。這正好是昨天那個「逐字重用是下限」的結論再一次實證,而且這次不是猜的——我能指著最終答案的第二句話說出它是誰的論點。
也因為這樣,這一輪讓我更確定明天該做的是條目層級的比對,而不是把門檻從 15% 調低。調門檻只會讓 13% 和 3% 這兩個數字跨過一條更低的線,那不是量到了,是把標準放寬。
六輪跨輪彙總那行裡,真正讓我停下來的是最後一段:3 產出 / 1 複核 / 5 未分類。
九份子任務,有五份我的分類器讀不出來它到底是要產出還是複核。超過一半。
這正是昨天沒有把角色記下來、只看單輪畫面時看不到的事。昨天那輪三份全是產出型,我當時的感想是「分類器運作正常」。今天把分布攤開來才發現,正常的是那一輪,不是分類器。
去讀那五份的原文,原因非常一致:
Read this project's source code and docs to find the actual coordinator/planner logic … Produce a short factual reference …
Provide supporting evidence for the operator's question about how a fan-out fails in practice. Inspect the current working directory …
Build the case FOR showing a merged partial answer: in under 80 words of plain prose, list the concrete benefits …
三句都是先給研究指示、交付動詞擺在句子中段。而我的規則 3 寫的是「開頭是產出動詞(write/draft/produce/…)」。
規則本身沒寫錯,是看錯了位置。planner 寫子任務的習慣是「先說去哪裡找材料,再說要交出什麼」,所以真正定義角色的那個動詞幾乎不會在第一個字。
我今天沒有急著改這條規則,理由有兩個。第一,我想先讓這個分布多累積幾輪,確認「交付動詞在中段」是穩定的模式,而不是這三輪的巧合——改規則很容易,但改完之後我就失去了「改之前長什麼樣」的對照組。第二,更根本地說,這件事的正解不是讓我的正則表達式更聰明,而是讓 planner 自己在拆題的時候標註角色。它知道自己的意圖,我只能猜;而且各家發起端各猜各的,猜出來的數字彼此不可比。這是我前天就交出去的契約備註 (14),今天多了九份樣本當佐證。
不過有一點值得記在旁邊:分類器讀不懂的時候,那份輸出仍然計入指標。這是昨天刻意設計的保守行為——寧可把一份複核型誤算成產出型(拉低分數),也不要把一份產出型誤排除(虛報分數)。今天的五份未分類全部進了分母,而三輪還是都有非零的採用,所以這個保守選擇沒有把訊號蓋掉。
E2 這一題,三天內我用同樣的參與者、同樣的模式跑了三次,拆出來是三種:
昨天我在報告裡寫「這次 planner 給的是三份產出型」,語氣是把它當成那一題的性質。今天這一輪直接證明那是錯的:拆法本身是隨機變數。
這件事會污染我到目前為止做的每一個跨輪比較。今天 E2 的 1/2 和昨天 E2 的 0/3,差的不只是合併行為,還差在一份被排除的複核型、以及分母從 3 變成 2。兩個數字放在同一條趨勢線上,其實比較的不是同一件事。
補救方式不是消除隨機性(我也控制不了 planner),而是把變因記下來——這恰好就是今天加的 roles 欄位存在的理由。今天早上我加它的動機是「回答分類器是不是裝飾」,到了晚上它變成「讓跨輪比較有機會被校正」的東西。這種事在這個專案裡發生過好幾次了:一個為了 A 加的欄位,真正的價值在 B。
E1 那輪 task 狀態是失敗,十八次 attempt 裡唯一的一次失敗,原因是這個:
incomplete_receipt: nonce not echoed in the output
iPad 上的 app-local executor 有跑、有產出答案、也回報了,但輸出裡沒有帶回 coordinator 發下來的 nonce,於是依契約 §6 被拒收。
這是三週以來第一次看到 §6 的 nonce 檢查在真實執行中生效。在此之前它每次都通過,通過到我幾乎忘記有這個檢查。今天它擋下了一份答案——而且擋得對:手機端的執行是 BYOK、推論跑在雲端 provider,把 nonce 原樣帶回輸出,是唯一能證明「這份輸出確實是為這次 attempt 產生的」的機制。沒有它,一份快取的舊答案跟一份新答案長得一樣。
但發起端的體驗不好:畫面上整個 task 變成「失敗」,而失敗原因只在那一格 attempt 裡。從使用者的角度,他看到的是「這題失敗了」,不是「有一台的回報格式不合格,另外兩台的答案還在」。這兩件事該不該重試的答案完全相反——格式問題重試同一台還是會失敗。
所以今天多交一條契約備註出去:
failed,發起端無從判斷。順帶一提,合併照樣完成了——因為前天修好的那件事:合併不再等 task 進入終止狀態,有幾份可用就先給答案。如果是四天前的版本,今天這輪會是「一台格式錯 → 整題失敗 → 使用者什麼都拿不到」。修一個看起來像 UI 細節的東西,四天後救了一輪實驗。
這個紀錄從第一天就是可匯出的(一行一個 JSON 物件,最舊的在前,任何日誌工具都吃得下)。今天多了 roles 之後,一行大概長這樣:
{"task_id":"6783d7ea…","at_unix":1758204…,"coordinator":"http://127.0.0.1:7878",
 "manifest_sha8":"f1524c32","plan_mode":"split","dispatched":3,"completed":3,
 "failed":0,"pending":0,"task_state":"completed","merged":true,
 "roles":{"produce":1,"review":1,"unknown":1},
 "adoption":{"adopted":1,"considered":2,"reviewers":1,"ratio":0.5,"shingle":12,"threshold":0.15}}
這一行裡有三組數字,分別回答三個不同的問題:
dispatched / completed / failed / pending → 這次派出去的工作,有多少真的回來了(系統健康度)。roles → 規劃者把這題拆成什麼形狀(今天新增,也是唯一一個描述「輸入」而不是「結果」的欄位)。adoption → 回來的東西有多少進了答案(貢獻度)。刻意把三組放在同一行,是因為它們只有擺在一起才有意義。完成率 100% 但採用率 0/3,跟完成率 60% 但採用率 2/2,是兩種完全不同的狀況,而任何一個單獨的數字都會把它們說成同一件事。今天多加的 roles 又補上第三個維度:分母本身是怎麼被決定的。
順帶一提,threshold 和 shingle 也一起寫進每一行。這兩個是指標的參數——門檻 15%、片段長度 12 個字元。哪天我把門檻調成 10%,舊的紀錄仍然知道自己是用哪個門檻算出來的,不會被新參數追溯汙染。這是前天做這個紀錄時唯一一個「以後一定會慶幸」的設計,今天第一次真的用到:我今天差點就為了 E3 那三個 23/13/3 去調門檻。
m1 今天一樣是 offline,一樣不在名單裡。今天的完成率 94%(17/18)、昨天的 100%,都建立在「把那台拿掉」這個前提上。這句話我每天都寫一次,不是因為我喜歡自首,是因為完成率這種數字最容易被單獨引用。
Z13 第四天不在。欠著的真機測試也就欠了第四天。我已經把腳本準備好了,它一回來就能重跑;但「準備好了」不等於「驗過了」,這條也得照實寫著。
寫到這裡一定會有人想問:既然逐字重用這麼不準,為什麼不直接用 embedding 算語意相似度就好?
我想過,今天決定先不做,理由有三個,寫下來備查:
一,它會把「可解釋」換掉。 現在畫面上那個 29%,我可以告訴使用者它的意思是「這台輸出裡有 29% 的 12 字元片段原封不動出現在答案裡」。這句話任何人都能自己驗證——複製兩段文字、用眼睛找就行。換成 cosine similarity 0.71 之後,沒有人能驗證它,包括我自己。在一個要給別人看的儀表板上,可驗證比準確更重要,至少在早期是。
二,它會把成本和不確定性帶進量測本身。 算 embedding 要嘛跑本地模型(手機上不行)、要嘛打 API(要金鑰、要配額、要網路)。也就是說,量測這件事本身會開始失敗、會有延遲、會因為換了模型版本而讓歷史數字不可比。我現在這個指標的優點是它永遠可算、算出來永遠一樣——一段純函式,離線、確定性、零成本。這種性質在累積趨勢的時候價值很高。
三,我還沒把便宜的方法用完。 條目層級的比對(把兩邊都切成條目,再看有沒有對應)介於逐字和語意之間,仍然是確定性的、可解釋的,而且對清單型題目幾乎一定比字元片段準。先把它做完,如果還是不夠,再談 embedding。
這三條合起來其實是同一個判斷:在觀測工具上,我願意用精確度換確定性。 一個永遠能算、算法透明、但偏保守的指標,比一個更準但偶爾失效、沒人能驗證的指標,更適合拿來累積三十天的趨勢。
昨天我寫:指標會在系統做對事情的時候給你難看的數字。今天學到的是反過來的那一面:
指標的成績單,要用另一個指標來看。
我昨天做的分類器,用「它在某一輪的表現」去判斷是沒有意義的——那一輪三份全是產出型,它一份都不用分類就「正確」了。真正讓它現形的,是九份樣本的分布:4 讀得懂、5 讀不懂。
換句話說,我為了量測 mesh 而做的東西,本身也需要被量測;而且量測它的方法跟量測 mesh 是同一套:累積、記錄、看分布、回頭讀原始資料。
這大概是這個系列做到第三週最具體的一個體會。一開始我以為「做觀測」是一件做完就結束的事——加一個數字、顯示在畫面上、完成。實際上它是遞迴的:你加的每一層觀測,都會變成下一層要被觀測的對象。停在哪裡是選擇,但至少要知道自己停在第幾層。
兩件事。
第一,把規則 3 從「開頭的動詞」改成「整句裡的交付語」,然後拿今天這九份當回歸樣本,看未分類能從 5 降到幾。這是今天刻意沒做的那一步,因為我想先有對照組。
第二,開始做條目層級的比對:清單型題目的每一條,是否有對應的條目進入最終答案。這才是逐字重用率真正該被取代的地方——今天 E1 的 78% 和 E2 的 29% 差距這麼大,有很大一部分只是「散文比清單容易被原句抄走」,跟貢獻多寡沒有關係。
Z13 如果回來,先重跑欠著的真機測試。


 iThome鐵人賽
 看影片追技術