
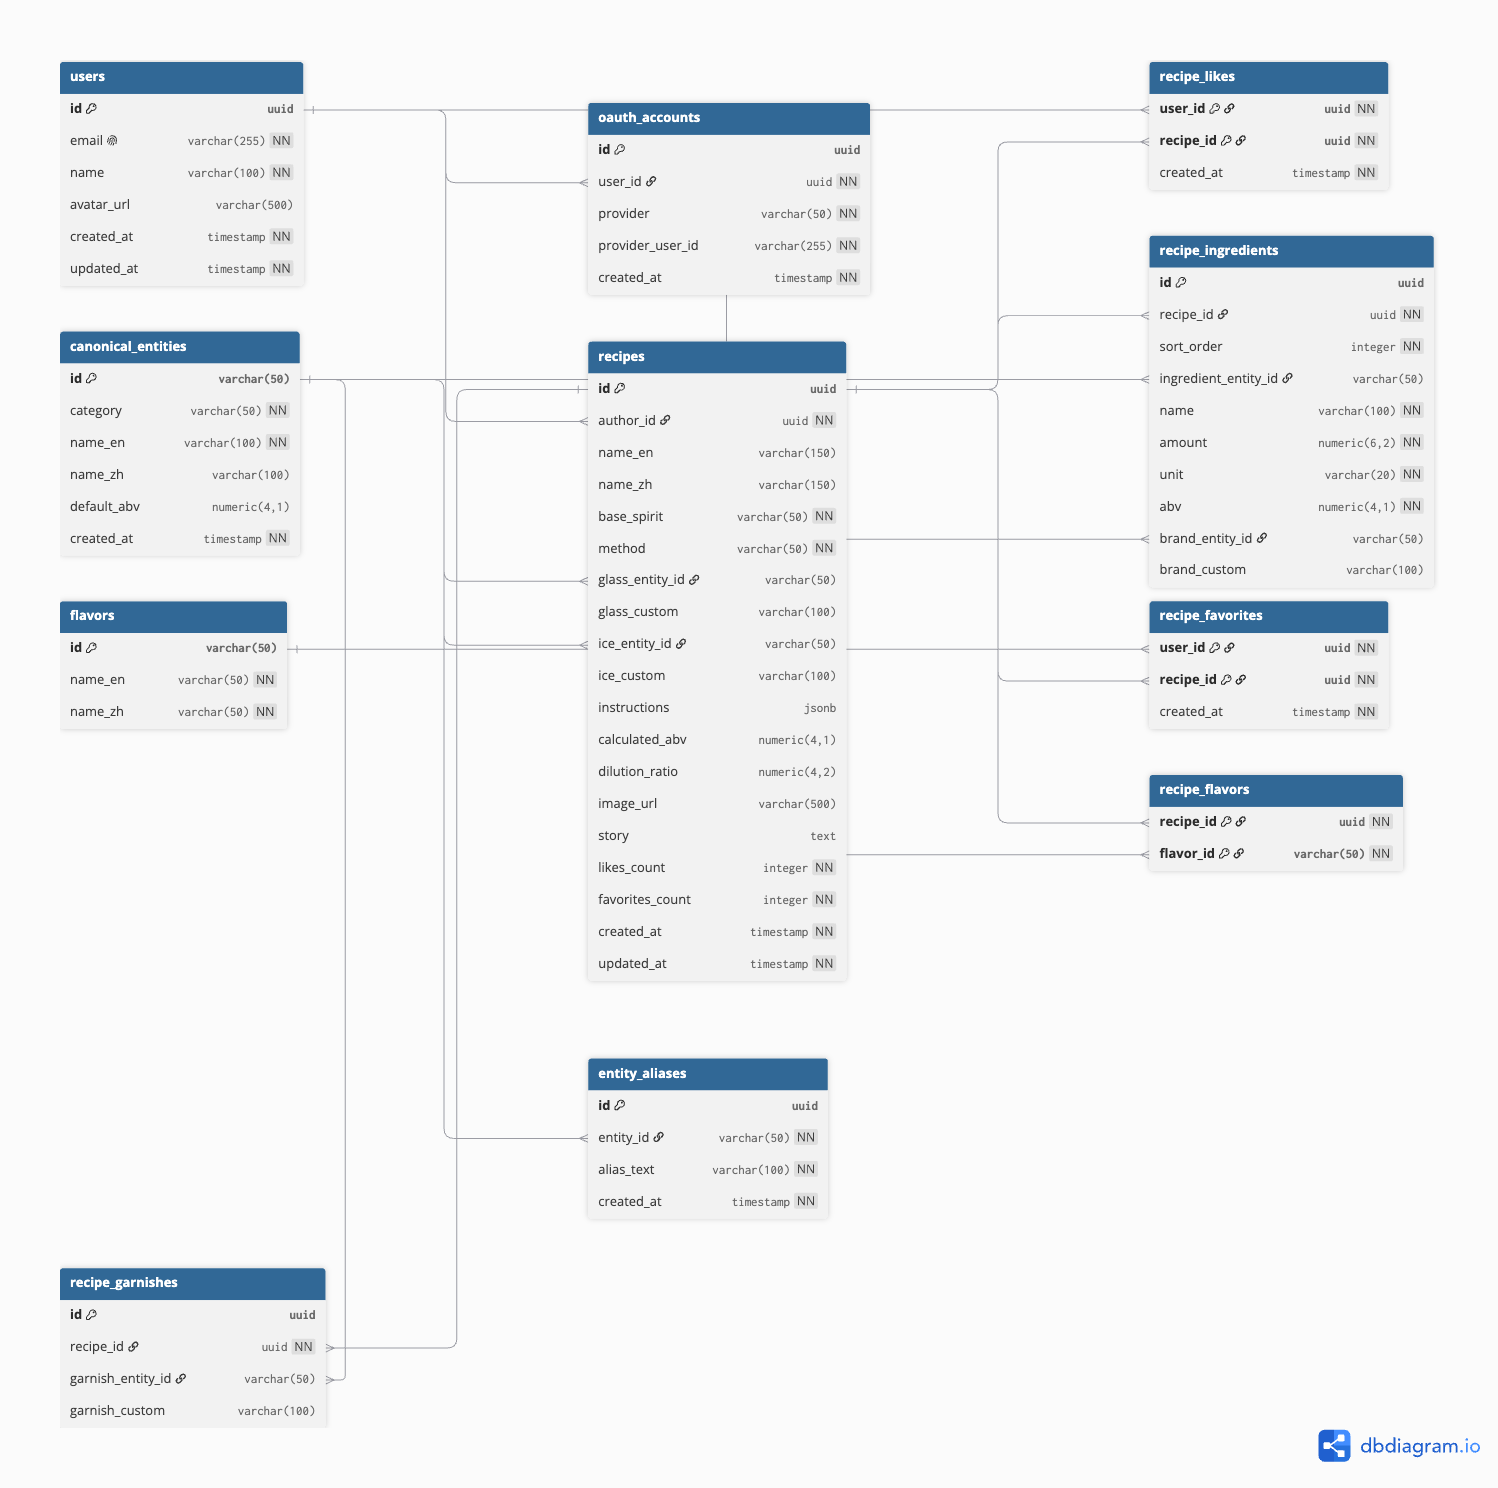
我不太想要花時間實作複雜的帳號密碼管理,所以一律使用 Google 帳號登入註冊,以此為前提,讓 AI 設計一下資料模型吧!
為避免洗版,DBML 的原始連結就放這:dbdiagram
初版的 DBML 理所當然有點脫離預期:
按讚數 likes_count 與收藏數 favorites_count 其實可以用 COUNT 算出來,目前關聯沒有很多層,應該不用寫進酒譜:
Table recipes {
  id uuid [pk, default: `gen_random_uuid()`]
  author_id uuid [not null, ref: > users.id]

  // 名稱二擇一必填邏輯於應用層或 DB CHECK 約束驗證
  name_en varchar(150)
  name_zh varchar(150)

  base_spirit varchar(50) [not null, note: 'gin, rum, vodka, whisky, tequila, etc.']
  method varchar(50) [not null, note: 'shake, stir, build, blend, layer']

  // 雙軌制:可連結標準實體,亦保留自訂字串
  glass_entity_id varchar(50) [ref: > canonical_entities.id]
  glass_custom varchar(100)

  ice_entity_id varchar(50) [ref: > canonical_entities.id]
  ice_custom varchar(100)

  garnish_entity_id varchar(50) [ref: > canonical_entities.id]
  garnish_custom varchar(150)

  // 調製步驟:多行純文字(每行代表一步驟,前端組合與解析)
  instructions text [note: '調製步驟純文本,每步驟換行儲存 (e.g. 1. ...\n2. ...\n3. ...)']

  // 運算結果快取
  calculated_abv numeric(4, 1) [note: '依液體量、度數與融水係數計算之出杯 ABV']
  dilution_ratio numeric(4, 2) [note: '套用之融水比例,如 0.33']

  image_url varchar(500)
  story text

  likes_count integer [not null, default: 0]
  favorites_count integer [not null, default: 0]

  created_at timestamp [not null, default: `now()`]
  updated_at timestamp [not null, default: `now()`]

  indexes {
    author_id
    base_spirit
    method
    calculated_abv
  }
}
填表單時有個調製步驟沒有被寫到酒譜的模型!
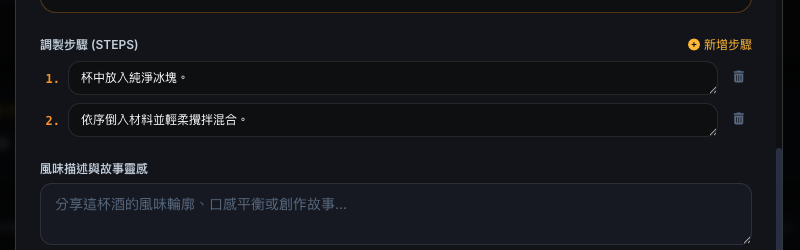
這部分也值得想一下是要把每個步驟再拆成一張表,還是純文本紀錄就好?我覺得可以先以純文本來存,前端用固定的格式把步驟拆開就好。
AI 的建議是存成 jsonb (PostgreSQL),我覺得也可以接受,這樣前端拆資料就很方便了!
我重新開了一個對話來診斷初版的 DBML,也給出了一些可行的建議:
強化 canonical_entities 的約束:新增 entity_category Enum,將 canonical_entities.category 改為該 Enum 型別,防止打錯字的材料存進來
統一容量單位:移除自由填寫的 unit 欄位,改為語意更精準的 amount_ml numeric(6, 2),前端到時再換算成 oz 或其他單位就好
重新修正後,我自己對照下來,覺得差不多可以先實作看看了!
唯一比較不懂的是我還真的沒用過 index 的功能,雖然知道它的作用是讓查詢變快,但效果如何,後面也可以等整個 MVP 做好後,測試看看實際差異。


 iThome鐵人賽
 看影片追技術