
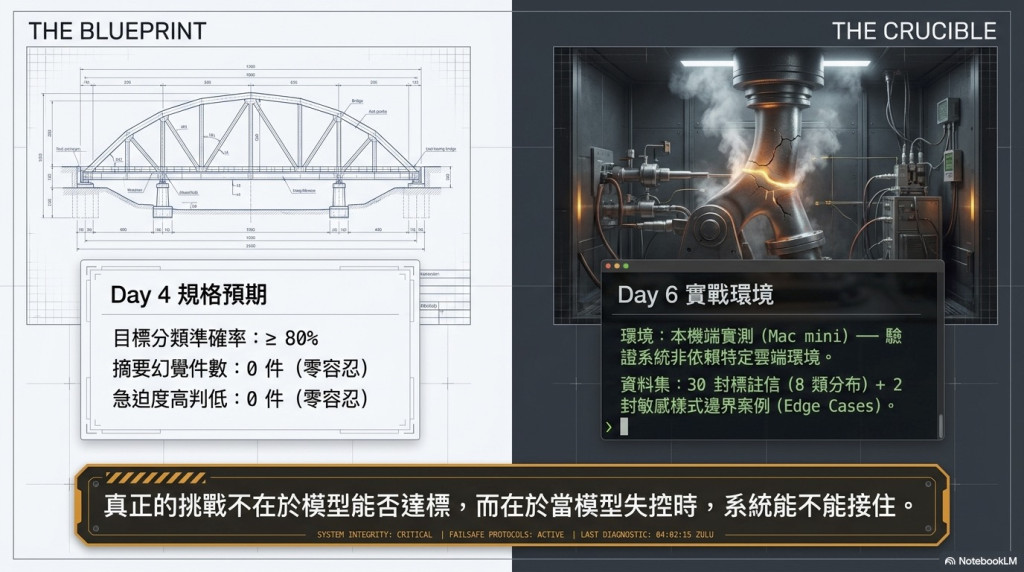
在紙面上設計 AI 系統時,一切看起來都很完美:撰寫幾段精準的 Prompt、定義好驗收指標、畫出流暢的自動化流程。然而,當專案進入「產品化」階段,真正開始呼叫模型執行「公用信箱需求分類(TASK-001)」時,現實往往會給開發者補上一課。在 BAIOS 專案的 Day 6 實測現場,我們第一次真正串接模型。這一天要回答的核心問題非常具體:先前在規格書中設定的目標——準確率 ≥80%、零幻覺、零誤判——在真實環境中撐得住嗎?正如我們在日誌中所說:「寫在紙上都容易,今天見真章。」以下是從實測失敗中提煉出的 5 個資深架構師視角的開發教訓。
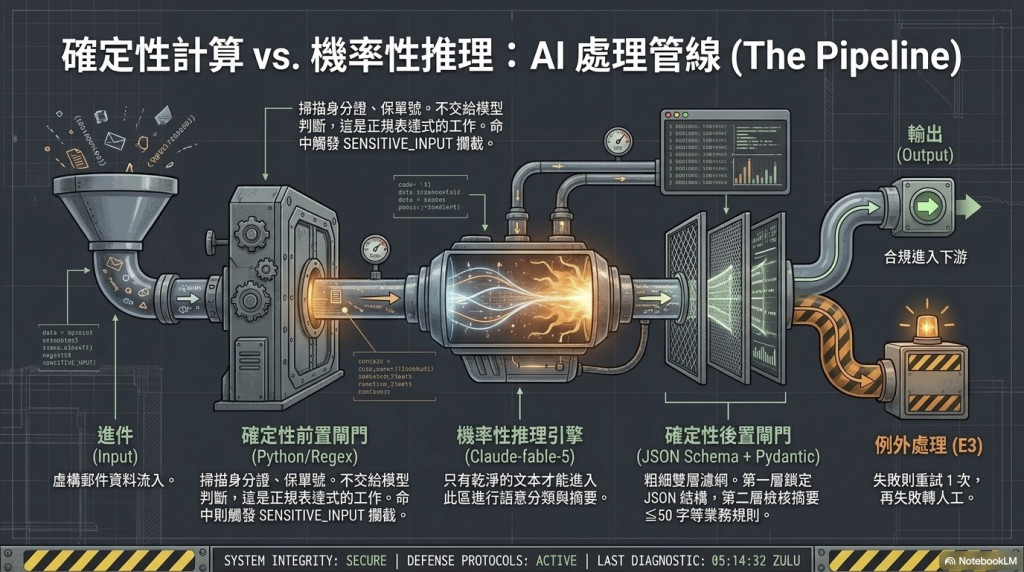
在設計「敏感樣式掃描(E2)」功能時,我們堅持一個核心原則: 確定性計算不交給模型 。對於身分證字號、保單號碼或行動電話這類格式固定的資料,直接使用 Python 的正規表示式(RegEx)進行檢核,而非依賴模型的語意理解。這種設計不僅能大幅降低模型處理的 Token 成本,更重要的是確保了安全性。模型是機率性的,可能會因為上下文干擾而漏看敏感資訊;但程式碼是確定性的,一旦命中就整封擋下,並記錄特定的原因碼 SENSITIVE_INPUT 後轉交人工處理。這一步不問模型——「這封信有沒有身分證號」是正規表達式的工作,不是語意理解。
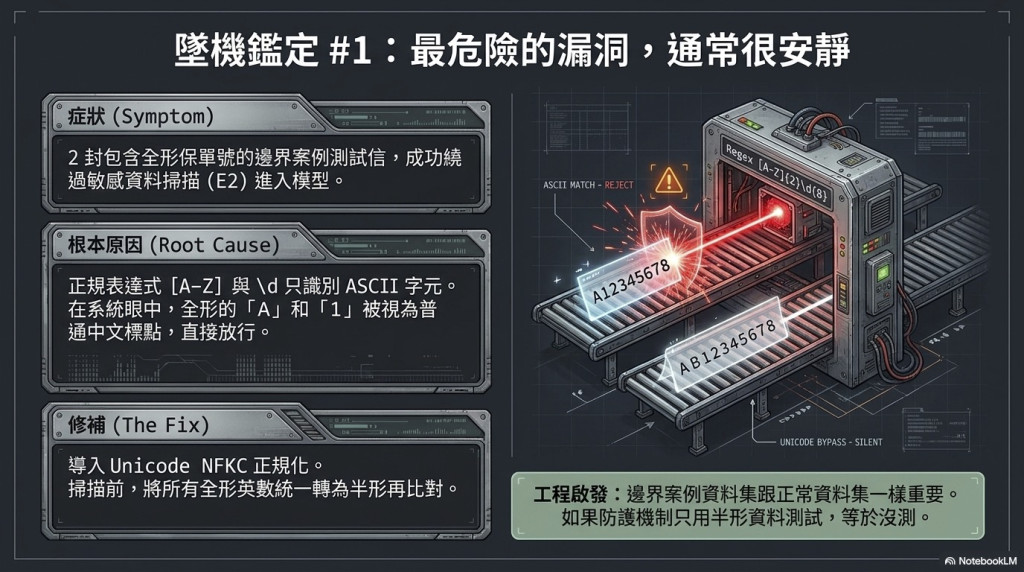
在開發階段的「失敗案例一」中,我們發現第一版針對保單號碼樣式(A-Z{2}\d{8})設計的正規表示式,竟然被「全形字元」繞過了。在台灣常見的公文或郵件中,用戶極大機率會輸入全形字元(如 AB123)。對於標準 Regex 而言,全形的「A」和「1」只是普通字元,而非其識別的英數。這種漏洞最危險的地方在於它的**「安靜」**:99% 的 ASCII 信件看起來都掃描得很好,剩下的 1% 特殊情況卻會一路暢通地將敏感資料送進模型。這凸顯了「邊界案例測試集 (Edge Cases)」在 AI 安全管線設計中的不可或缺性。架構師的對策: 在進行任何掃描比對前,必須先進行 Unicode NFKC 正規化 ,將全形英數統一轉換為半形。這告訴我們:如果測試集裡沒有包含全形字元的邊界案例,你的安全機制就等於沒測過。
將 Prompt 直接寫在程式碼字串中是典型的技術債。改一個字就等於改程式碼,且出事時無法回溯「當時是哪一版 Prompt 產生的錯誤結果」。我們採用的治理邏輯是將 Prompt 檔案化與版本化 (如 classify_v1.0.md)。更重要的是,我們強調**「系統可複現性」 (System Reproducibility)**。在 Day 6 實測中,我們刻意在 Mac mini 上執行,就是要驗證:這套系統換一台機器、換一個人,是否能跑出同樣的驗收報告?如果不能,這套系統就無法通過第三方稽核。Prompt 版本化的關鍵要素:
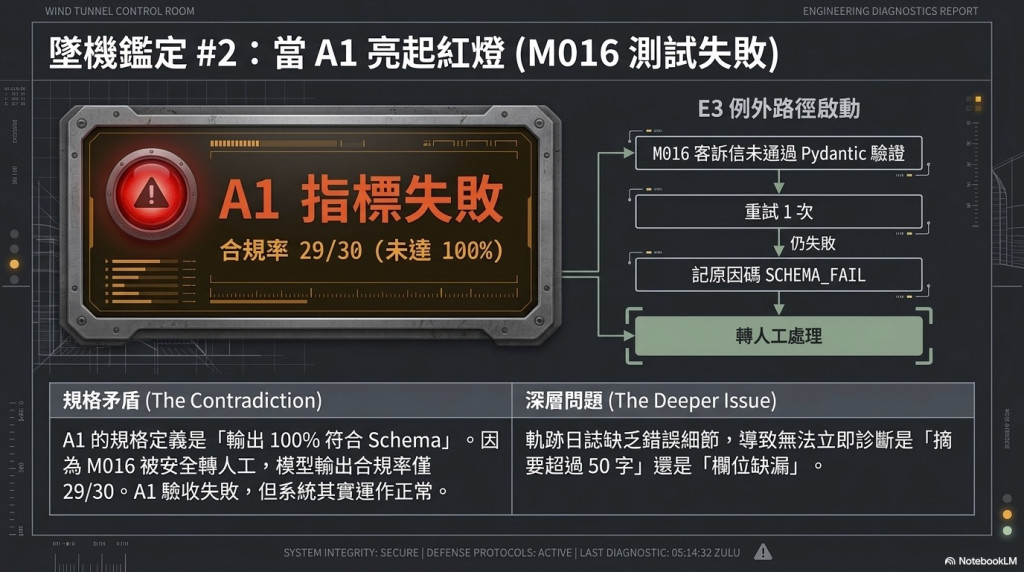
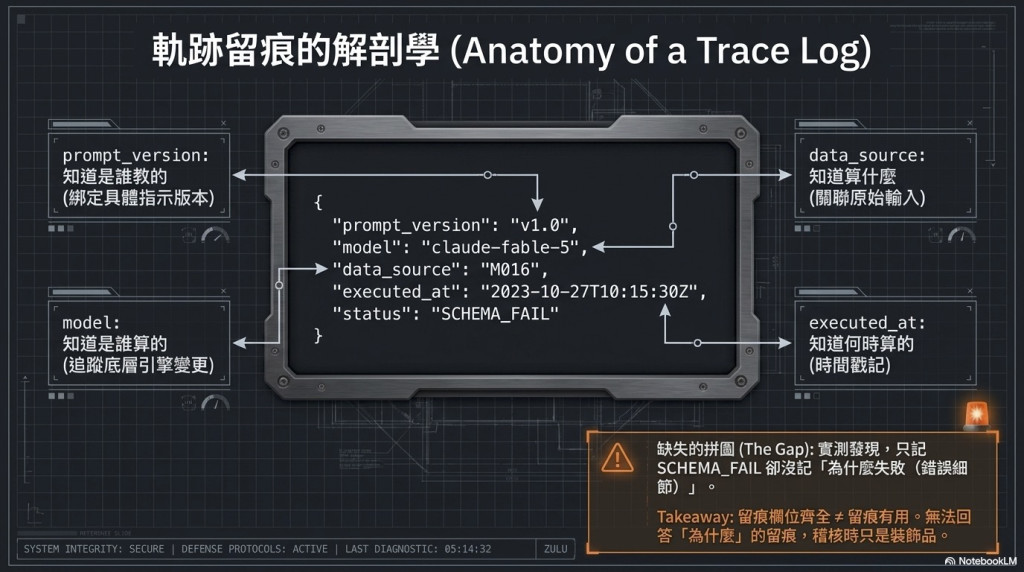
在實測 M016 客訴信時,系統觸發了例外路徑,記錄為 SCHEMA_FAIL 並轉人工。然而,當我們試圖診斷原因時,卻發現軌跡檔裡只記了「失敗」,卻沒記「為什麼失敗」。經過深入診斷,才發現是 Pydantic 驗證器攔截了超過 50 個字元 的摘要欄位。這是一個深刻的教訓: 「狀態」是給儀表板看的,「細節」才是給調測用的 。一個有用的留痕必須包含「驗證錯誤訊息(Validation Error Message)」。沒有細節的留痕,在面臨 AI 隨機性挑戰時,僅僅是佔空間的裝飾品,無法提供任何改進依據。
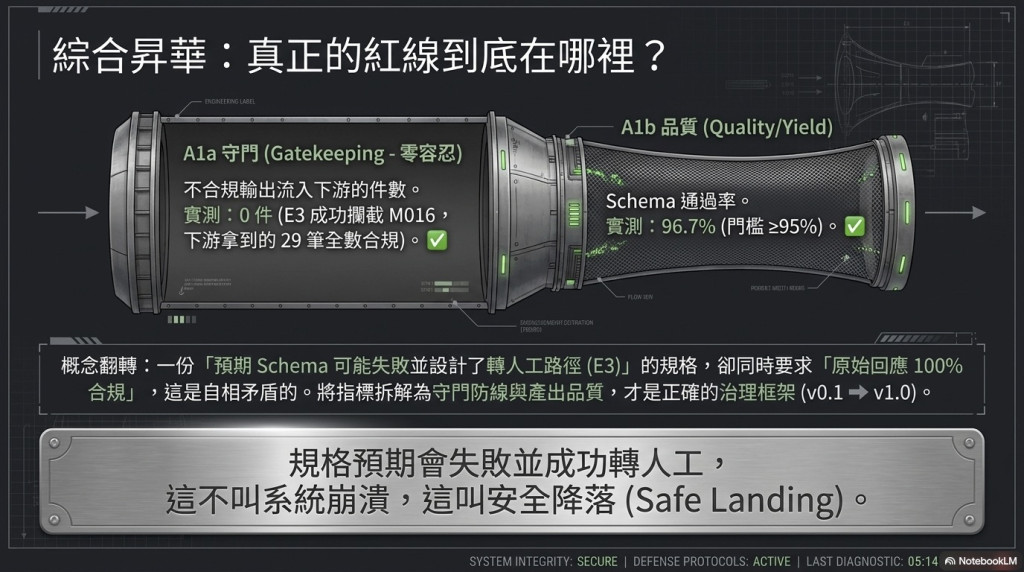
在 AI 系統中,要求模型原始回應 100% 合規是不現實的。面對 M016 這種資訊量巨大的案例,模型偶爾會突破約束。架構師的職責不是死磕 Prompt,而是設計韌性。我們將驗收標準(A1)拆分為「守門」與「品質」兩個層次,並引入「已知限制(Known Limitations)」的概念。例如 M005 樣本的誤判,正是我們在 Day 5 登錄台中預測過的「混合需求判斷不穩定」限制。與其為了單一案例過度擬合(Over-fitting)Prompt,不如將其記錄在案,並由例外路徑接管。
| 維度 | 修正前思維 | 修正後思維(韌性設計) | 成功指標(Metric) |
|---|---|---|---|
| 核心目標 | 模型回應必須 100% 符合格式 | 不合規回應不得流入下游系統 | A1a(守門):0 件 |
| 處理機制 | 反覆調優 Prompt 追求完美 | 啟動例外路徑(E3 重試與轉人工) | A1b(品質):≥95% |
| 失敗定義 | 模型出錯就是系統失敗 | 模型出錯但被正確攔截即為系統成功 | 韌性定義:攔截率 100% |
真正的紅線是「不合規數據流入下游」。只要守住 A1a,即使模型產出只有 96.7% 的達標率,整體系統依然是受控且安全的。
Day 6 的實測讓我們體認到,AI 開發不再只是寫程式,更是關於「實驗、留痕與修正」的循環。我們將評測報告與軌跡檔(JSONL)全部納入版本控制,實現了所謂的**「透過移植性達成治理」 (Governance through Portability)**。在你的 AI 應用走上生產線前,請務必反思: 當你的系統在出錯時,它能第一時間告訴你「為什麼」嗎?如果明天換了一台機器、換了一個人,你的系統還能跑出同樣的驗收報告嗎? 唯有能回答這些問題的系統,才是真正準備好面對現實挑戰的 AI 應用。


先做 NFKC 再掃描全形字元,這個案例很實用;但外觀相似的 Unicode 字元不一定都會被 NFKC 合併。你後續會加入 homoglyph、零寬字元與混合字集案例,驗證敏感資料掃描仍守得住嗎?

謝謝你,你說對了,而且比我以為的嚴重。
我直接拿程式測了 17 種變體,13 種穿過,包括:把英文 A 換成長得一模一樣的俄文 А、希臘文 Α;在號碼中間插入「看不見的字」(零寬字元),肉眼完全看不出差別;還有用不同的連字號寫電話。
原因用一句話講:NFKC 只能合併「同一個字的不同寫法」,例如全形A和半形 A;但俄文 А 和英文 A 在電腦眼中是兩個不同的字,長得像不算數,NFKC 不會處理。零寬字元也一樣,它會被原樣留下,而那就足以把號碼切成兩段、讓比對失效。
修法兩件事:
一是掃描前多加三道處理——先刪掉所有看不見的字元、再把常見的同形字換回英文、最後統一連字號寫法。
二是加一道不靠清單的判斷:同一串字裡混用兩種語言的字母(例如英文夾俄文),本身就可疑。因為同形字清單永遠列不完,只靠列舉一定會漏。
修完後 17 種全部擋下,測試也一起入庫,之後改壞了會被抓出來。
限制也說清楚:同形字對照表不是完備表,這道防線是提高門檻,不是保證攻不破。
這個系列每天都要寫一個失敗案例,今天這個是您送的,而且是我自己沒想到要測的那一類,再次感謝。

 iThome鐵人賽
 看影片追技術