
在開發 AI 應用時,開發者往往陷入一個常見的誤區:「餵給模型的資料越多,它的表現就會越聰明。」這種傾向導致了 AI 的「資訊肥胖症」。身為架構師,我們必須意識到,不加思索地將原始資料全數塞入模型,不僅會大幅增加資安攻擊面,更違背了資安核心的「最小特權原則」(Principle of Least Privilege, PoLP)。
我們是否在無意中讓 AI 「作弊」了?或者在追求效能的過程中,留下了連自己都沒察覺的治理漏洞?真正的 AI 治理不應寄望於開發者的自律,而應從架構層級落實「最小必要資料」原則:AI 不需要知道的,就絕對不能提供。
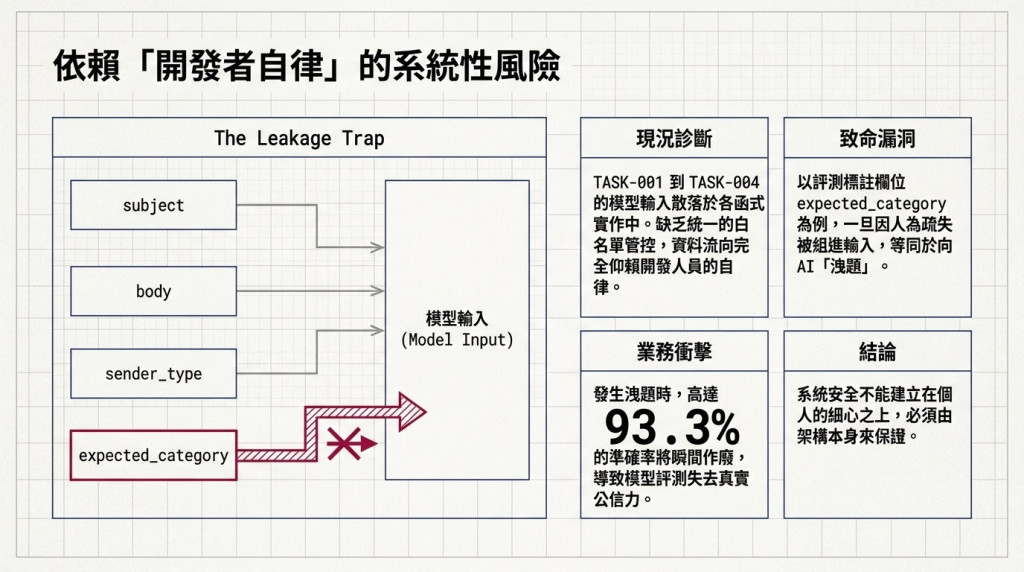
在資料流設計中,明確定義「禁止欄位 (Forbidden)」是治理的首要任務。若缺乏嚴格的過濾機制,開發者在實作時極易將評測用的標註資料(如 expected_category 或 expected_urgency)一併送入模型輸入端。
這種行為在架構評估中被視為典型的「洩題」。根據實作紀錄,一旦模型在輸入中獲取了預期答案,原本看似驚人的 93.3% 準確率將立刻失效。這並非模型具備真實的推理判斷力,而是因為系統治理失靈導致的「虛假繁榮」。將評測標註與模型輸入徹底進行物理隔離,是確保 AI 評測具備真實性與可信度的基礎防線。
即便制定了精密的規範,技術債往往隱藏在「治理政策 (Policy)」與「控制實作 (Control Implementation)」的時間差之中。在一次針對「帳號樣式」的測試中,系統出現了 1 個失敗、9 個通過的異常結果。
深入追蹤後發現,治理規範已在 Day 23 的分級表中明確要求攔截 12 位的「帳號樣式」,但底層的 E2 防線卻仍停留在 Day 6 的初始設定,僅能辨識身分證、手機與保單號。
> 「規則是 Day 23 寫的,防線是 Day 6 建的,中間隔了十七天,沒有人(包括我)回頭檢查防線有沒有跟上規則。」
這 17 天的斷層是典型的技術債,若非透過自動化測試看守,這類含有敏感帳號樣式的資料將直接穿透防線進入模型,造成嚴重的合規風險。
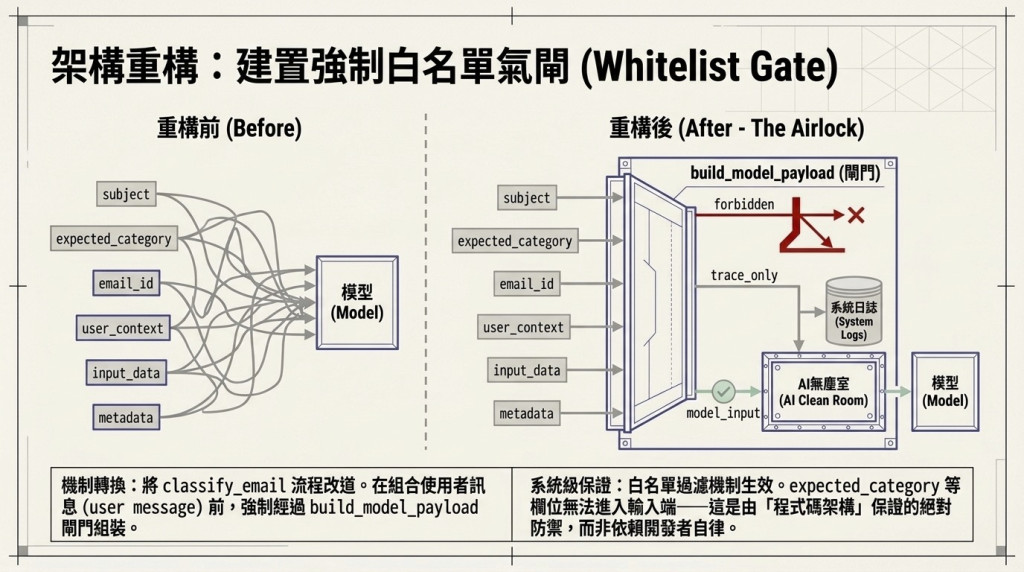
要解決資料過度暴露的問題,架構師必須建立強制性的「白名單閘門」——build_model_payload(實作於 minimal_data_service.py)。透過定義在 docs/governance/BAIOS_最小必要資料矩陣.md 中的規範,所有欄位必須被嚴格歸類:
email_id)。模型不需要這些識別碼,閘門會自動予以剔除。若任務未在矩陣中登錄,閘門將直接拒絕處理。這種機制將治理從人為判斷提升到了「程式保證」的硬性約束。
為了修正「帳號樣式」漏洞,我們必須採取「同源化」架構策略。將 E2 攔截防線的樣式與遮罩引擎 (MASK_RULES) 進行整合,確保兩者共用同一套正規表達式 (Regex)。
這種「同源化」在架構上的核心優勢在於杜絕 「規律漂移」(Pattern Drift)。當遮罩規則更新時,攔截防線會同步感知,避免規則與實作脫節。在導入同源化並補齊樣式後,我們針對 E001 邊界信(含身分證與電話樣式)進行壓力測試,最終成功達成「222 passed」的技術指標,確保所有高敏感類別都在 E2 防線的射程範圍內。
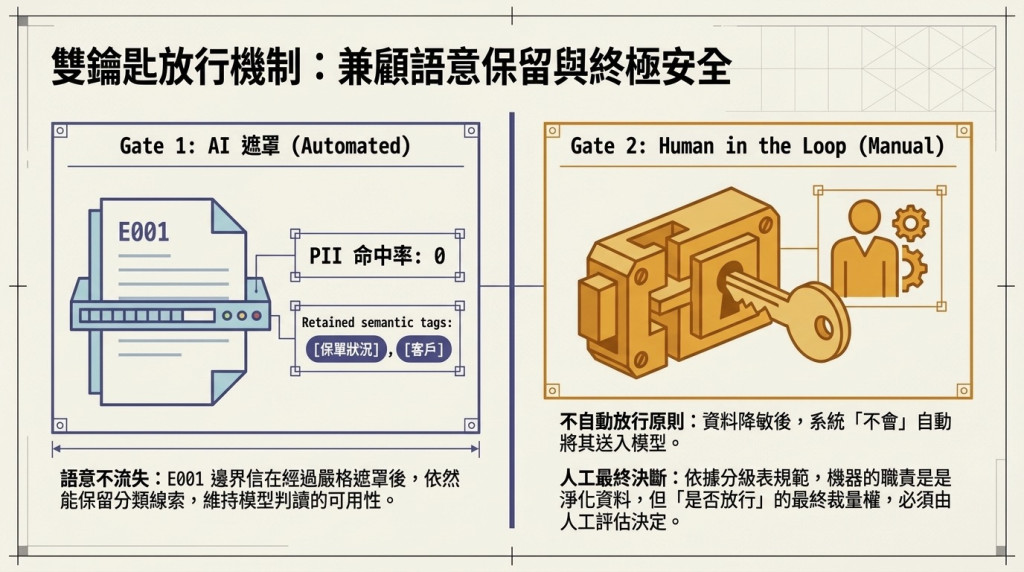
許多人擔憂「去識別化」會損害 AI 的業務可用性。然而實測顯示,即使是因含有敏感資訊而被攔下的 E001 邊界信,在經過遮罩處理後,雖然身分證與電話被隱藏,但郵件中的分類關鍵線索(如「保單狀況」、「客戶」)依然被完整保留,完全不影響模型的分類任務。
這證明了在多數治理場景下,AI 並不需要知曉特定的隱私資訊。但架構師必須堅持一項鋼鐵原則:去識別化不等於自動放行。資料降敏後是否能重新送回模型,必須保留人工評估的空間,這是自動化防線與人類決策之間的最後邊界。
透過「最小必要資料矩陣」與「同源化防線」,我們在代碼層級成功管住了欄位,也在傳輸層級管住了資料。然而,技術架構的完善僅是起點。當資料與模型都受到嚴密監控時,下一個核心挑戰將轉向「權限與角色」:誰有權限按下核准鍵?誰能接觸到降敏前的原始數據?
當資料管住了、模型管住了,我們真的能信任操作系統的那個人嗎?這是我們在明日討論「權限矩陣」治理前,每一位資安架構師都必須深思的終極課題。


 iThome鐵人賽
 看影片追技術