

昨天我們學習了高可用性(High Availability, HA)核心思維,並在本地建立好了 Minikube 測試叢集與 kubectl 命令列工具。
今天,我們將手把手帶你解密 K8s 兩大最核心的資源:Deployment(Pod 副本總管) 與 Service(流量進入點與負載均衡器),並親手寫出符合 Production 規範的 YAML 設定檔,一鍵部署到 Minikube,驗證 K8s 驚人的自動修復(Self-healing)!
在寫 YAML 之前,我們必須先搞懂這三個元件在 K8s 內部是如何交織協作的: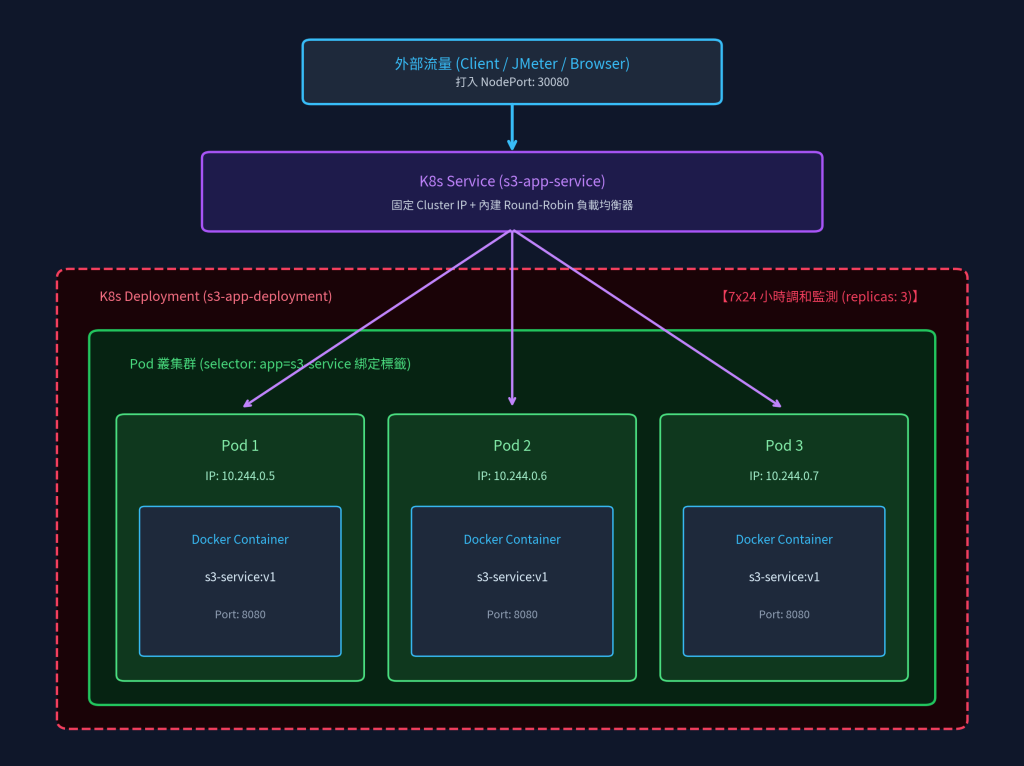
my-app:latest)的膠囊。10.244.0.5 變成 10.244.0.8)。Deployment。replicas: 3(3 副本高可用)。如果其中一個 Pod 崩潰,Deployment 會自動補上一個新的,維持 3 個 Pod 永遠在線上。Service 出場的時刻!selector 標籤(Labels)自動歸納後方的 3 個 Pod,自動將外部請求以 Round-Robin(輪詢)方式均衡分發給健康的 Pod。我自己剛開始學k8s的時候常常有疑問,這跟我之前寫的 Dockerfile 或 docker-compose.yml 有什麼關係?如果我的 Image 名稱叫 my-app 該怎麼改?後來也花了一些時間來釐清這些關聯:
Dockerfile 的關係:建材原料 vs 施工藍圖image: my-app:v1,讀取的正是你當初用 Dockerfile 打包出來的這個 Image!如果沒有 Dockerfile 產出 Image,K8s 根本沒有建材可以拉起 Pod。docker-compose.yml 的關係:單機編排 vs 雲端叢集docker-compose.yml 是單機(Single Node)環境下的容器編排工具,裡面宣告的 image, ports, environment 語法概念與 K8s 很像。docker-compose.yml 只能管理單台機器,沒有跨節點調度、沒有自我修復、也沒有 HPA 自動水平擴充。docker-compose.yml 搬到 K8s,就是把原本在 docker-compose.yml 裡宣告的屬性,拆解並升級到 K8s 的 Deployment(負責 Pod 副本與資源上限)與 Service(負責網路暴露與負載均衡)兩個 YAML 檔案中。s3-app-deployment.yaml)請在專案根目錄建立 k8s/ 資料夾,並新增 s3-app-deployment.yaml 檔案:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: s3-app-deployment
  labels:
    app: s3-service
spec:
  # 💡 1. 宣告副本數:開 3 個 Pod 實現單機多節點高可用 (HA)
  replicas: 3
  # 💡 2. 標籤選擇器:Deployment 透過貼紙 (Label) 管理 Pod
  selector:
    matchLabels:
      app: my-app  # your_image
  # 💡 3. Pod 範本 (Template):定義每個 Pod 裡面要裝什麼容器
  template:
    metadata:
      labels:
        app: my-app  # your_image
    spec:
      containers:
      - name: s3-service-container
        image: my-app:latest  # your_image
        # 💡 強制使用本地 Minikube 鏡像 (不從 Docker Hub 拉取)
        imagePullPolicy: IfNotPresent
        ports:
        - containerPort: 8080
          name: http
        # 💡 4. 環境變數注入 (AWS S3 憑證與設定)
        env:
        - name: AWS_ACCESS_KEY_ID
          value: "{ypur_ak}"
        - name: AWS_SECRET_ACCESS_KEY
          value: "{ypur_sk}"
        # 💡 5. 資源配額硬體限制 (Resource Limits)
        resources:
          requests:
            cpu: "250m"       # 保留 0.25 核 CPU
            memory: "256Mi"   # 保留 256MB 記憶體
          limits:
            cpu: "500m"       # 上限 0.5 核 CPU
            memory: "512Mi"   # 上限 512MB 記憶體
replicas: 3:實現3 節點負載分流!任何一個 Pod 壞掉,其餘 2 個 Pod 繼續接單,系統達到 preliminary 零中斷。matchLabels: app: s3-service:只要 Pod 貼有 app: s3-service 的標籤,就會被這個 Deployment 納入管轄。resources.limits:防止某個 Pod 發生記憶體洩漏(Memory Leak)吞噬整台宿主機,精確將 Pod 限制在 0.5 核 / 512MB 內。s3-app-service.yaml)接著建立 k8s/s3-app-service.yaml 檔案,為這 3 個 Pod 建立對外門牌:
apiVersion: v1
kind: Service
metadata:
  name: s3-app-service
spec:
  # 💡 1. Service 類型:NodePort 允許我們從本地端存取 Minikube 叢集
  type: NodePort

  # 💡 2. 標籤選擇器:將流量路由給帶有 app: my-app 貼紙的 Pods
  selector:
    app: my-app # your_image

  ports:
  - name: http
    port: 8080        # Service 內部的 ClusterPort
    targetPort: 8080  # 映射到 Pod 容器內部的 Port
    nodePort: 30080   # 暴露給宿主機本地端存取的對外 Port (30000-32767)
type: NodePort:K8s 將宿主機(Minikube)的 30080 Port 開放,並自動綁定到 Service,讓本地瀏覽器與 JMeter 能打入叢集內部。selector: app: my-app:Service 透過這個標籤,自動在背景維護一個名為 Endpoints 的動態 IP 列表(包含 3 個 Pod 的 IP),並自動執行負載均衡分流。現在我們打開 Terminal,執行這套標準的 K8s 部署流程:
因為 Minikube 是運行在獨立的虛擬機/容器內,我們要先把本地 build 好的 my-app:latest 鏡像傳進 Minikube:
minikube image load my-app:latest
使用 kubectl apply -f 指令,套用整個 k8s/ 資料夾下的所有 YAML 檔:
kubectl apply -f k8s/
deployment.apps/s3-app-deployment created 與 service/s3-app-service created!K8s 在短短 12 秒內自動建好了 3 個獨立且各具 Pod IP 的微服務容器,並且全部處於 Running 狀態!
kubectl get pods -o wide
輸入以下指令取得 Minikube 的服務對外存取 URL:
minikube service s3-app-service --url
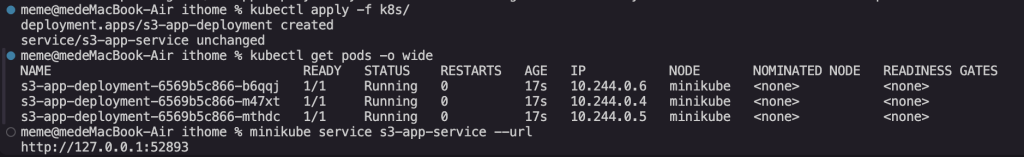
測試產生的url,列出api,發現回應成功!就代表服務部署成功啦!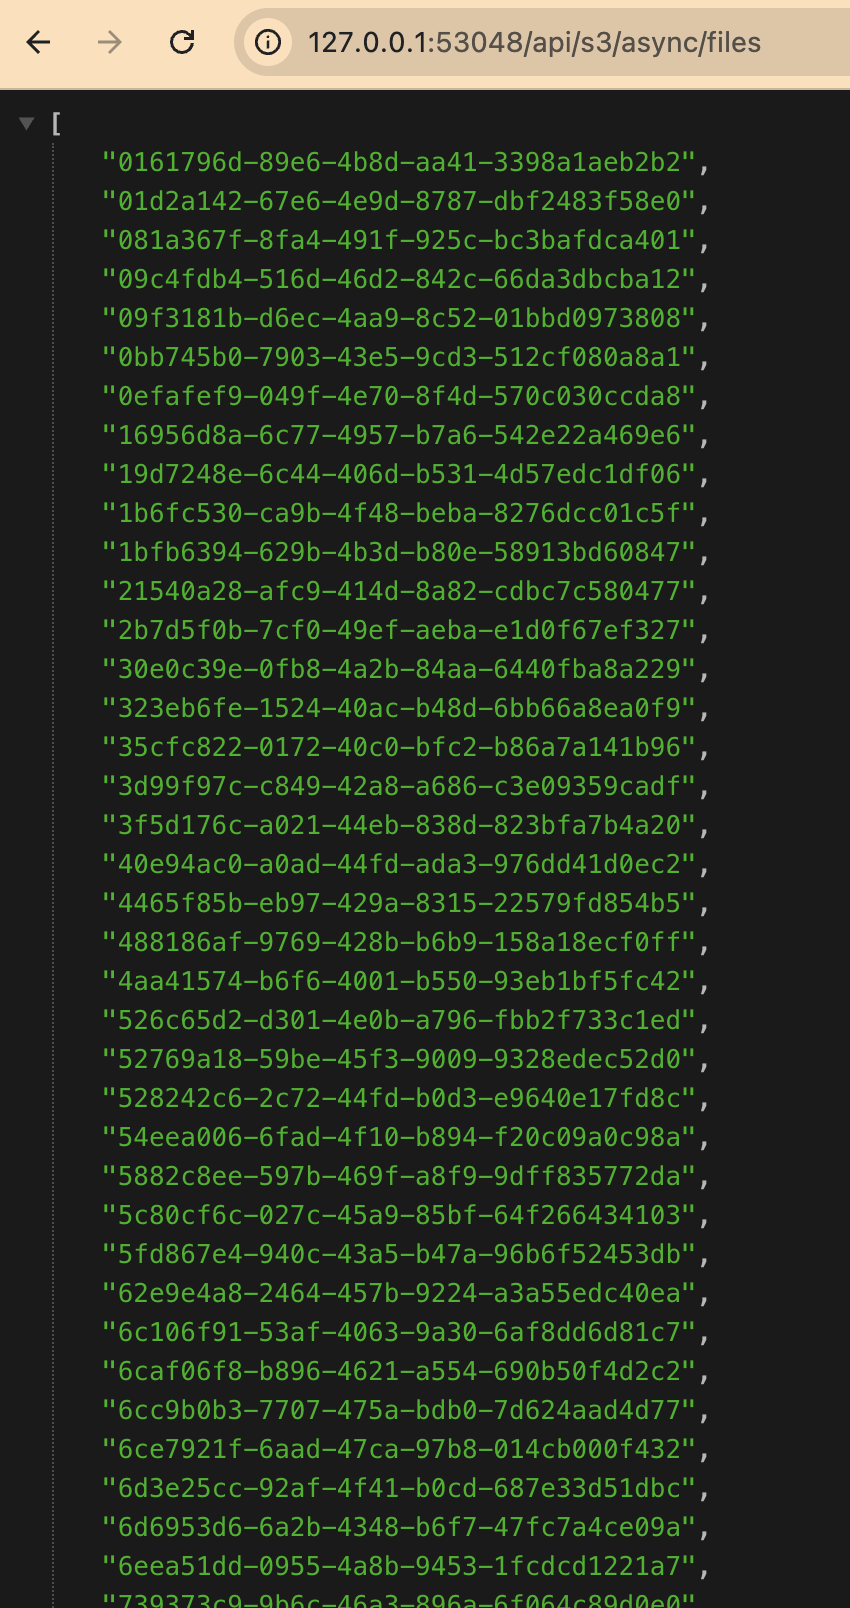
10.244.0.10) 功用在這個kubectl get pods -o wide階段會發現每個pod其實都有一個自己的pod id,那又為什麼還要執行 minikube service --url 產生 URL?
原因很簡單 10.244.0.x 是 K8s 叢集內部的私人分機 IP 我們的本地電腦在實體網路上根本直接連不到它。反觀 http://127.0.0.1:53048 是外部跨界專線 (SSH Tunnel),因為 Docker Desktop 跑在獨立的虛擬網路區段,Minikube 在本地 127.0.0.1:53048 開了一條管道,直通 K8s 內部 Service,並自動做負載平衡將請求均衡分發給 .10、.11、.12 這 3 個 Pod!
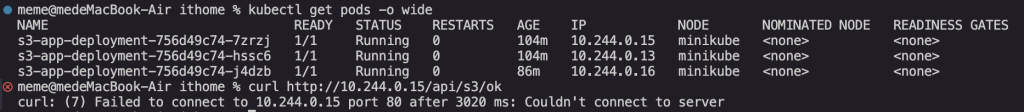
直接在本地端用curl打pod ip是一定連不到的喔
為了管理成百上千台伺服器與容器,Kubernetes 引入了雲端原生最偉大的設計思想 : 宣告式 API (Declarative API)。
docker run -d -p 8080:8080 my-app ➔ 萬一容器掛了,服務不會理你,除非你再敲一次命令。replicas: 3 我期望 (Desired State) 隨時保持 3 個健康的 my-app 容器在運作 ➔ K8s Control Plane 的 Controller Loop 會 7x24 小時不斷對照 「當前狀態 (Current State) vs 期望狀態 (Desired State)」 若發現少了一個 Pod,立刻自動長出一個補充!現在,我們來驗證宣告式 API所講的親手殺掉一個 Pod 時,K8s 會發生什麼事?
kubectl get pods -w
kubectl delete pod s3-app-deployment-756d49c74-6kdhc
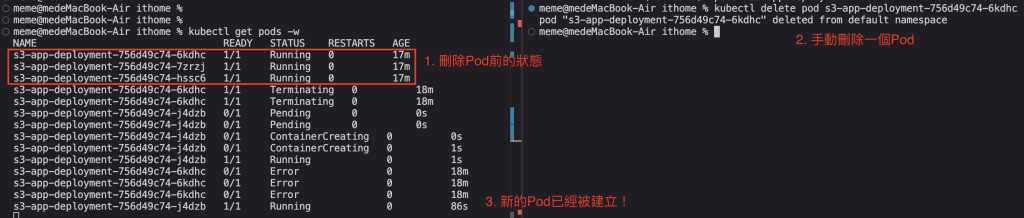
6kdhc 收到刪除指令進入 Terminating 狀態時,K8s 大腦(kube-controller-manager)的調和迴圈(Reconciliation Loop)在第 0 秒立刻監測到「當前狀態 (2 個 Pod) != YAML 宣告的期望狀態 (3 個 Pod)」。j4dzb(經歷 Pending -> ContainerCreating)。j4dzb 在 1 秒內成功啟動並進入 Running 狀態!舊 Pod 6kdhc 平靜退場清空,整個自癒過程在 1 秒內由 K8s 宣告式 API 全自動完成,外部請求完全由其餘健康 Pod 無感接管!今天我們正式告別了單機手動時代,完成了一次極其壯烈的微服務架構升級:
這正是 Kubernetes 能夠統治雲端世界的核心魅力所在!而明天將進一步說明如果在修復的過程中一直有流量寫入,又該怎麼面對,以及之前在 Day 17 用 Docker Compose 架好的 Prometheus 與 Grafana 監控,該如何跨網路無縫對接 K8s 叢集?請大家拭目以待了!


 iThome鐵人賽
 看影片追技術