

昨天我們剖析了 K8s 3-Node 叢集在 Service 與 kube-proxy 轉發下的網路開銷。今天,我們要來測試 k8s HPA (Horizontal Pod Autoscaler) 自動水平擴展!讓 K8s 根據即時 CPU 負載,自動像變形金剛一樣擴展長出更多 Pod 來應對突如其來的流量。今天除了手把手設定 Metrics Server 與 HPA (Horizontal Pod Autoscaler),更會和前幾天的內容做壓力測試的比較,進行跨架構實測對比!
我們前兩天有提到的水平擴展(Scale-out)與垂直擴展(Scale-up)是擴展的方式和概念,而詳細實作時我們必須透過k8s中的自動化控制器機制 HPA來實現Scale-out
minikube addons enable metrics-server
kubectl get pods -n kube-system,確認 metrics-server 處於 Running 狀態。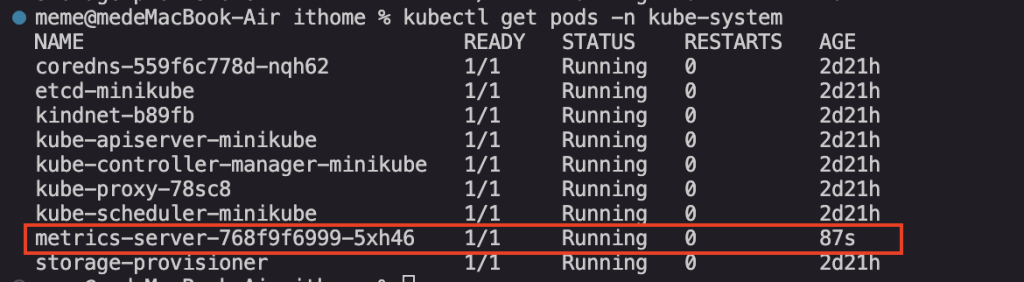
kube-system 是 Kubernetes 存放控制面(Control Plane,大腦與器官)的核心命名空間。這些 Pod 就是 K8s 能夠自動運作的背後功臣:
kubectl 指令)。k8s/s3-app-hpa.yaml
s3-app-hpa.yaml,並加入以下程式碼apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
name: s3-app-hpa
spec:
scaleTargetRef:
apiVersion: apps/v1
kind: Deployment
name: s3-app-deployment
minReplicas: 3 # 平時保持 3 個 Pod 低功耗
maxReplicas: 6 # 高流量時最多自動擴容到 6 個 Pod
metrics:
- type: Resource
resource:
name: cpu
target:
type: Utilization
averageUtilization: 50 # CPU 50% 即觸發自動加開 Pod!
kubectl apply -f k8s/s3-app-hpa.yaml
kubectl get hpa
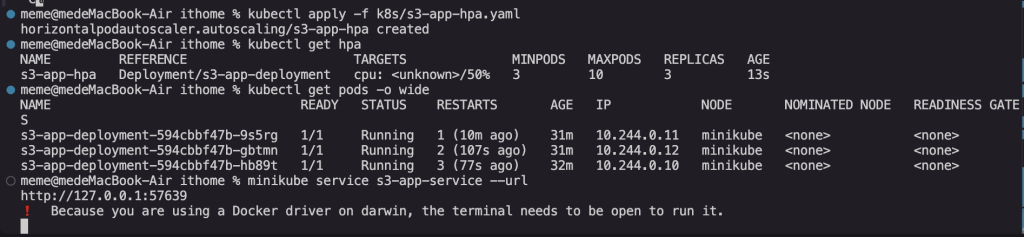
我們啟用 Metrics Server 並配置 HPA(目標 CPU: 50%,Pod 數 3 ~ 6個),並使用Jmeter進行多階段併發測試:
| 架構 | 併發總數 (Threads x Loop) | 平均延遲 (ms) | 最小延遲 (ms) | 最大延遲 (ms) | 錯誤率 (%) | 吞吐量 (RPS) | 網路發送 (KB/s) |
|---|---|---|---|---|---|---|---|
| Docker | put 80 x 5 (400) | 1,342 | 1 | 5,192 | 36.75% 🚨 | 26.3/s | 1,821.0 KB/s |
| K8s | put 80 x 5 (400) | 4,457 | 874 | 13,117 | 0.00% | 14.5/s | 1,004.0 KB/s |
| HPA | put 20 x 5 (100) | 1,102 | 435 | 2,753 | 0.00% 🎉 | 10.4/s | 721.7 KB/s |
| HPA | put 50 x 5 (250) | 2,400 | 473 | 6,970 | 0.00% 🎉 | 15.2/s | 1,048.0 KB/s |
| HPA | put 80 x 5 (400) | 3,906 | 777 | 13,696 | 0.00% 🚀 | 16.2/s | 1,121.6 KB/s |
| HPA | list 100 x 5 (500) | 5,837 | 120 | 30,104 | 46% 🚀 | 2.59/s | 5.6 KB/s |
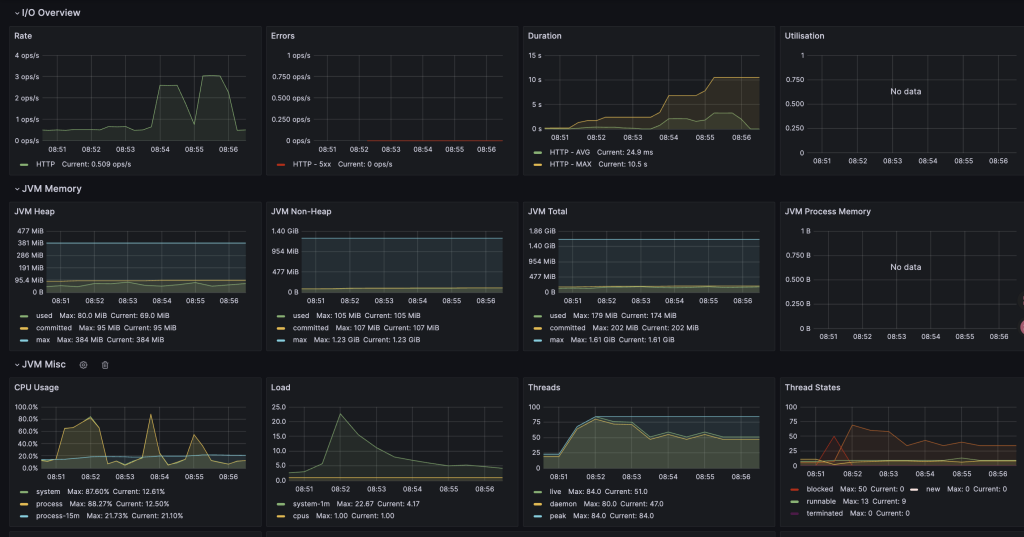
🎯 HPA 逆襲關鍵:當 80 併發打進來時,HPA 偵測到 CPU 使用率衝破 88%,在 20 秒內自動將 Pod 從 3 個動態擴充至 6 ~ 8 個 Pods!多個容器平分 Semaphore(50) 控流與 JIT 編譯開銷,成功將單機時代的 36.75% 崩潰錯誤率徹底歸零 (0.00%)!
HPA 在 PUT 20, 50, 80 併發下的 Grafana 監控畫面,展現 Pod 隨流量自動長大,三個CPU高峰代表三次的壓力測試,可以看到負載平滑分流,錯誤率維持完美的 0.00%!
Terminal 控制台視窗,記錄了 HPA 在高負載下動態拉起 Pod 4、Pod 5 至 Pod 8 的即時擴容軌跡。
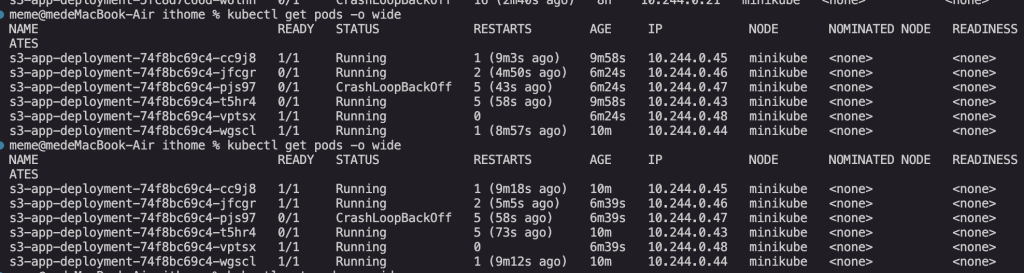
jfcgr 的pod由0/1 轉 1/1 ,說明當流量打進來時,HPA 動態拉起新 Pods(如 4tt2f, 9942, stlk2)。剛拉起時顯示 STATUS: Running 但 READY: 0/1,經過約 10 秒通過 Readiness Probe 後轉為 1/1,正式加入 Service 接收流量!CrashLoopBackOff的狀態,代表死鎖了,詳見後續除錯方式的章節在測試中,我們發現 List 200 併發在 HPA 下依然全數卡死崩潰。這揭示了 HPA 的核心運作機制與盲點:併發型態與擴容時效
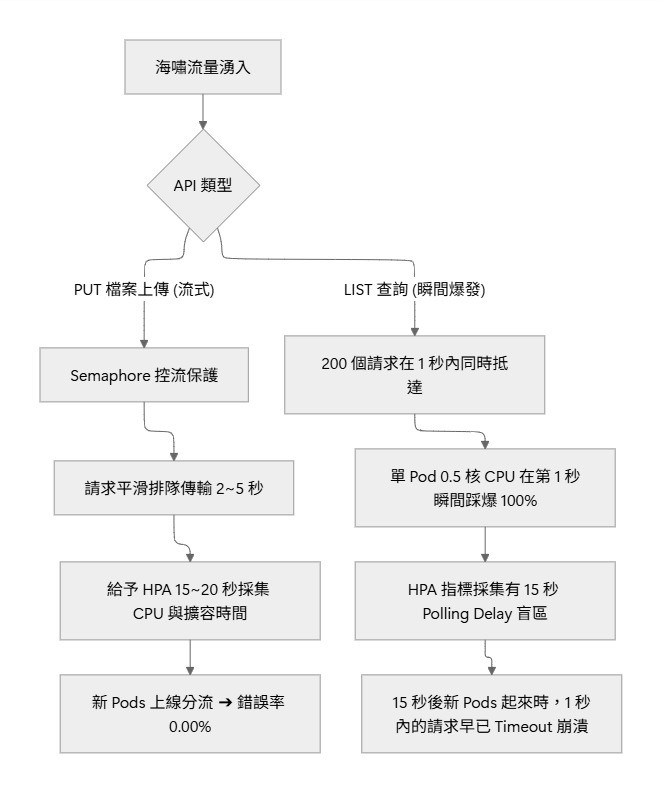
3.結論:寫入靠背壓 (Backpressure) 與 HPA 自動擴容;讀取靠 Redis 快取 (Cache) 吸收 99% 瞬間海嘯!
我自己在實際壓力測的時候其實遇到非常多問題,首先HPA測試到一半服務整個壞掉了,api都打不到一直出現socket error
在 HPA 測試中,若 YAML 配置不當,常常會看到以下令人崩潰的畫面:
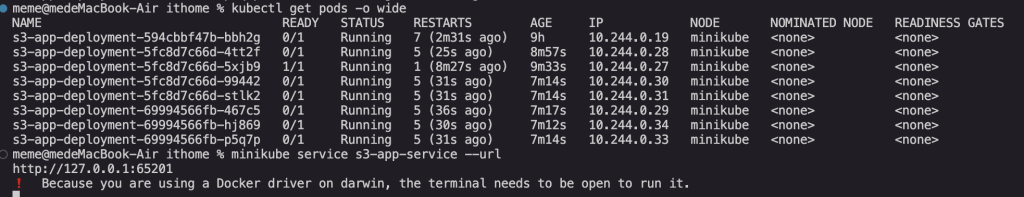
594cb, 5fc8d):頻繁修改 limits 並套用,導致舊版 ReplicaSet 的 Pod 還沒死透,新版又拉不起來。RESTARTS: 5~7),陷入死鎖!在 K8s 叢集中面對未知的錯誤時,千萬不能瞎猜!我們時可以按照以下步驟慢慢找到問題點:
先看看是不是硬體效能滿了 kubectl top pods 實時查看哪一個 Pod 算力飆滿或記憶體洩漏
229 m + 237 m + 184 m + 224 m + 74 m + 42 m + 229 m + 246 m = 1,465m (1.465核心) 這證明所有的 Pod 加起來精準吃滿了我們給予的 1.5 核上限,且其餘 CPU 被 K8s 控制面(etcd, apiserver, coredns)順暢使用。檢查 Pod 底部 Events 區塊 kubectl describe pod <Pod名> 抓出 Reason: OOMKilled 或探針 Fail 原因。
查看容器重啟前的崩潰前的日誌 kubectl logs <Pod名> --previous
如果是像前面pod的圖片中遇到 CrashLoopBackOff 死鎖!可以重新建立乾淨的叢集
NAME                                 READY   STATUS            RESTARTS       AGE
s3-app-deployment-594cbbf47b-bbh2g   0/1     CrashLoopBackOff  7 (2m31s ago)  9h
s3-app-deployment-5fc8d7c66d-4tt2f   0/1     Running           5 (25s ago)    8m
s3-app-deployment-5fc8d7c66d-5xjb9   1/1     Running           1 (8m27s ago)  9m
- 刪除舊的 : `kubectl delete deployment s3-app-deployment`
- 重新建立 : `kubectl apply -f k8s/s3-app-deployment.yaml`
一個好的服務硬體資源要設定多少,絕不能憑感覺設定 Pod 數量!而需要量化估算框架:
Peak QPS = [(每日活躍使用者 (DAU) x 每人每日 API 呼叫次數) / 每日尖峰時間 (秒)]x 安全壓測係數 (3 ~ 5)
範例(電商 / S3 微服務):
Memory per Pod = (Semaphore x 單一請求 Buffer 大小) + JVM/Netty 基礎開銷
limits: 512Mi。requests: 100m ~ 250m(設小:保底預約,讓 HPA 敏感偵測)。limits: 500m ~ 1000m(設大:允許 JVM 啟動與 JIT 爆發,留出 2x~4x 突發空間)。假設我們的 API 服務需要應付日常 200 QPS,尖峰時間(晚上 8~10 點)會爆發至 2,000 QPS:
或許有人好奇不是應該用RPS(Requests per second)來計算嗎?
這兩天我們完整走過了從單機 Docker、K8s 3-Node 到 HPA 自動擴展的全套實測歷程!我們用數據證明了 HPA 在高併發寫入時的震撼威力,也釐清了讀取 API 必須依賴快取的物理邊界,也實證了:
明天,我們將正式邁入 DevOps 自動化交付,實作 GitHub Actions + AWS ECR + K8s 一鍵 CI/CD 流水線!


 iThome鐵人賽
 看影片追技術