

昨天我們成功撰寫了 Deployment 與 Service YAML 檔,將非同步 S3 微服務部署至 Minikube 叢集,並親眼驗證了當 Pod 被殺掉時,宣告式 API 如何在 1 秒內自動長出全新的 Pod 完成修復。
然而,在雲端高可用(High Availability, HA)營運的現實世界中,還隱藏著兩個極其致命的隱形炸彈:
今天,我們要手把手實作Liveness 和 Readiness 雙探針機制!對比無探針崩潰慘案與有探針 0% 錯誤率無感發佈的巨大差異,並示範 Prometheus 監控對接的架構抉擇!
在 K8s 中STATUS: Running 僅代表容器進程(Process)還活著,並不代表應用程式具備處理流量的能力!
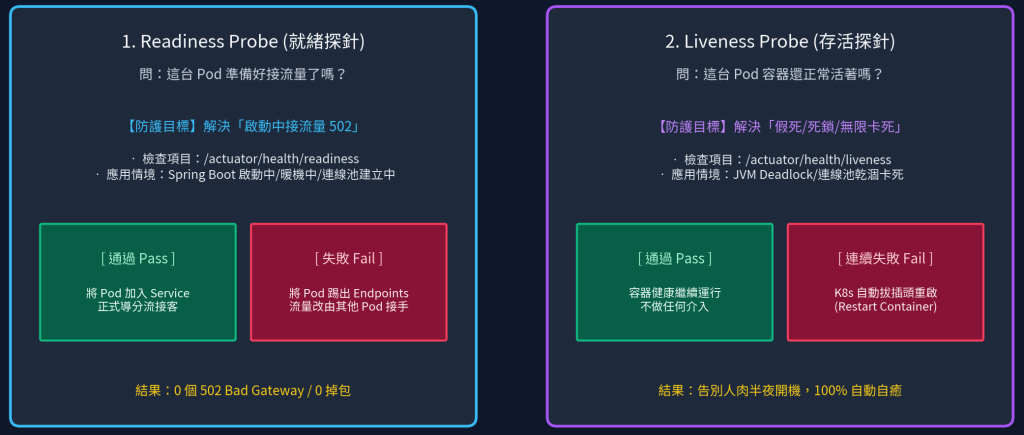
為了精準監控微服務健康狀態,K8s 提供了兩種探針:Readiness Probe, Liveness Probe
502 Bad Gateway!failureThreshold),K8s 會強制殺掉容器並重新啟動,實現無人值守自動修復!稍微補充一下大家比較容易混淆的概念
s3-app 副本均勻分散在不同 Node 上。當 Node 1 實體斷電時,Node 2 和 Node 3 上的 Pod 繼續對外服務。打開兩個terminal視窗
kubectl get pods -w,列出所有的pod及時資訊kubectl rollout restart deployment s3-app-deployment 等待一下打開我們之前壓力測試的jmeter
s3/api/async/files/protected
minikube service s3-app-service --url產生的port按下jmeter發送請求的瞬間,請同步切回terminal視窗按下restart deployment
開始觀察jmeter的發送狀況以及terminal左側的即時pods資訊
NoHttpResponseException錯誤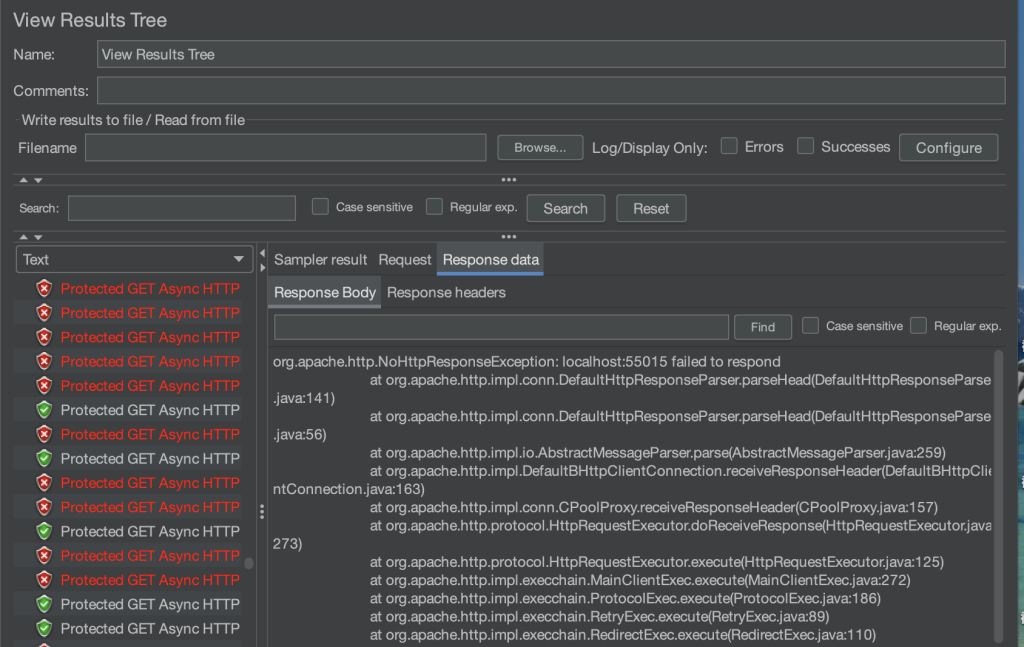
接著再右側視窗輸入kubectl get pods -o wide列出pods詳細資訊,就會發現重新佈署的pods和原本的是不同的,ip不一樣了
就算想要透過log找到之前jmeter請求時的錯誤紀錄也找不到因為是在容器更新跌代的時候發生的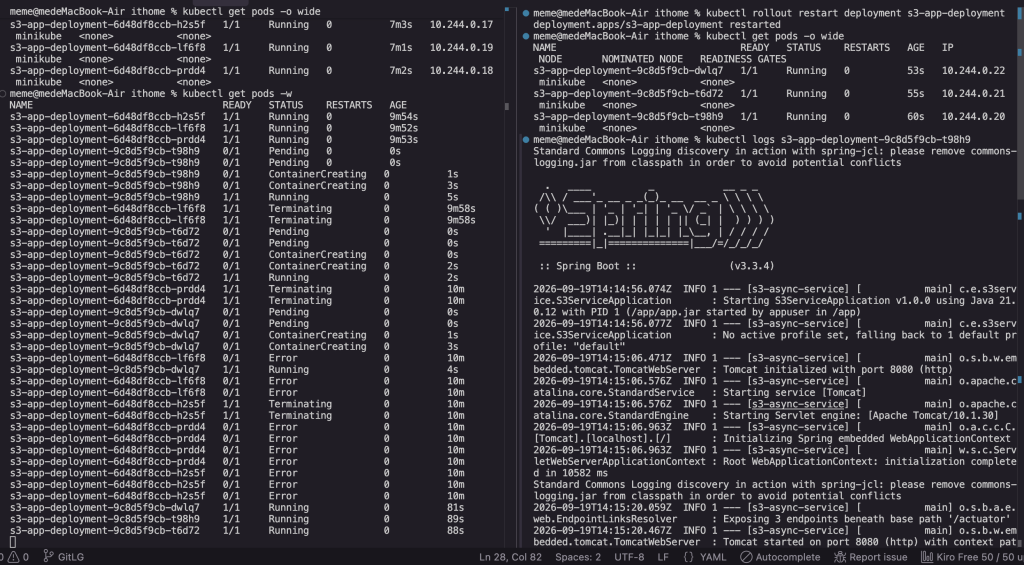
詳細補充說明一下restart deployment的過程:
t98h9 進入了 STATUS: Running
Running,就天真地以為應用已經 ready,立刻把 Service 門牌的外部流量轉發給這個新 PodNoHttpResponseException(Socket 斷裂)application.yml設定檔中加入probes設定,
docker build -t my-app .
minikube image load my-app:latest
management:
  endpoints:
    web:
      exposure:
        include: "health,info,prometheus" # 開放 prometheus 端點
  endpoint:
    health:
      probes:
        enabled: true # 開啟 /actuator/health/liveness 與 /actuator/health/readiness
s3-app-deployment.yaml:
kubectl apply -f k8s/s3-app-deployment.yaml 更新k8s spec:
containers:
- name: s3-service-container
image: my-app:latest
# 💡 1. Readiness Probe (就緒探針)
readinessProbe:
httpGet:
path: /actuator/health/readiness
port: 8080
initialDelaySeconds: 10 # 容器啟動 10 秒後開始首次檢查
periodSeconds: 5 # 每 5 秒檢查一次
# 💡 2. Liveness Probe (存活探針)
livenessProbe:
httpGet:
path: /actuator/health/liveness
port: 8080
initialDelaySeconds: 20 # 容器啟動 20 秒後開始首次檢查
periodSeconds: 10 # 每 10 秒檢查一次
failureThreshold: 3 # 連續失敗 3 次則判定死亡並重啟
重複前面實驗的做法,打開兩個terminal視窗和jmeter,重新實驗
觀察的過程中會發現Jmeter 沒有出現任何錯誤! 0% error ,請求全數通過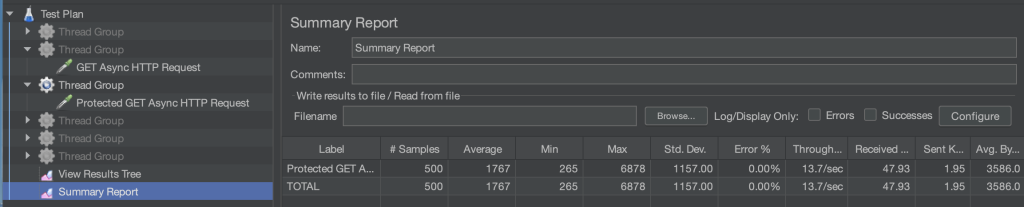
觀察左側pods及時資訊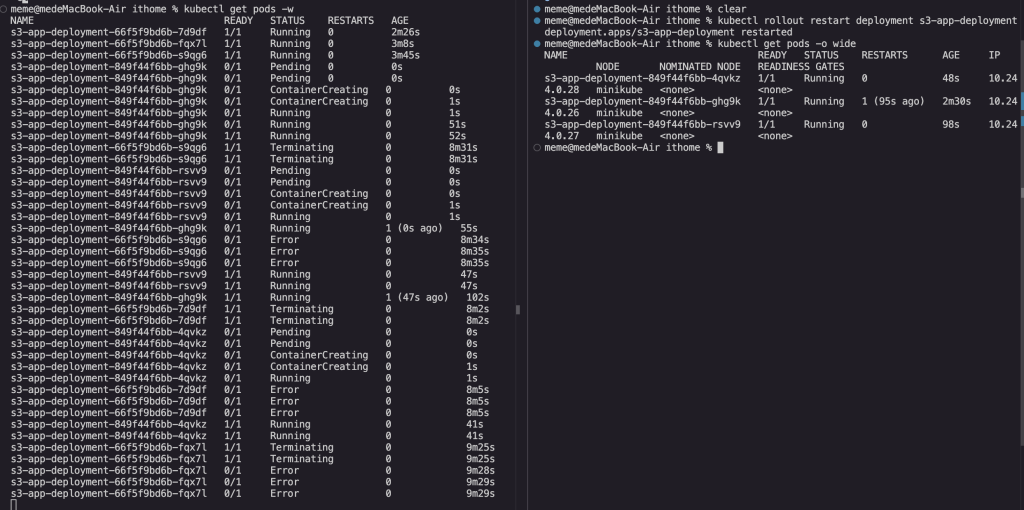
上面那張即時資訊的截圖可能還是太過複雜,簡單來說可以簡化成這樣
NAME                               READY  STATUS   AGE
s3-app-deployment-66f5f9bd6b-7d9df   1/1  Running     2m26s
s3-app-deployment-66f5f9bd6b-fqx7l   1/1  Running     3m8s
s3-app-deployment-66f5f9bd6b-s9qg6   1/1  Running     3m45s
s3-app-deployment-849f44f6bb-ghg9k   0/1  Pending      0s
s3-app-deployment-849f44f6bb-ghg9k   0/1  Running      1s -> 進入 Running,但 READY 是 0/1!
s3-app-deployment-849f44f6bb-ghg9k   0/1  Running      51s  ->  靜置等待 51 秒探針通過
s3-app-deployment-66f5f9bd6b-s9qg6   1/1  Terminating  8m31s ->  新 Pod 通過後舊 Pod 才退場!
ghg9k 雖然在第 1 秒就進入 Running,但 READY 保持為 0/1。K8s 就緒探針持續打 /actuator/health/readiness,在其回傳 200 OK 之前,Service 嚴格禁止將任何流量轉發給它s9qg6 保持 1/1 Running 在線上無縫處理 100% 的外部請求ghg9k 在第 51 秒正式拿到 READY 1/1 後,K8s 才將其納入轉發清單,並緊接著發射 SIGTERM 關閉舊 Pod我們之前在使用docker compose建立服務的時候有提到docker中內部網路有自己的連接方式,會透過docker network來設定,在把微服務搬上 K8s 後,之前Day17提到的 Prometheus 與 Grafana 監控有兩種不同的架構做法:
| 維度 | A:Docker Compose 監控跨網路對接(本地推薦) | B:K8s 全量 Pod 原生化部署(生產環境) |
|---|---|---|
| 部署方式 | Prometheus 繼續跑在原本 Docker Compose,指向 host.docker.internal:30080。 |
將 Prometheus & Grafana 也撰寫成 K8s Deployment/Service 部署。 |
| 記憶體消耗 | 極低,不佔用 Minikube 寶貴的 2GB 算力土地。 | 較高,需要在 K8s 內額外劃分算力給監控 Pods。 |
| 高可用性 (HA) | 監控為單機 Docker Compose,無自癒能力。 | 監控系統本身也享有 K8s 的自動自癒與高可用保護。 |
| 歷史儀表板 | 零重建成本,Day 17 建好的 Grafana Dashboard 直接繼續用! | 需要透過 Helm Chart 或 ConfigMap 重新匯入 Dashboard。 |
minikube stop 再 minikube start,Minikube IP(如 192.168.49.2)通常是固定的。但如果 minikube delete 重新建立,IP 確實有可能改變!host.docker.internal:30080 作為 Target!會自動解析為宿主機轉接 IP,無論 Minikube IP 怎麼變都不需要手動修改 YAML!這部分為了教學方便我們先採用方法 A!不過除了調整 prometheus.yml之外我們還必須讓 Prometheus 容器直接跨進 Minikube 的網路
minikube ipdocker ps,找到Prometheus那個欄位對應的id,並且加到下一步的網路中docker network connect minikube <prometheus-container-id>
scrape_configs:
  - job_name: 's3-microservice-job'
    metrics_path: '/actuator/prometheus' # 指定 Actuator 端點
    static_configs:
      - targets: ['192.168.49.2:30080'] # 調整這行即可
重啟 Prometheus docker compose restart prometheus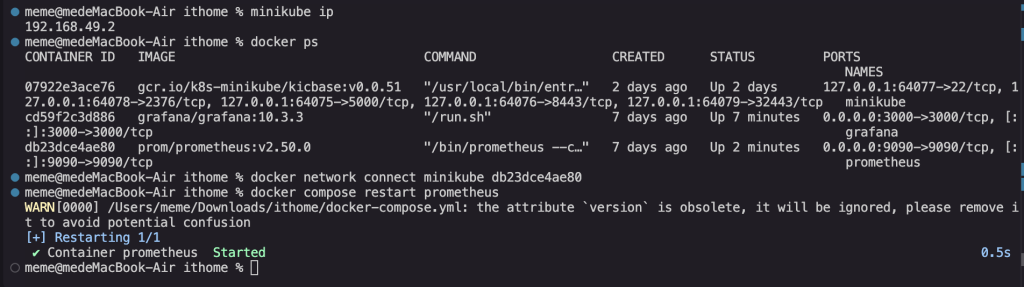
再次進入localhost:9090裡面的Target頁面來觀察是否有連線成功,看到是up就代表沒問題啦
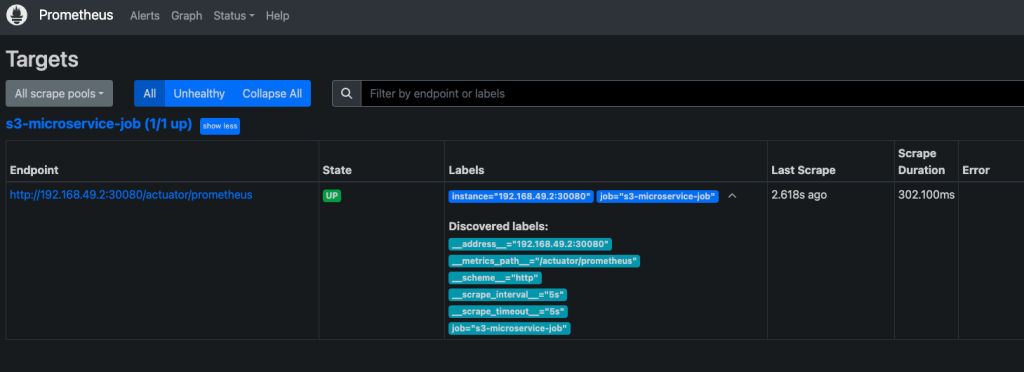
今天我們完成了 K8s 高可用防線的兩大重要實作:
NoHttpResponseException,造成線上服務中斷。READY 0/1 靜置保護,達成 0% 錯誤率無感發佈!也成功將Prometheus的監控成功指向新部屬在k8s上的服務了,明天我們將展開整套課程最重要的壓測實驗!我們將用相同的流量,對單機 Docker、K8s 固定 3-Node以及 K8s HPA 動態擴容三種模式進行 putObject(非同步上傳)與 listObjects(快取/Semaphore 保護)的全方位測試!


 iThome鐵人賽
 看影片追技術