

前兩天我們成功將非同步 S3 微服務部署至 Minikube K8s 叢集,並設定了Liveness/Readiness 雙探針實現了 0% 錯誤率的無感發佈,以及 Prometheus 容器直接跨進 Minikube 的網路的連線!
我們要來和前幾天的內容做壓力測試的比較,進行單機 Docker (1.5核) vs. K8s 固定 3-Node 的效能流量對決!從 QPS 吞吐量、P99 延遲分佈、資源利用率來比較,先說結論單機Docker比較好?! 為什麼呢? 不是因為 K8s 壞掉,而是隱藏著 K8s 內部 Service 網路轉發開銷、port-forward 隧道瓶頸與 Cgroups CPU 限流的底層真相!
今天就來帶大家一探究竟!
首先為了硬體資源不要衝突,我們先手動關掉k8s服務 minikube stop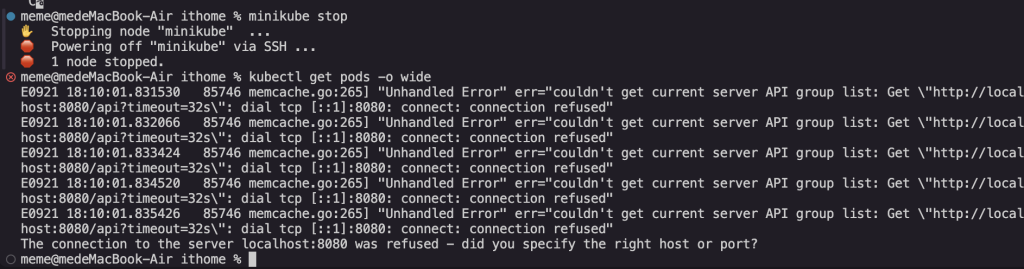
修改prometheus.yml最後一行 - targets: ['s3-app:8080'] (docker的本地url)
執行docker compose restart 這樣就完成環境建置了
打開Jmeter就可以來實測protected的listObject和putObject兩個功能的api
docker compose stop s3-app
minikube start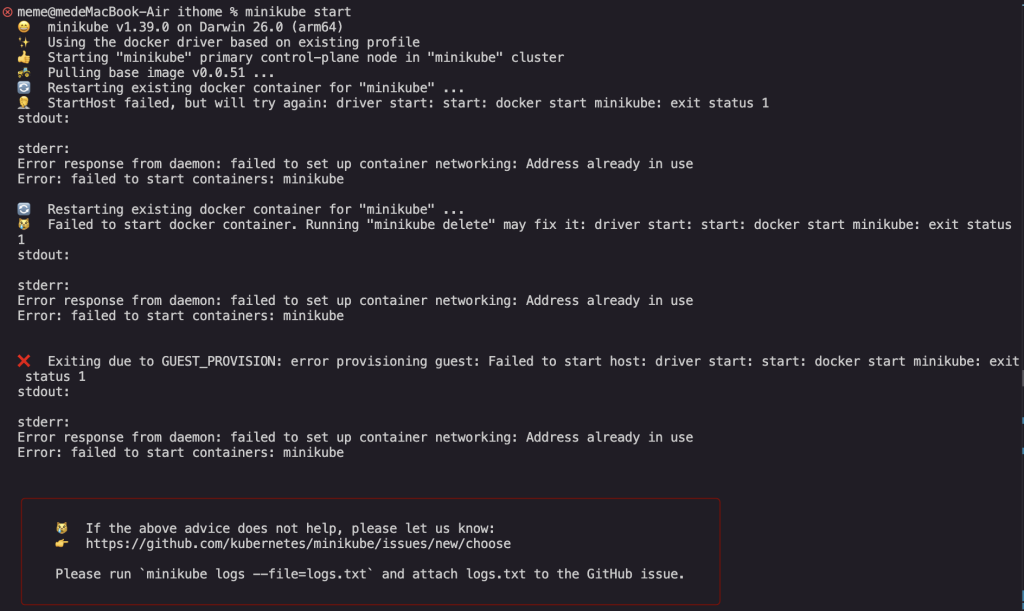
Address already in use,是因為 macOS 版 Docker Desktop底層的網路橋接器(vpnkit),在特定情況下釋放 Socket 連線的速度比較慢。 這時候手動重啟docker就好了)正常要看到這樣喔
😄  minikube v1.39.0 on Darwin 26.0 (arm64)
✨  Using the docker driver based on existing profile
👍  Starting "minikube" primary control-plane node in "minikube" cluster
🚜  Pulling base image v0.0.51 ...
🔄  Restarting existing docker container for "minikube" ...
📦  Preparing Kubernetes v1.37.0 on containerd 2.3.4 ...
🔎  Verifying Kubernetes components...
    ▪ Using image gcr.io/k8s-minikube/storage-provisioner:v5
    ▪ Using image registry.k8s.io/metrics-server/metrics-server:v0.9.0
🌟  Enabled addons: default-storageclass, metrics-server, storage-provisioner

❗  /usr/local/bin/kubectl is version 1.34.1, which may have incompatibilities with Kubernetes 1.37.0.
    ▪ Want kubectl v1.37.0? Try 'minikube kubectl -- get pods -A'
🏄  Done! kubectl is now configured to use "minikube" cluster and "default" namespace by default
修改prometheus.yml最後一行 - targets: ['192.168.49.2:30080'](minikube ip),並且重啟服務docker compose restart prometheus
檢查一下網頁target頁面是否連線成功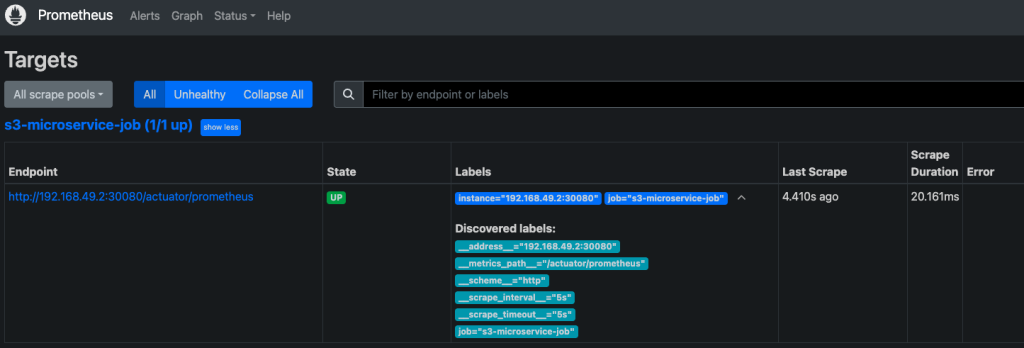
記得到grafana上再次建立data source和dashboard,步驟和Day相同,確認instances是minikube ip還是s3-app(這代表你還在監測單機docker的服務)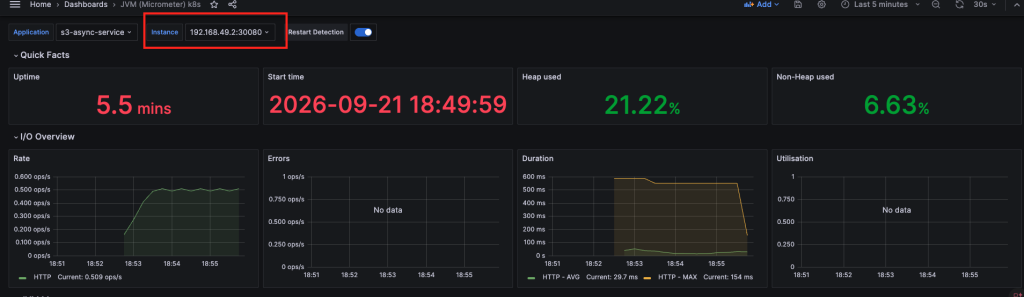
再次建立url minikube service s3-app-service --url 並將產生的port貼到jmeter上即可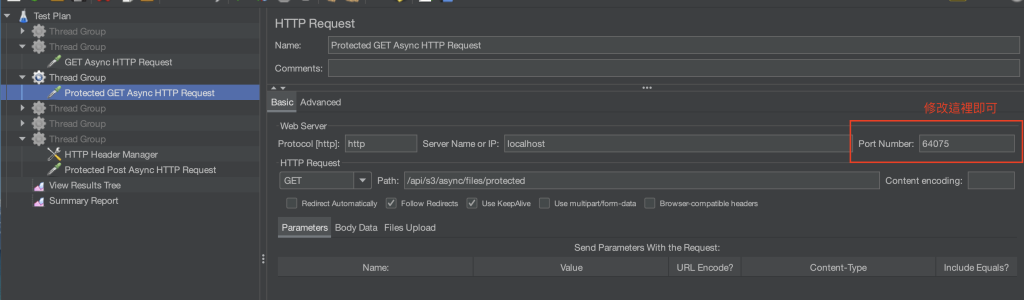
我們使用 JMeter 對 ListObjects與 PutObject 進行多階段併發測試,結果如下:
| 架構 | 併發(Threads x Loop) | 平均延遲 (ms) | 最小延遲 (ms) | 最大延遲 (ms) | 標準差 | 錯誤率 (%) | 吞吐量 (QPS) | 網路接收 (KB/s) |
|---|---|---|---|---|---|---|---|---|
| Docker | 200x5 (1,000) | 2,093 | 423 | 4,106 | 735.4 | 0 | 71.3/s | 249.7 KB/s |
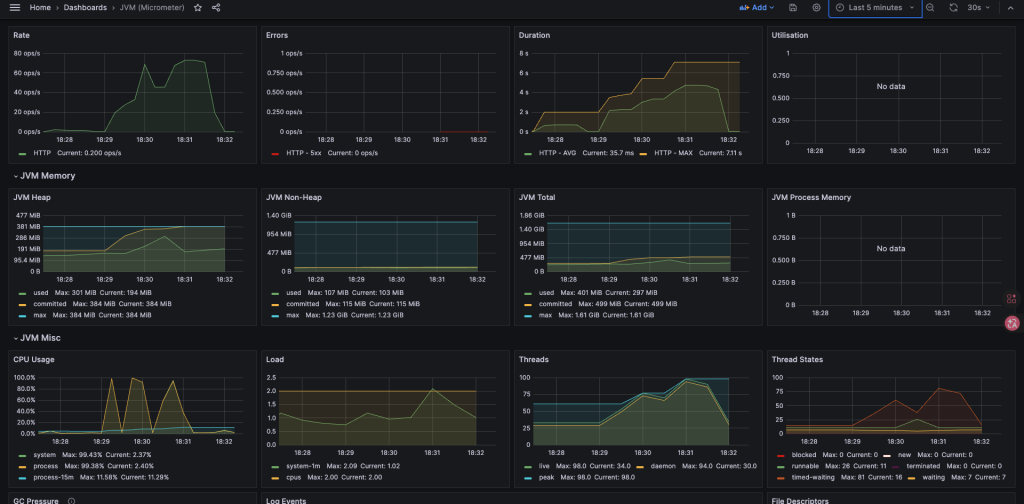
| Docker | 500x5 (2,500) | 2,632 | 1,064 | 4,953 | 725.4 | 0 | 128.5/s | 511.3 KB/s |
| Docker | 800x5 (4,000) | 4,793 | 2,489 | 7,290 | 969.4 | 0.04% | 134.9/s | 536.8 KB/s |
| K8s | 200x5 (1,000) | 3,284 | 345 | 9,705 | 1,792.6 | 0 | 45.9/s | 174.1 KB/s |
| K8s | 500x5 (2,500) | 5,328 | 3 | 24,544 | 6,167.5 | 91.28% 💣 | 65.1/s | 58.1 KB/s |
單機 Docker 進行 List 200, 500, 800併發壓測時,Grafana 呈現三個極其陡峭的 CPU 爆發高峰,最高衝破 90%+,JVM 瞬間將 1.5 核算力發揮至極致。
K8s 3-Node 進行 List 200, 500 併發壓測時,CPU 被 Cgroups 嚴格鎖定在 500m 天花板,500 併發衝擊時引發劇烈的 CPU Throttling 與 TCP 佇列塞車,所以error也有一個高峰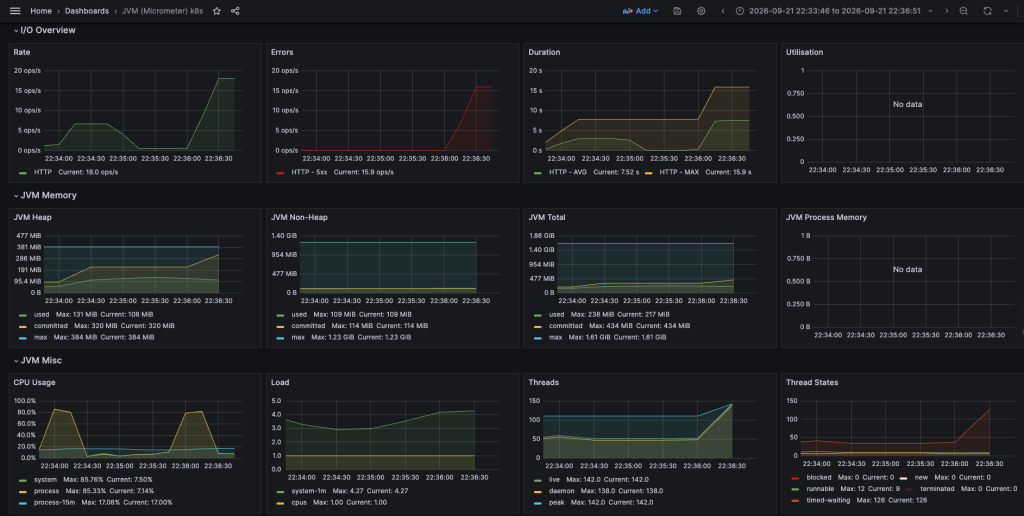
| 架構 | 併發(Threads x Loop) | 平均延遲 (ms) | 最小延遲 (ms) | 最大延遲 (ms) | 標準差 | 錯誤率(%) | 吞吐量 (QPS) | 網路發送 (KB/s) |
|---|---|---|---|---|---|---|---|---|
| Docker | 20x5 (100) | 922 | 573 | 2,008 | 411.8 | 0 | 10.6/s | 735.4 KB/s |
| Docker | 50x5 (250) | 1,886 | 574 | 5,796 | 901.0 | 0 | 17.2/s | 1,185.9 KB/s |
| Docker | 80x5 (400) | 1,342 | 1 | 5,192 | 1,193.5 | 36.75% 🚨 | 26.3/s | 1,821.0 KB/s |
| K8s | 20x5 (100) | 1,501 | 562 | 6,037 | 1,064.4 | 0 | 7.8/s | 537.5 KB/s |
| K8s | 50x5 (250) | 2,495 | 605 | 8,151 | 1,513.3 | 0 | 13.8/s | 947.6 KB/s |
| K8s | 80x5 (400) | 4,457 | 874 | 13,117 | 2,002.3 | 0 🛡️ | 14.5/s | 1,004.0 KB/s |
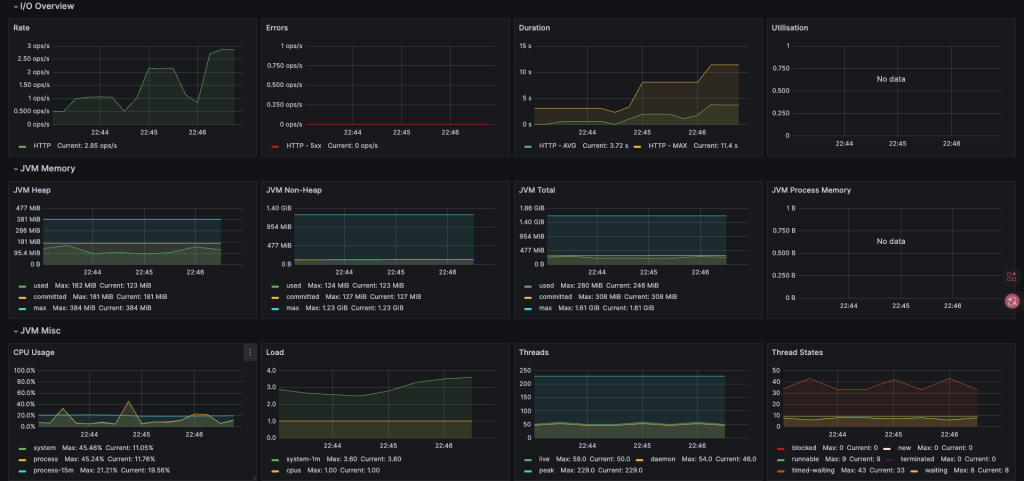
K8s 3-Node 進行 put 20, 50, 80併發壓測時,受惠於 Semaphore(50) 門閥控流,CPU 平緩維持在 40% 左右,成功守住高併發衝擊。
明明都是 1.5 核 CPU,為什麼單機 Docker 的 QPS 總是高出 30%~50%?
答案就在於分散式開銷 (Distributed Overhead)與K8s 網路封包轉發路徑
單機 Docker 的連線路徑極短: JMeter ➔ Localhost ➔ Docker Bridge ➔ Container Netty (1 step)
而在 K8s 叢集中,封包必須穿越繁瑣的網路虛擬化層:
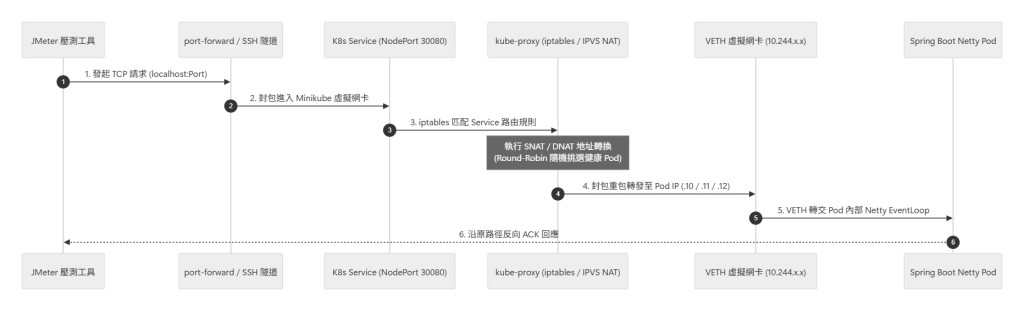
單機 Docker 雖然在純讀取 API 繳出了極致的QPS,但它就像沒有保險絲的高壓電,一旦爆掉就是 100% 死亡;K8s 3-Node 雖然付出了微小的負載均衡網路開銷,卻換來了 0 停機的自我修復與高可用鋼鐵防線!
明天,我們將加入重頭戲 HPA (自動水平擴展) 實測!解密 HPA 如何讓 PUT 寫入突破單機瓶頸,以及為什麼在高併發下我們需要量化容量預估!


 iThome鐵人賽
 看影片追技術