

Day 5 做完 PDF 上傳之後,我原本以為 Visual Learning Lab 終於可以正式拿來讀教材了。
但拿真正的工程講義測下去,很快就發現一個問題。
pypdf 的確可以把 PDF 裡的文字抽出來,也可以保留頁碼,但教材裡很多真正重要的東西根本不是純文字。
像公式、波形圖、向量圖、座標軸,甚至一整張示意圖,都有可能在文字抽取的過程裡直接消失。
昨天測 Sinusoids 講義時就發生了很明顯的例子。
PDF 第 4 頁明明放了一整頁三角恆等式,但 AI 卻告訴我:
有提到 Trigonometric identities,但沒有看到具體公式。
它其實不是看錯。
它是根本沒看到。
所以 Day 6 我想解的問題很明確:
不要只讓 AI 讀「PDF 抽出來的文字」,而是讓它真的看到原本的 PDF。
前一天的流程大概是:
PDF
↓
pypdf
↓
文字
↓
GPT
今天我沒有把 pypdf 拿掉。
因為它其實還是很有用:可以抽文字、保留 [Page 1]、[Page 2] 這些頁碼,也可以幫我做 Source Check。
我改成讓兩條資訊一起送進 GPT:
PDF
├─ pypdf → 文字 + 頁碼
│
└─ 原始 PDF → GPT 直接看頁面
也就是說,同一份教材現在會同時提供:
文字負責讓內容比較容易整理,也保留來源位置;原始 PDF 則讓模型有機會看到公式、圖形、波形和其他視覺內容。
我也沒有加 OCR。
這次想先測的是:如果直接把 PDF 本身交給模型,它到底能不能補回昨天消失的東西。
我刻意沒有換教材。
直接拿 Day 5 那份同樣的 5 頁 Sinusoids PDF 再跑一次。
因為這樣最好比較。
這次 Quick Summary 和 Key Concepts 一樣正常,但多出了一個新的區塊:
Visual Evidence!
結果跟昨天差非常多。
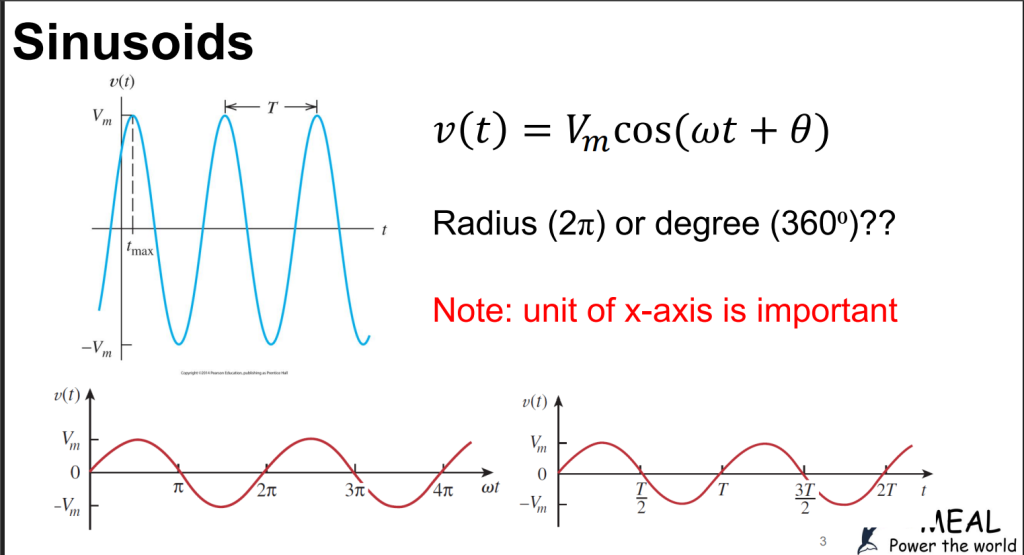
昨天 AI 只知道這份教材「有提到三角恆等式」。
今天它直接告訴我第 4 頁有:
到了第 5 頁,它甚至直接讀到:
A cos ωt + B sin ωt = C cos(ωt − θ)

C = √(A² + B²)

θ = tan⁻¹(B/A)
而且還知道旁邊有一張 A、B、C 和相位角的向量圖。
這就是我今天真正想測的東西。
昨天它知道「這頁在講三角恆等式」,今天它是真的看到那些公式了。
既然模型現在真的能看到 PDF 裡面的視覺內容,我也順便把這些資訊正式加入 Structured Output。
現在每個 Visual Evidence 會包含:
page
type
description
learning_value
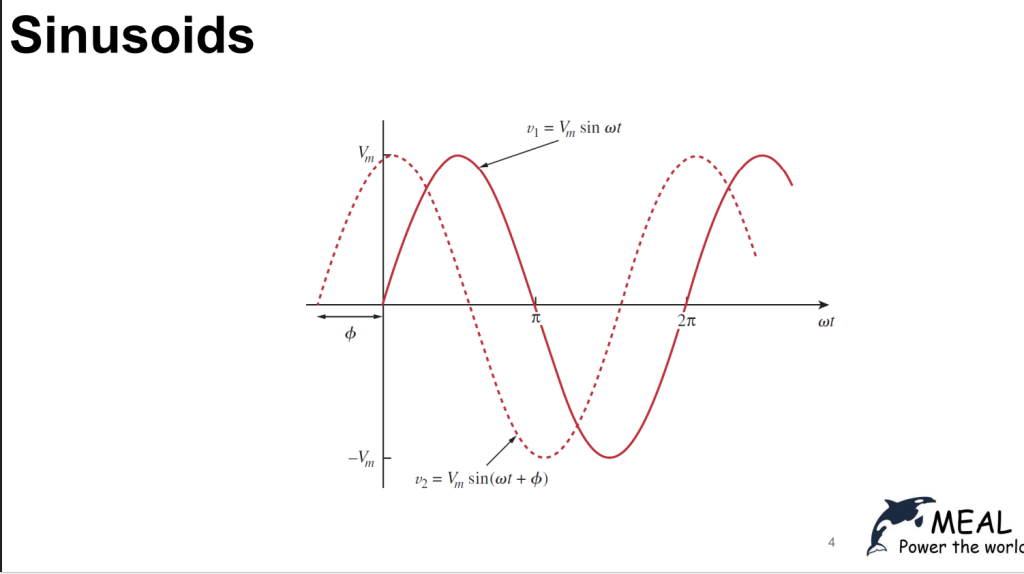
例如這次它看到 Page 3 的兩條 sinusoidal waveforms,就不是只回:
這裡有一張圖。
而是會整理成:
Graph — Page 3

兩條波形展示
v₁ = Vₘ sin ωt
與
v₂ = Vₘ sin(ωt + φ)

並標示相位差 φ。
接著再補一句這張圖對學習有什麼價值:
可以直觀看到相位差如何造成正弦波的水平位移。
這點我滿喜歡。
因為我不只是想知道「PDF 裡有圖片」,而是希望 Visual Learning Lab 能開始理解:
這張圖為什麼值得看?
我原本有點擔心,加了 PDF Vision 之後,原本 Day 5 做的來源頁碼會不會亂掉。
目前測起來還好。
例如:
正弦—餘弦的相位轉換
Source: p.4

正弦波的合成表示
Source: p.5
Visual Evidence 自己也會帶 Page 4、Page 5。
所以目前的 Source Check 開始有兩種來源:
文字內容
→ Source: p.x

視覺內容
→ Formula / Graph / Diagram — Page x
當然現在還只是「頁」的程度。
我還不能直接點一個公式跳回 PDF 裡的確切位置,但至少相比 Day 4、Day 5,現在 AI 說一件事情時,我已經比較知道它是從哪裡看到的。
Vision 成功之後,我又遇到另一個問題。
原本 Visual Flow 是直接拿 Relationships 去畫。
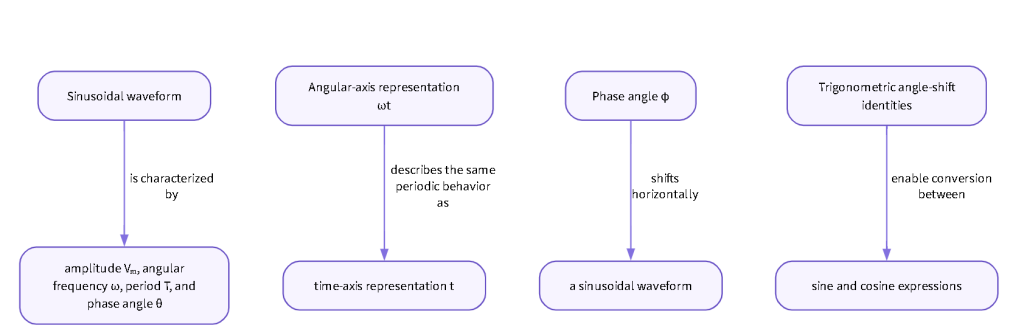
這在前幾天還勉強可以,但內容一變複雜,就開始很明顯地碎掉。
第一次重新跑 Sinusoids 時,Visual Flow 長成很多彼此分離的小島:
Phase angle
↓
sinusoidal signal

A and B
↓
C

A and B
↓
θ
每一組 Relationship 單獨看都沒有錯。
但全部排在一起,很難說那是一張「Flow」。
Laplace Transform 更明顯。
理論上這份教材其實有一個很自然的流程:
ODE
↓
Laplace Transform
↓
代數方程
↓
解代數方程
↓
Inverse Transform
↓
原本 ODE 的解
但如果直接從 Relationships 裡挑線來畫,AI 很容易把它拆成兩三段。
所以我原本先試了一個很簡單的方法:讓每條 Relationship 多一個 flow_eligible,叫 GPT 判斷這條關係到底適不適合放進 Flow。
有改善。
但還是不夠。
做到這裡我才發現,問題其實出在架構。
Relationships 的工作應該是:
告訴我教材裡有哪些概念關係。
Visual Flow 的工作則是:
找出這份教材真正值得畫成流程的主線。
這兩件事本來就不完全一樣。
所以最後我乾脆把它們拆開。
現在 Structured Output 裡除了 Relationships,另外會產生一份專門給 Visual Flow 使用的資料:
visual_flow

├─ suitable
├─ reason
├─ nodes
└─ edges
每個 node 都有自己的固定 ID,edge 只能連到這些 ID。
這也順便解掉前幾天一直出現的另一個問題:
Sinusoidal analysis
跟
Sinusoid analysis
人看起來知道是同一個東西,但程式會把它當成兩個不同節點。
現在由 AI 先產生 canonical nodes,再用固定 ID 連線,就不容易一直產生名稱很像的重複節點。
改完之後,我又把同樣兩份教材跑一次。
Sinusoids 最後整理出來的 Flow 變成:
正弦波表示
↓
辨識週期、相位與橫軸單位
↓
處理相位差
↓
使用三角恆等式與 ±90° / 180° 轉換
↓
合併 A cos ωt 與 B sin ωt
↓
得到 C cos(ωt − θ)
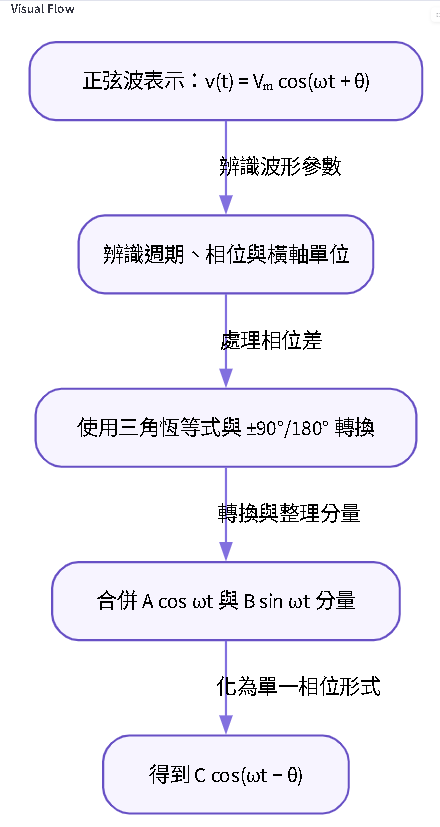
這個嚴格來說比較像一條「學習路徑」,不是自然發生的物理流程,但至少它已經不再是五六個互不相干的小島。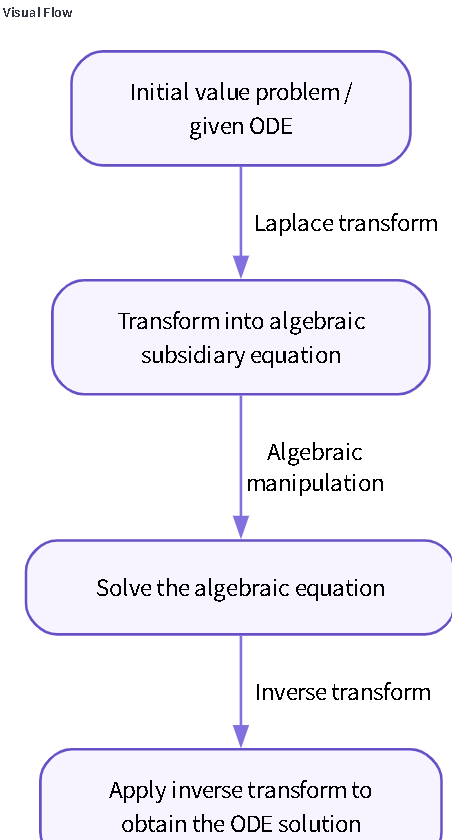
而 Laplace Transform 的差別就更明顯。
它現在真的抓出了主要解題流程:
Initial value problem / given ODE
↓
Transform into algebraic subsidiary equation
↓
Solve the algebraic equation
↓
Apply inverse transform
↓
ODE solution
其他像 f(t)、F(s)、Laplace transform 的定義,還是會留在 Key Concepts 和 Relationships 裡。
但不再硬塞進主流程。
我覺得這才比較接近我一開始想做的事情。
不是把 AI 產生的所有東西全部畫出來,而是:
先理解,再決定什麼值得畫。
做到今天,我覺得 Day 5 和 Day 6 的差異滿有趣的。
Day 5 的系統是:
PDF
↓
抽文字
↓
理解文字
Day 6 開始變成:
PDF
├─ 文字
├─ 公式
├─ 波形
├─ 圖表
└─ 圖像資訊
        ↓
      GPT
        ↓
結構化理解
而且今天不只補上 Vision,也讓 Visual Flow 從「拿 Relationships 硬畫」變成有自己獨立的資料結構。
目前 Visual Learning Lab 已經開始可以做到:
PDF 文字理解        ✓
來源頁碼            ✓
公式辨識            ✓
圖形 / 波形辨識     ✓
Visual Evidence     ✓
Relationships       ✓
獨立 Visual Flow    ✓
但還有一件事情一直在提醒我。
Sinusoids 這份教材其實並不是最適合 Flow 的內容。
GPT 自己推薦的 Suggested Visualization 裡,也一直出現:
Concept Map
Comparison
Image / Diagram
所以目前真正的問題已經慢慢從:
「AI 看不看得懂教材?」
變成:
「AI 看懂之後,應該用什麼方式呈現?」
現在 Visual Learning Lab 終於開始真的「看」教材了。
下一步,就不能什麼東西都只會畫 Flow 了。
GitHub Repo:
https://github.com/f24131128-lgtm/visual-learning-lab


 iThome鐵人賽
 看影片追技術