
在開發功能時,即便是再資深的設計師,也會遇到無法斷言不同設計中哪個表現最好的問題。當我們認為某項改動能改善使用者的結果時,除了靠猜以外,讓真實使用者與統計說話是更理想的作法。
前面說到,我們可以用功能旗標 Feature Flag 來對一部分使用者先發布、測試,當確定有效後再發布給所有使用者。
透過比較功能的啟用與否,我們也可以利用先前介紹的 Product Analytics,觀察兩個分組之間的差異。
如果我們利用 Feature Flag 隨機分組,再自行分析兩組數據,其實就已經很接近一場實驗了。不過,我們還有更方便的工具:實驗 Experiment。
Experiment 針對這類測試預先整合了常用功能,包含前面提到的 Multivariate、要觀察的指標,以及最後的統計分析。除了讓我們看到「兩組數據有沒有差異」,也可以進一步判斷這個差異有多可信。
首先,我們先建立一個 Experiment。
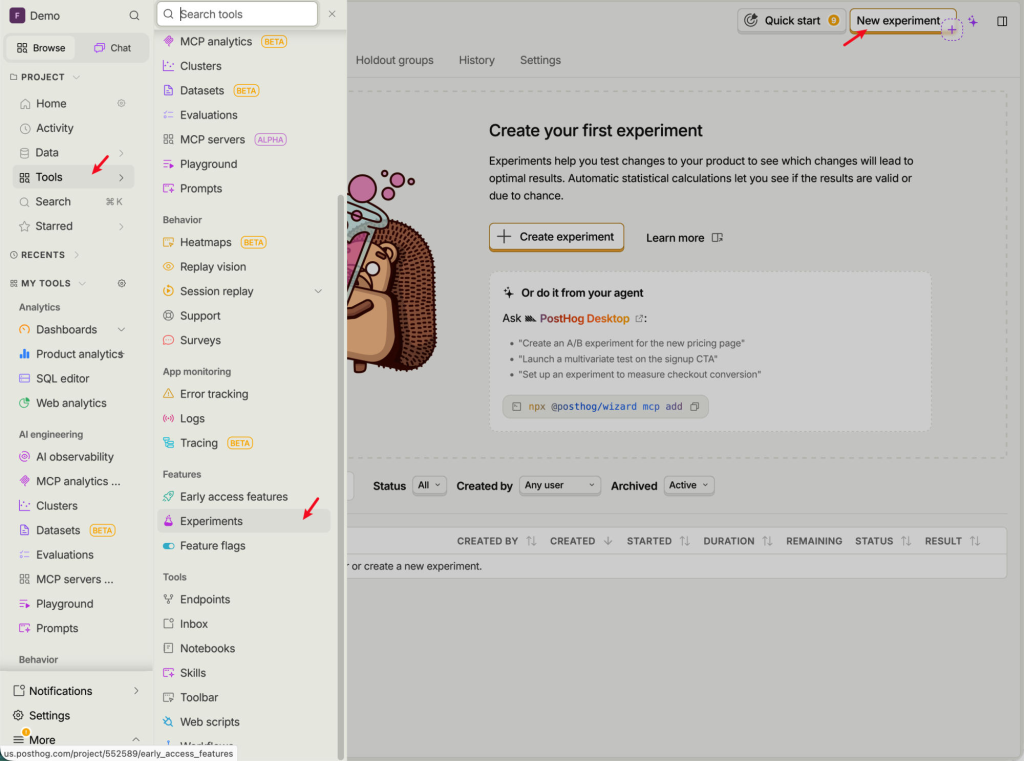
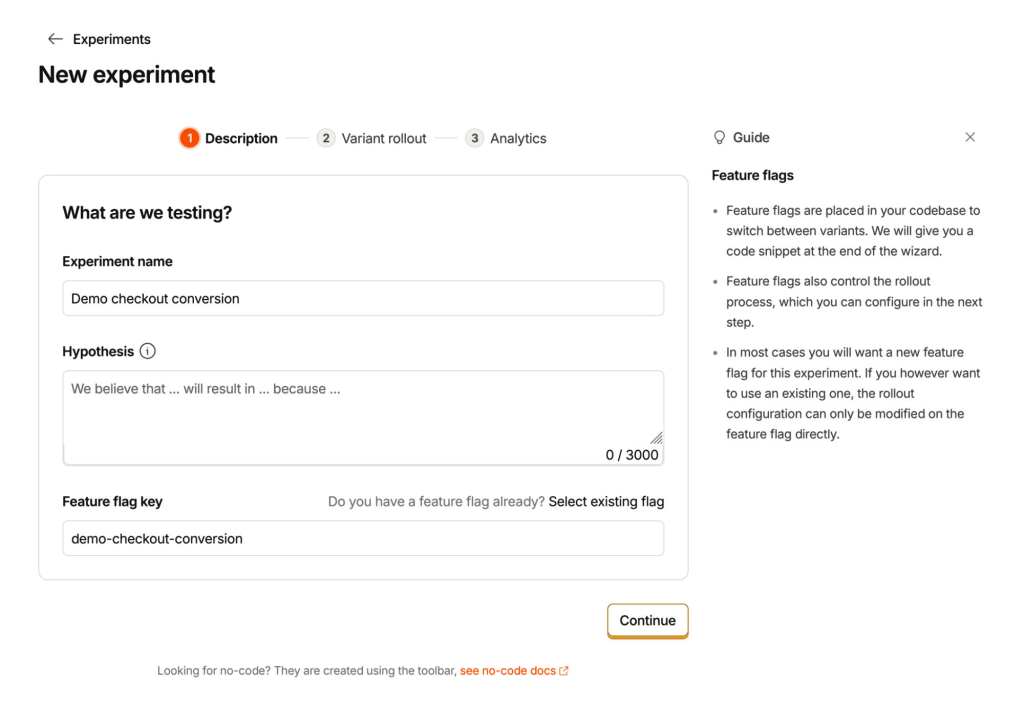
如果想測試的功能有不同變化,可以依照需求建立多個 Variant;如果只是測試一項改動,則可以使用常見的控制組 control 和實驗組 test。
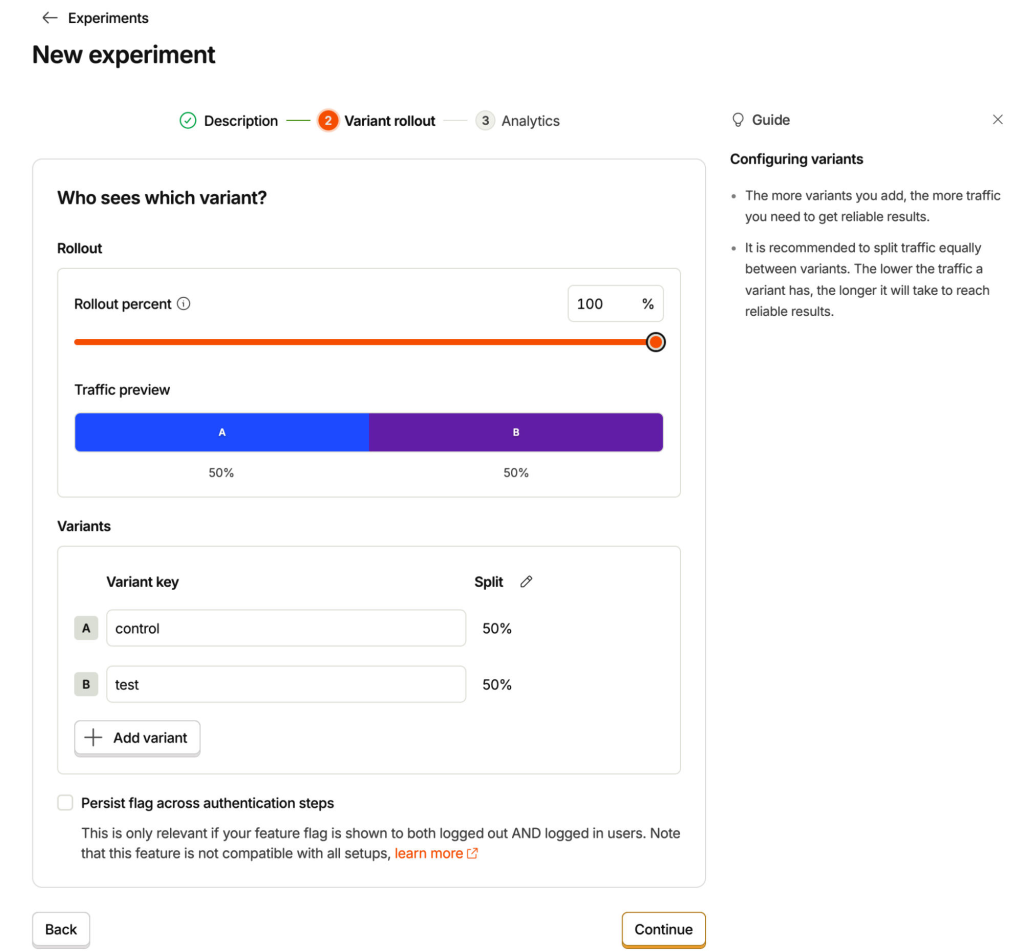
最後一頁可以控制什麼時候把使用者計入實驗。預設是在功能旗標實際被使用到時,但如果該功能旗標會在想測試的行為之前就先被觸發,也可以調整成自訂事件,讓真正接觸到測試內容的使用者才被計入。
Multiple variant handling 則可以保持預設的 Exclude multivariate users。這會排除同一名使用者在實驗期間接觸到兩種 Variant 的狀況,例如登入前與登入後被分到不同組,或是在不同裝置上取得了不同結果。
這種情況下,我們很難判斷使用者最後的行為究竟受到哪一個版本影響,因此直接排除會比較單純。
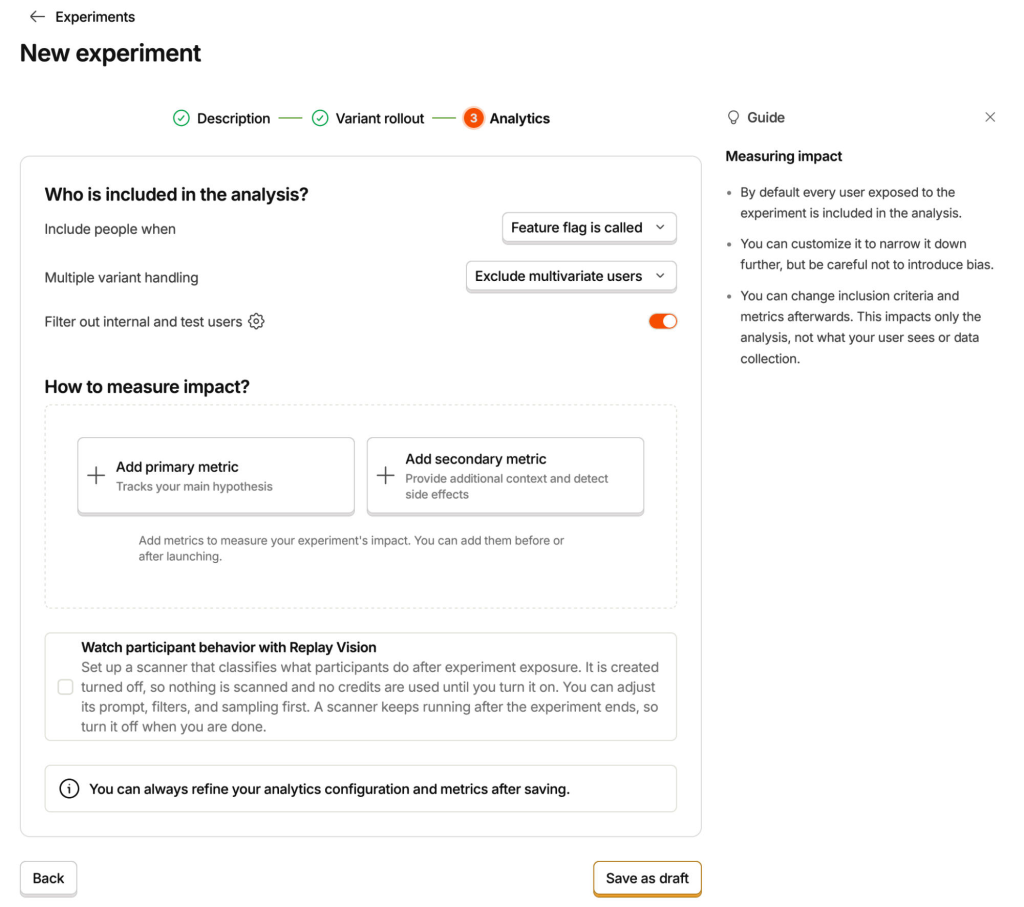
接著,我們還需要指定這場實驗想測量的影響。
例如我們修改了 Checkout,希望觀察交易完成的比例是否增加,就可以點擊 Add primary metric 與 Single-use,設計想觀察的指標。
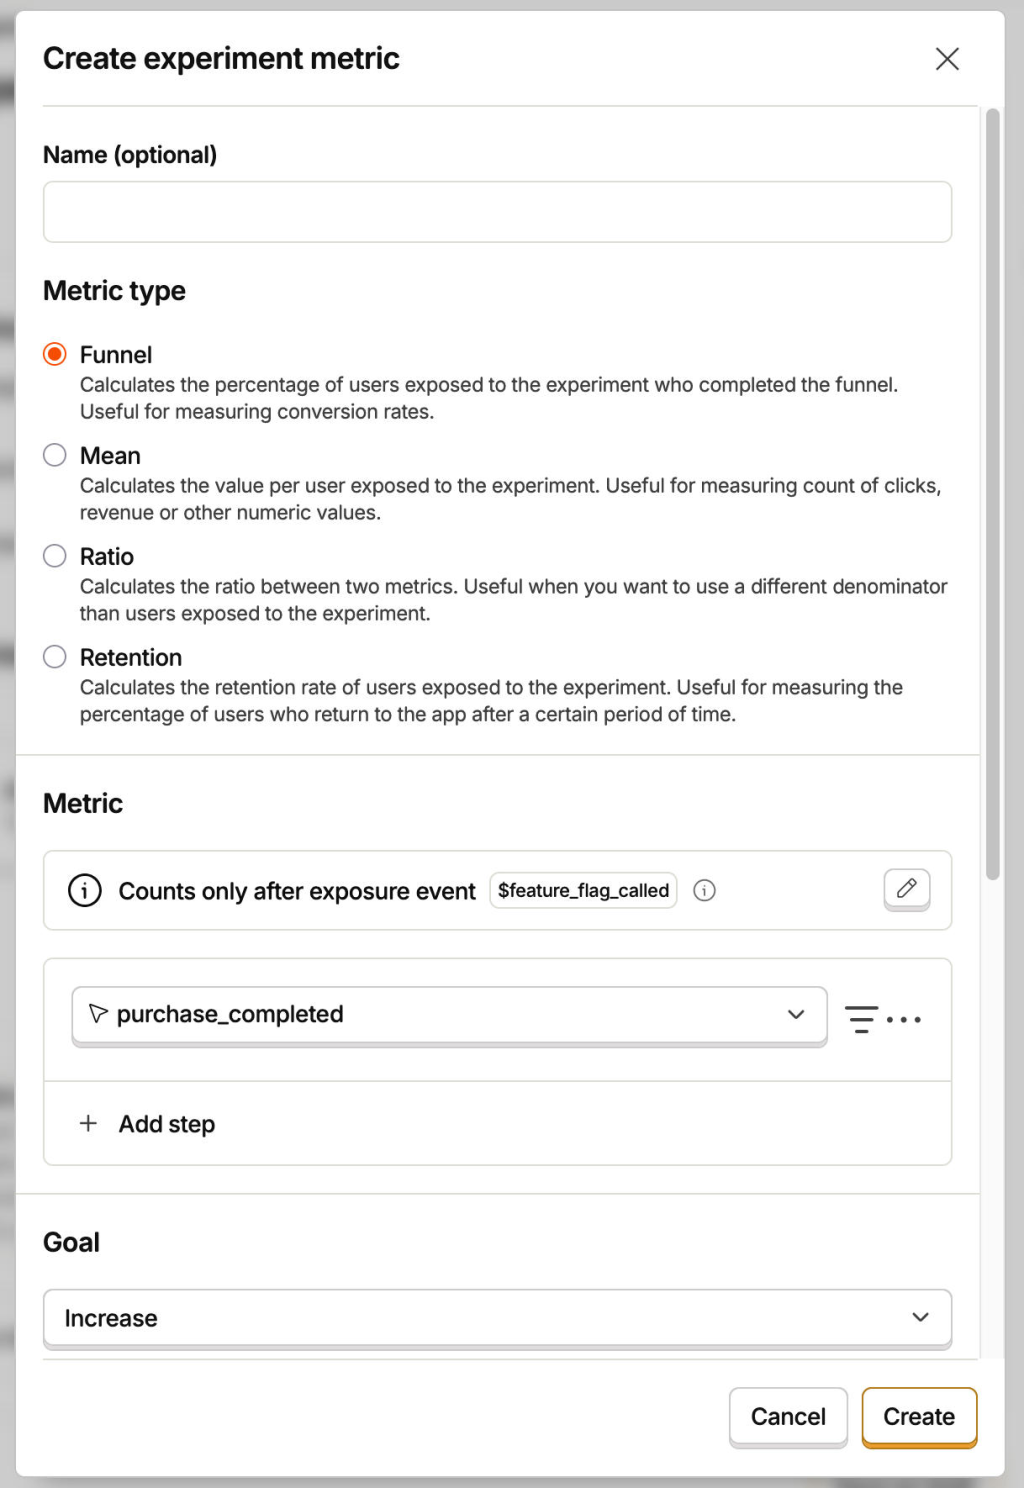
完成後,在程式碼加入:
if (posthog.getFeatureFlag('demo-checkout-conversion') === 'test') {
    // 要測試的行為
} else {
    // 原本的行為
}
接著啟用(Launch)Experiment,就可以開始收集實驗資料。
實驗結果可能會像是這樣:
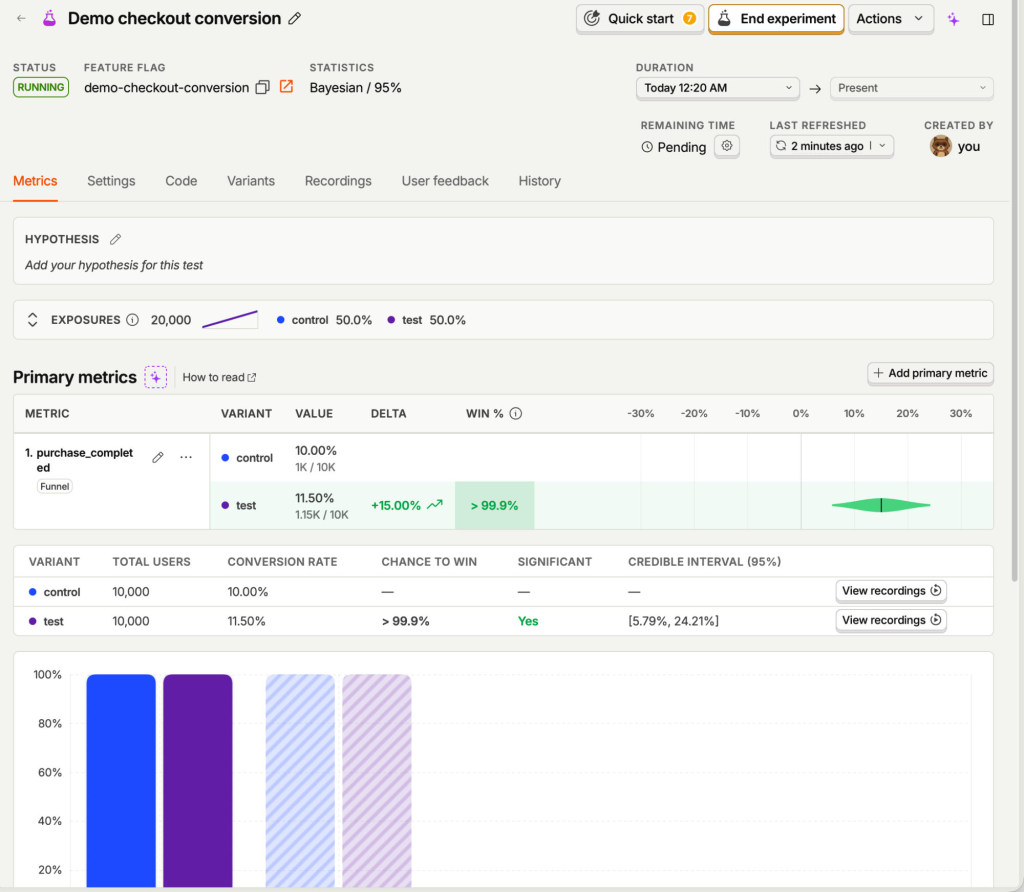
從圖中我們可以看到,test 的 Chance to win 被標記為大於 99%,這讓我們有更大的信心去切換成 test 的設定。
不過,要看懂這個數字,我們還是需要一點統計觀念。
我們雖然觀察到兩組的指標不同,但這並不意味著較高的一方就是正解。
舉例來說,假設整場實驗只有兩個使用者。其中一個在進入網站前就已經打定主意要買了,另外一個則只是競爭對手來做市場調查。這兩個人實際上不管被分配到哪一組,都不會改變自己的決策。
然而,如果第一個人剛好被分到 test,第二個人剛好被分到 control,我們最後仍然會看到:
test:100%control:0%差異看起來非常巨大,但顯然不能因此斷言 test 真的比較好。
這也是為什麼只依照觀察到的指標進行決策還不夠,我們還需要評估這個差異有多可信。
PostHog 預設可以使用貝氏統計來進行分析。其中 Chance to win 可以簡單理解成:根據目前取得的資料,test 真正比 control 表現更好的機率。
因此,圖中的大於 99% 並不是說 test 有 99% 的機率是「正確答案」,而是根據目前的實驗結果,我們認為 test 的真實表現優於 control 的機率超過 99%。
另一個可以觀察的數值是圖中的 Credible interval(可信區間)。
這個區間用來描述我們對實際效果還有多少不確定性。以圖中的 95% Credible interval 為例,可以簡單理解成:根據目前取得的資料,我們認為真實效果有 95% 的機率落在這個範圍內。
例如圖中的 5.79% 到 24.21%,代表我們認為 test 相較於 control 的真實改善幅度,有 95% 的機率落在這個區間。
如果樣本很少,這個範圍通常會比較寬,代表目前還很難確定真正的效果有多大;隨著取得更多資料,我們對結果的不確定性降低,區間通常也會逐漸縮小。
所以在觀察 Experiment 時,我們不只是在問:
「哪一組的數字比較高?」
而是進一步詢問:
「我們有多大的信心認為這個差異真的存在?」
當然,即使我們有很高的信心認為 test 比較好,也不代表一定要採用它。如果一個需要大量開發與維護成本的改動,只帶來非常微小的改善,最後仍然可能不值得實作。
統計可以幫助我們判斷觀察到的差異有多可信,但最後仍然需要回到產品本身,判斷這個改善是否值得我們採取行動。
透過 Experiment,我們就可以在修改產品之後,不只是觀察數字發生了什麼變化,而是更有依據地確認:這個改動是否真的帶來了我們預期的效果。
不過,即使實驗告訴我們改動有效或無效,它往往仍然沒有直接回答「為什麼」。接下來會從使用者實際行為與回饋繼續往下調查。
如果你願意花 30 秒留下回饋,我會用這些意見來調整後續文章:分享你的意見



 iThome鐵人賽
 看影片追技術