
昨天把 Todo App 的三個服務都跑在 K8s 上了,今天要學 Probe,讓 K8s 知道 Pod 什麼時候真的健康。
K8s 提供三種 Probe 來監控 Pod 的健康狀態:
三種 Probe 都支援相同的探測方式(HTTP GET、TCP Socket、Exec),差別只在檢查失敗時的行為。
今天會先從最常用的 Liveness Probe 開始 !
K8s 看到 Pod 的 STATUS 是 Running,只代表 Container 程序還在跑,不代表服務本身是健康的。
實際上可能發生的情況:
這些情況下 Pod 的 STATUS 還是 Running,K8s 不會主動重啟它,服務就這樣一直壞著。
Liveness Probe 是 K8s 定期執行的健康檢查。檢查失敗超過設定的次數,K8s 就會重啟這個 Pod。
幾個重要參數:
livenessProbe:
  httpGet:
    path: /health
    port: 8000
  initialDelaySeconds: 15   # Pod 啟動後等幾秒才開始檢查
  periodSeconds: 10          # 每隔幾秒檢查一次
  timeoutSeconds: 5          # 每次檢查的超時時間
  failureThreshold: 3        # 連續失敗幾次才重啟
  successThreshold: 1        # 連續成功幾次算健康(Liveness 固定是 1)
initialDelaySeconds 很重要——應用程式啟動需要時間,如果一啟動就開始檢查,還沒準備好的服務會一直被 Probe 判定失敗,導致無限重啟。設成比啟動時間長一點的值就好。
三種 Probe 都支援以下探測方式,這裡以 Liveness Probe 為例示範寫法。
最常用,對指定路徑發 HTTP GET,回應 2xx 或 3xx 算成功。
livenessProbe:
  httpGet:
    path: /health
    port: 8000
    httpHeaders:               # 選用,可以加自訂 header
      - name: Custom-Header
        value: Awesome
適合有 HTTP 介面的服務,例如 todo-api。
嘗試建立 TCP 連線,連線成功算健康。
livenessProbe:
  tcpSocket:
    port: 3306
適合沒有 HTTP 介面的服務,例如 MySQL、Redis。
在 Container 裡面執行指令,exit code 是 0 算成功。
livenessProbe:
  exec:
    command:
      - cat
      - /tmp/healthy
最彈性,可以執行任意指令,但效能開銷比前兩種大。
今天目標:幫 todo-api 加上 HTTP GET Liveness Probe、幫 MySQL 加上 Exec Liveness Probe,並透過故意設定錯誤路徑,觀察 K8s 偵測到失敗後自動重啟 Pod 的行為。
更新 /Todo-App/k8s/todo-api-deployment.yaml:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: todo-api
spec:
  replicas: 2
  selector:
    matchLabels:
      app: todo-api
  template:
    metadata:
      labels:
        app: todo-api
        tier: backend
    spec:
      containers:
        - name: api
          image: yourname/todo-app-api:v1.0.0
          ports:
            - containerPort: 8000
          envFrom:
            - configMapRef:
                name: todo-api-config
            - secretRef:
                name: todo-api-secret
          livenessProbe:
            httpGet:
              path: /health
              port: 8000
            initialDelaySeconds: 15
            periodSeconds: 10
            timeoutSeconds: 5
            failureThreshold: 3
kubectl apply -f todo-api-deployment.yaml
MySQL 沒有 HTTP 介面,用 TCP Socket 檢查連線,或用 exec 執行 mysqladmin。
更新 /Todo-App/k8s/mysql-statefulset.yaml:
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: mysql
spec:
  serviceName: mysql-headless
  replicas: 1
  selector:
    matchLabels:
      app: mysql
  template:
    metadata:
      labels:
        app: mysql
        tier: database
    spec:
      containers:
        - name: mysql
          image: mysql:8.0
          ports:
            - containerPort: 3306
          env:
            - name: MYSQL_ROOT_PASSWORD
              valueFrom:
                secretKeyRef:
                  name: mysql-secret
                  key: MYSQL_ROOT_PASSWORD
            - name: MYSQL_DATABASE
              value: "tododb"
            - name: MYSQL_USER
              value: "user"
            - name: MYSQL_PASSWORD
              valueFrom:
                secretKeyRef:
                  name: mysql-secret
                  key: MYSQL_PASSWORD
          livenessProbe:
            exec:
              command:
                - /bin/sh
                - -c
                - mysqladmin ping -h localhost -u root -p${MYSQL_ROOT_PASSWORD}
            initialDelaySeconds: 30
            periodSeconds: 10
            timeoutSeconds: 5
            failureThreshold: 3
          volumeMounts:
            - name: mysql-data
              mountPath: /var/lib/mysql
  volumeClaimTemplates:
    - metadata:
        name: mysql-data
      spec:
        accessModes:
          - ReadWriteOnce
        resources:
          requests:
            storage: 5Gi
kubectl apply -f mysql-statefulset.yaml
#取得pod
kubectl get pod

kubectl describe pod <todo-api-pod-name>
在輸出裡找 Liveness 欄位:
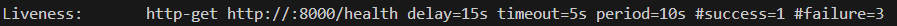
故意讓 Probe 失敗,看 K8s 怎麼處理。可以暫時把 todo-api-deployment.yaml 的 path 改成一個不存在的路徑:
livenessProbe:
  httpGet:
    path: /nonexistent
    port: 8000
  initialDelaySeconds: 5
  periodSeconds: 5
  failureThreshold: 2
Apply 之後觀察 Pod 狀態:
kubectl apply -f todo-api-deployment.yaml
kubectl get pods -w
你會看到 RESTARTS 欄位開始增加,代表 K8s 在不斷重啟 Pod:
NAME                       READY   STATUS    RESTARTS   AGE
todo-api-xxx               1/1     Running   0          10s
todo-api-xxx               1/1     Running   1          30s   ← 重啟了
todo-api-xxx               1/1     Running   2          50s   ← 又重啟了
確認沒問題後記得把 path 改回 /health,並再次 apply:
kubectl apply -f todo-api-deployment.yaml
今天學了 Liveness Probe:
initialDelaySeconds 要設得比服務啟動時間長,避免啟動期間就被重啟明天學 Readiness Probe,它跟 Liveness Probe 很像,但決定的是「要不要把流量送給這個 Pod」,而不是「要不要重啟」!


 iThome鐵人賽
 看影片追技術