1. 引言:一個「詳閱新版規範」帶來的日常惡夢
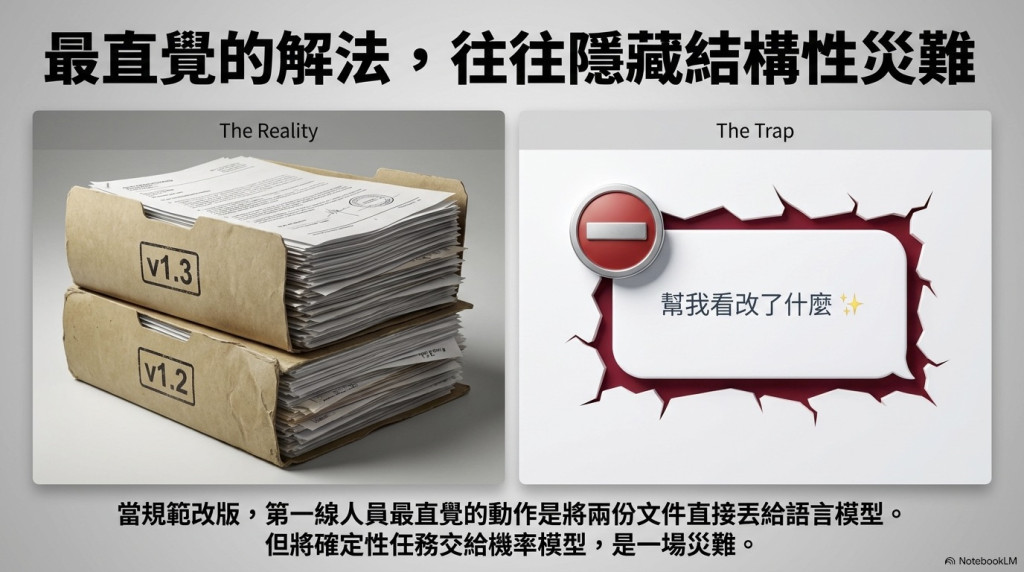
在金融機構或大型機構的法遵室裡,最令人背脊發涼的莫過於收到一封主旨為「作業規範改版通知」的郵件。附件裡躺著一份數萬字的新版規範,文末附上一句輕描淡寫的「請同仁自行詳閱並據以執行」。
為了找出那幾條足以致命的變動,資深同仁往往得開啟雙螢幕,在兩份長得幾乎一模一樣的 PDF 之間玩一整天的「大家來找碴」。這種眼力透支的勞動不僅極易出錯,更是對專業人才的巨大浪費。這時,許多人的直覺反應是:「現在 AI 那麼強,把兩份文件丟進去叫它幫我比對差異不就好了嗎?」
身為一名系統架構師,我要給你一個澆冷水的警告:這是一個極其危險的決定。將法遵比對直接交給大語言模型(LLM),就像是聘請一名「創意寫作系學生」來幫你代寫稽核日誌——他可能寫得天花亂墜,但你永遠不知道他在哪裡發揮了不該有的「創造力」。
2. 第一大反直覺觀點:比對是「確定性計算」,AI 根本不該參與
大多數人對 AI 有一種「萬靈丹」的過度期待,但在「找出文字差異」這件事上,AI 的機率模型本質反而成了最大的軟肋。比對兩段文字是否完全一致,在本質上應該是 100% 準確的機械行為,也就是所謂的「確定性計算」。
「比對本身是確定性計算,AI 根本不該參與比對;AI 該做的是比對完成之後的兩件事:把變更寫成摘要(事實),推測變更影響哪些作業(推論)。」
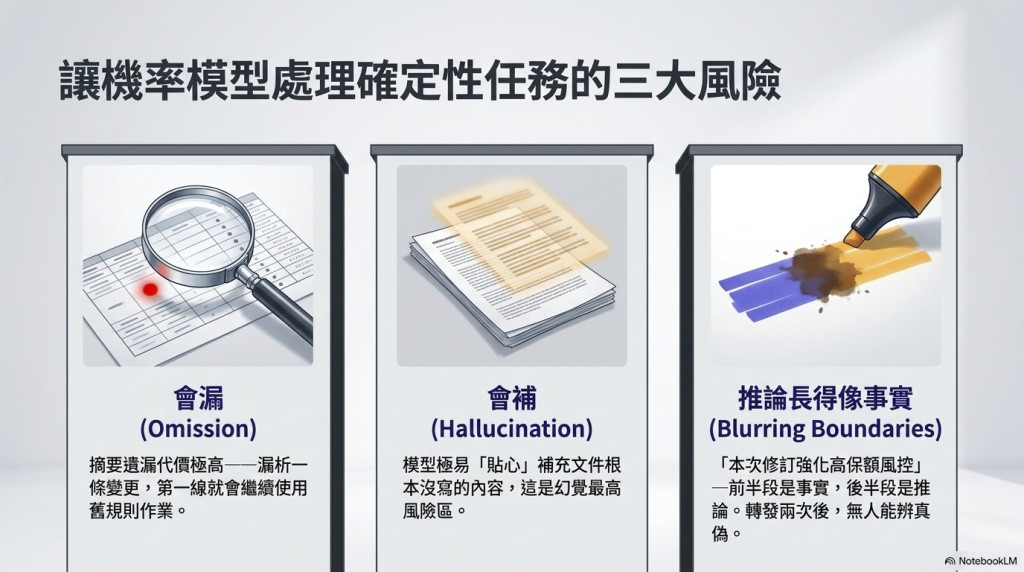
如果你盲目相信 AI 的比對能力,你的治理架構將面臨兩大結構性崩潰:
-
遺漏: 摘要遺漏的代價極高。漏掉一條變更,第一線人員就會繼續沿用舊規則作業,直接造成法遵斷點。
-
腦補(幻覺): 模型可能會「貼心地」幫你補充文件中根本不存在的修訂。在高度監管的環境下,這種「幻覺變更」是絕對的禁止項。
正確的架構應該是利用傳統程式碼(如 Python 比對引擎)執行冷冰冰但 100% 精準的文字核對,再將「確定變更清單」餵給 AI 進行分析。
3. 第二大衝擊 takeaway:98% 的相似度,可能是 200 萬元的代價
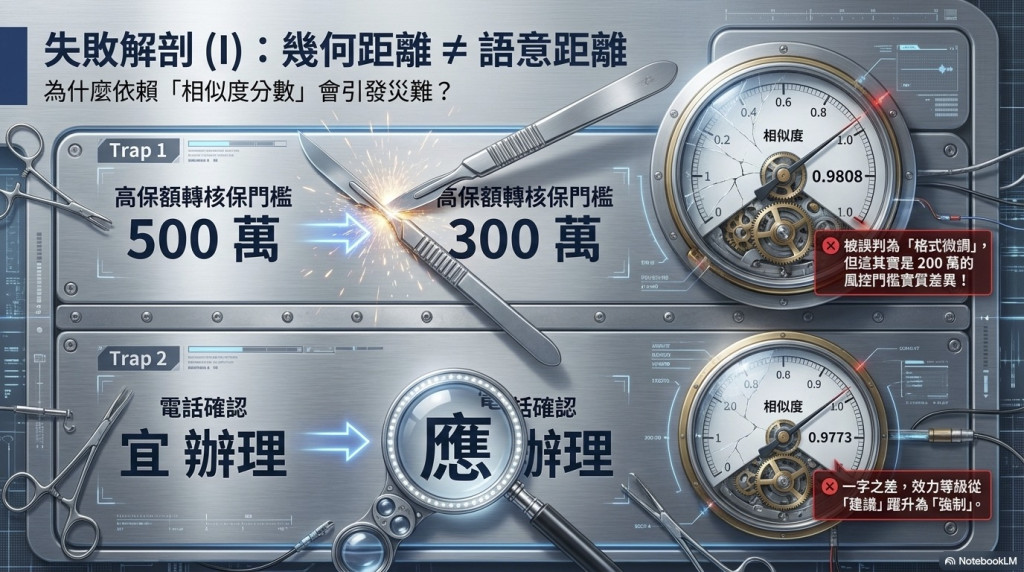
在技術實作中,許多工程師會設置「相似度門檻(Similarity Threshold)」,例如認為相似度 0.95 以上就只是標點符號或格式微調。在行銷文案比對中這很有效,但在法遵文件中,這是**「法遵自殺(Compliance Suicide)」**。
看看我們從真實測試中得到的教訓:
-
數字的重量: 將「高保額轉核保門檻 500 萬」改為「300 萬」。在一段四十多個字的條文中,兩者的相似度高達 0.98。若依賴相似度演算法,系統會自動將其判定為「無實質變動」的格式微調,但這背後卻是 200 萬元的風控門檻落差。
-
效力的位階: 將電話確認的「宜」改為「應」。相似度可能高達 0.97,但這一個字之差,就讓作業從「建議性」轉為「強制性」,直接改變了規範的效力等級。
幾何距離(相似度)不等於語意距離(法律效力)。 AI 如果只看數字上的相似,就會放過這些足以讓整間公司陷入裁罰風險的微小變更。
4. 第三大技術洞察:條號只是「位置」,不是「身分」
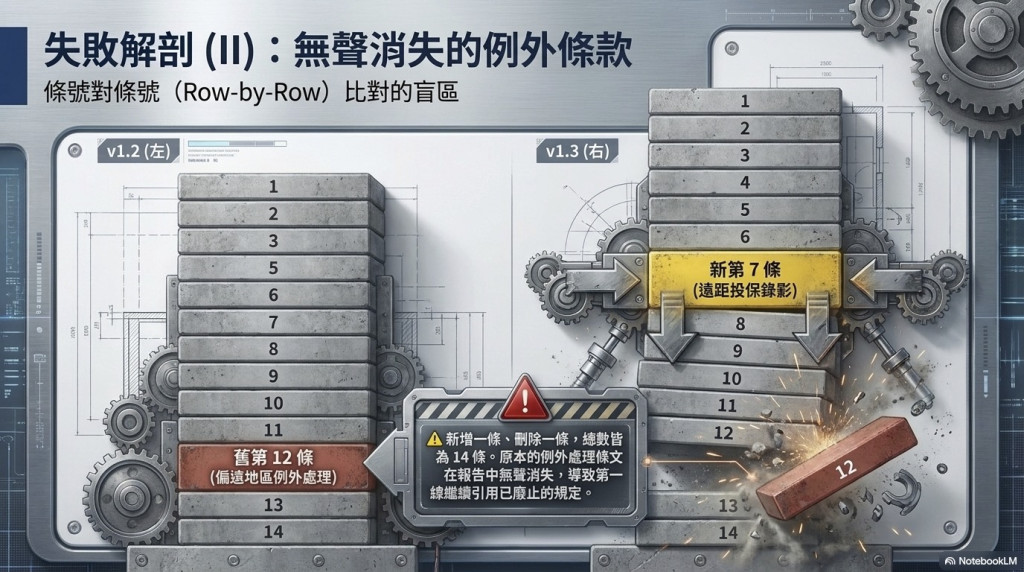
另一個常見的誤區是採取「條對條」的比對(舊版第 7 條對新版第 7 條)。這種設計在面對條文增刪時會全面崩潰。
想像一下,當新版文件在中間新增了一條規範,後續所有條文都會產生位移。如果系統只會死板地按條號對接,它會回報後續所有條文都有「大規模修訂」(其實只是重編號位移),最危險的情況是:被刪除的「例外處理條文」會無聲無息地消失在報告中。
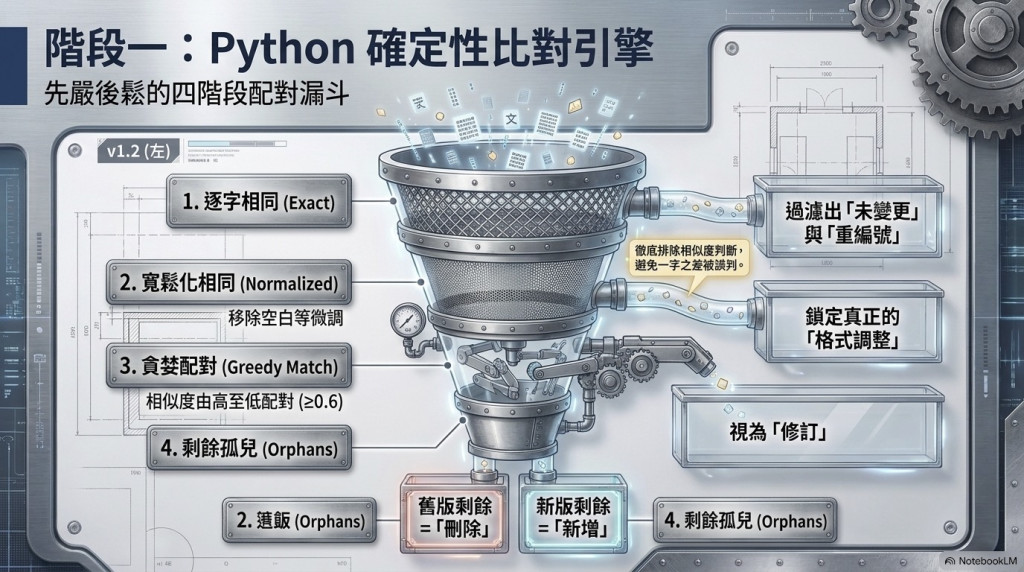
為了應對這種陰險的設計,一套專業的架構必須採用**「四階段配對法」**:
-
逐字相同配對: 處理未變動或單純換位置的條文。
-
寬鬆化配對: 透過 NFKC 規範化處理並移除空白,排除純格式干擾。
-
語意相似度配對(Greedy Matching): 對剩餘條文取相似度,由高至低進行貪婪配對(門檻 ≥0.6),這才是真正的「修訂」偵測。
-
殘餘處理: 明確標示哪些是真正的「新增」與「刪除」。
5. 第四大治理金律:事實與推論的「隔離牆」
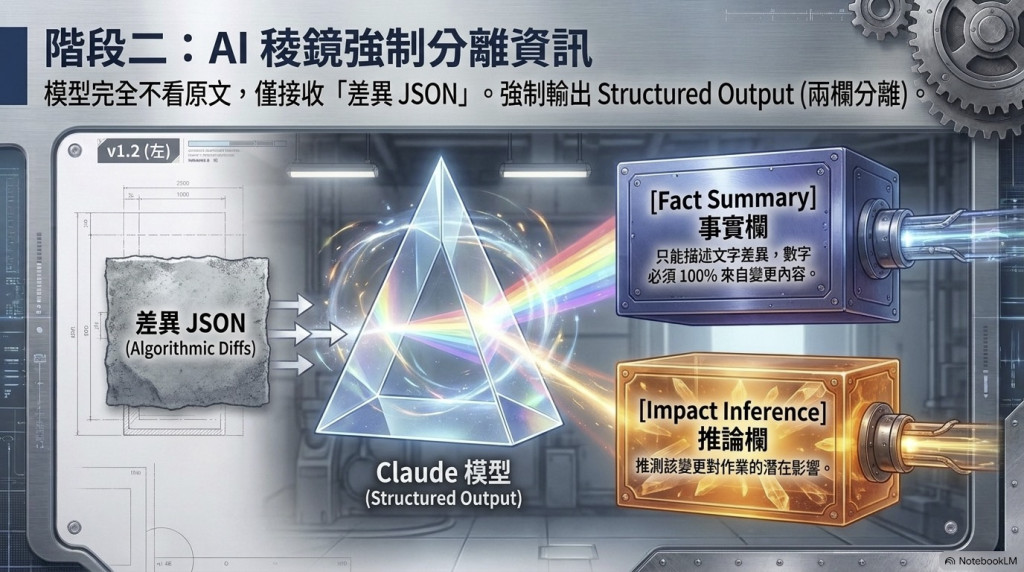
當 AI 抓出差異並進行分析時,我們必須在輸出的資訊架構上建立一道「隔離牆」。**事實(Fact Summary)與推論(Impact Inference)必須分欄輸出,且所有的類別標籤必須由程式「硬碼(Hard-coded)」**加上。
身為架構師,我們甚至不信任模型「幫自己的推論貼標籤」,因為模型會自律失敗,但程式邏輯不會。我們更設計了**「四道閘門(Four Gates)」**攔截機制,只要事實欄出現違規用語,直接退回重來。
| 欄位名稱 |
內容規範 |
治理要求(四道閘門) |
| 【文件事實】 |
只能描述兩版文字差異,數字須逐字取自原文。 |
嚴禁出現「可能、推測」等用語;數字若非原文存在即視為自創。 |
| 【AI 推論】 |
推測變更可能影響的作業流程或風險點。 |
標籤由程式寫死,必須明確標註「僅供建議」。 |
這種設計能確保即便 AI 產生了推論偏差,稽核人員也能一眼看出哪部分是「鐵打的事實」,哪部分是「AI 的猜測」。
6. 結語:從「找碴」到「理解」,人機協作的新界線
AI 在法遵流程中的真正價值,不在於取代傳統程式去「抓文字差異」,而是在差異被精準抓出後,去「分析變更影響」。
一個穩健的 AI 系統,應該是建立在紮實的工程基本功之上的。當我們過度依賴 AI 的機率判斷,而遺忘了確定性計算的嚴謹時,自動化反而會成為風險的溫床。遺漏變更的代價是巨大的,這正是為什麼我們需要那四道閘門與嚴格的隔離牆。
最後留下一個思考題:在追求自動化的過程中,有哪些「確定性」的工作是你正打算丟給 AI、卻遺忘了工程基本功的?當 AI 告訴你兩份文件「大致相同」時,在沒有看過確切的比對數據前,你真的敢簽名負責嗎?
回顧
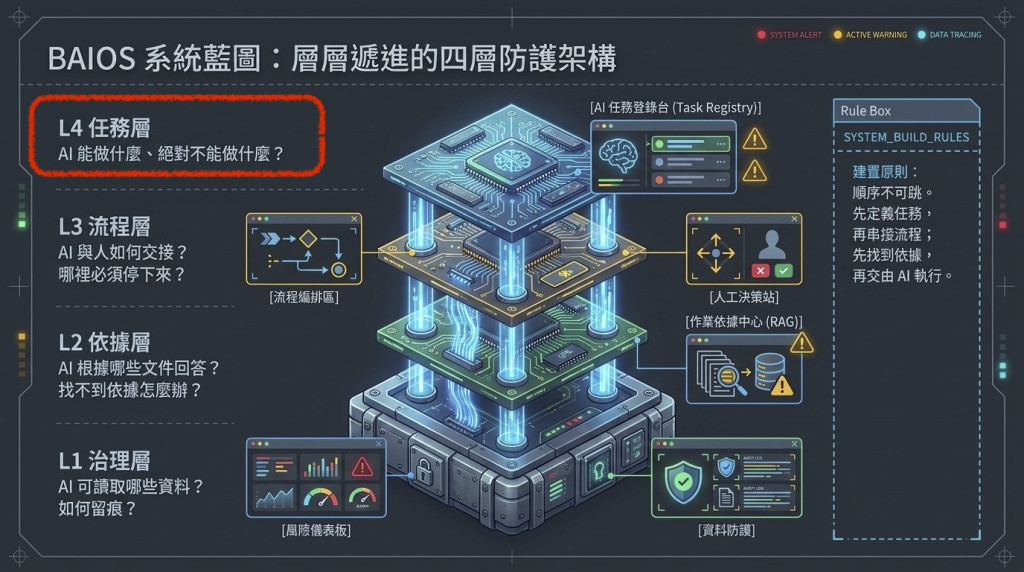
在 BAIOS(銀保 AI 營運中台)架構中,Day 1 到 Day 8 屬於完整的**「任務層」建置。這 8 天的核心目標是解決「AI 任務沒有邊界、回答沒有依據、結果無法追溯」**的治理痛點,完成從治理地基建立、場景篩選、邊界與規格劃定,到三個關鍵營運實作落地的閉環。
一、 治理地基與場景選擇(Day 1–Day 2)
-
Day 1|專案定位與治理地基
-
從個人工具升級為營運系統:將零散的 AI 工具升級為可管理、可驗收、可追溯,且保留人類最終決策的 BAIOS 系統。
-
四層架構與核心原則:提出「任務層、流程層、依據層、治理層」四大架構,並貫徹核心原則——「確定性計算交給程式,語意理解與說明交給模型」。
-
治理對照與房規:對照《保險業運用人工智慧系統自律規範》建立對照檢核表,並訂立房規(CLAUDE.md)與單一事實來源(PROJECT_CONTEXT.md)。
-
Day 2|評估矩陣與場景篩選
-
前置閘門與四維度評估:設計「規範適用前置閘門(紅黃綠三色)」與「效益、可行性、風險可控度、資料可得性」四維度評分矩陣。
-
選場景與排除留痕:選出三個營運場景(公用信箱分類、業績資料檢核、作業文件差異分析),並記錄紅燈排除理由(如避開自動外寄、金額承諾與客戶權益決策)。
二、 邊界劃定與規格設計(Day 3–Day 4)
-
Day 3|四層任務邊界表
-
劃定四層權責與全域清單:明確定義「可自動執行、僅供建議、必須人工決定、禁止執行」四層動作邊界,並建立 G1–G7 全域禁止清單。
-
依錯誤代價動態分層:依「錯誤代價不對稱性」調整分層(例如急迫度判斷因「急件判成不急」會沉在佇列底部且影響重大,從「可自動執行」降級為「僅供建議」)。
-
Day 4|可驗收的 AI 規格化
-
九區塊規格模板:設計包含任務識別、輸入輸出、處理規則、例外處理、治理欄位等九區塊的規格模板,限制 enum 封閉列舉以防止格式漂移。
-
驗收標準三原則:訂定「可量測、可自動檢核優先、紅線零容忍」原則,將品質與格式明確量化。
三、 治理系統落地與三個實作案例(Day 5–Day 8)
-
Day 5|AI 任務登錄台(系統模組)
-
任務未登錄,不得進入開發:建立 AI 任務的「戶口名簿」,將運作摘要、已知限制、模型資訊與定期複審等治理欄位程式化。
-
稽核留痕與說明卡:使用 Pydantic 驗證器強制合規,採用 JSONL 追加儲存稽核日誌(Audit Log),並自動產出一頁式「模型使用說明卡」供業務負責人簽核。
-
Day 6|實作一:公用信箱需求分類(TASK-001)
-
Prompt 版本化與雙重驗證:Prompt 獨立檔案化帶版本;採用 JSON Schema 與 Pydantic 進行客戶端雙重驗證。
-
確定性前置檢核:進模型前由 Python 先進行敏感樣式掃描(E2,命中則不送模型),並透過 Unicode NFKC 正規化解決全形字元繞過漏掃的漏洞。
-
Day 7|實作二:業績資料品質檢核(TASK-002)
-
Pandas 引擎進行確定性計算:缺值、重複列、格式錯誤、異常值(IQR 法)與前後期差異完全由 Pandas 檢核,Claude 僅根據 findings JSON 撰寫報告草稿。
-
剛性驗證閘門:設有「數字一致性驗證閘門」,限制草稿中的數字若不在 findings 白名單內即退回;格式檢核改用 ASCII 範圍 `` 攔截全形數字,確保統計精確。
-
Day 8|實作三:作業文件版本差異分析(TASK-003)
-
條文結構比對:由 Python 比對引擎執行四階段先嚴後鬆配對(解決條號位移與單純相似度幾何距離的欺騙問題),比對完成後才交給 AI 撰寫變更摘要與推論影響。
-
事實與推論分欄:AI 輸出分開「事實欄」與「推論欄」,且【文件事實】與【AI 推論,僅供建議】標籤由程式寫死渲染,模型不可自行標籤。
總結:Day 1~Day 8 的核心精神
這 8 天的核心實踐在於 「用程式碼管住 AI 的不確定性」:
-
確定性計算(計數、比對、過濾)靠程式,語意說明與摘要靠模型。
-
所有 AI 產出皆需通過剛性驗證閘門(Schema 驗證、敏感樣式攔截、數字白名單比對、事實與推論分開)。
-
治理決策與運作軌跡皆需留下可追溯的檔案與 Audit Log。
💡 接下來可進入 Day 9~15 的「流程層」,探討如何把這些單一 AI 任務串接成完整的人機協作工作流。是否想了解其中某個實作任務(TASK-001/002/003)在人機交接上的設計細節?


 iThome鐵人賽
 看影片追技術