
「一句話可以被駁倒,一輪投票可以被翻案,一整局的紀錄不行——它不是你的記憶,是攤在桌上的證物。」
——《阿帕契開源審計錄》¹ 卷二·金字塔篇
幕間
「三號,你連續三晚第一個喊刀口,每次都把嫌疑引向別人。」
七號在白天攤開羊皮紙,字字有據。三號憤怒拍桌,卻見全場無人附和。
出局前三號死瞪著二號——那一瞥,全場只有二號讀懂了。
爭論卡在第二夜。五號咬定七號那晚投了他,說她立場一直有問題;附和的人不少,七號要是拿不出東西,這一輪就得背鍋。
以前的平民遇到這種情況只能靠嘴——「我沒有」「你記錯了」,然後看誰的聲音大。七號沒有。她把羊皮紙翻回前面幾頁,手指沿著「第幾夜」那一欄往下滑,停在第二夜那行:她那晚是棄票,理由欄寫著「四號六號對跳,資訊不足」,旁邊還有另外兩個平民當時的行可以對照。她把整頁轉過去給五號看。
「你可以說我今天的發言有問題,那是一句話,我們可以吵。你說我第二夜投了你,這是紀錄,查得到。」五號沒再接。
一個身分聲明,到底要用幾層驗證才站得住?一句話、一輪投票、一整局,分別能證明什麼?
金字塔把測試分三層,越往下數量越多、跑得越快。單元測試只測一個函式,跟資料庫、網路、檔案系統隔離,毫秒級,數量最多,是基座——對應「一句話」:這一句發言內部自洽嗎。整合測試測多個元件合作,例如資料庫真的接上時查詢對不對、服務之間有沒有正確串起來,數量較少、較慢——對應「一輪投票」:幾個人的發言兜在一起站得住嗎。端對端測試模擬完整路徑,例如整跑一次「投票、開票、公布」,數量最少也最脆弱——對應「一整局」:從第一夜到現在整條時間線。金字塔倒過來(端對端一大堆、單元沒幾個)就是反模式,業界戲稱「冰淇淋筒」:一出包就得跑一次又慢又脆的完整流程才知道哪裡壞,而且環境一抖動就假性失敗,久了大家乾脆不看紅燈。
Go 沒有斷言函式庫的文化,失敗就是 if got != want { t.Errorf(...) }。慣例是把案例寫成一個 struct 的 slice,每個元素是 {name, input, want},迴圈裡用 t.Run(tc.name, ...) 開子測試。這個模式便宜在哪:新增一個案例只是多一行 struct 字面值,斷言邏輯只寫一次、所有案例共用,不會出現「這個案例忘了檢查回傳值」的漂移;子測試各有名字,go test -run TestX/unknown_night 可以只跑其中一個。要小心的是共用狀態——如果幾個案例共用一份可變的 fixture,某個子測試改了它,後面的子測試就讀到被汙染的狀態,加上 t.Parallel() 之後順序不定,就變成偶發失敗。範例裡的 log 是唯讀的 map,沒這個問題;一旦案例需要各自改動輸入,就得在迴圈裡複製一份。
JUnit 5 提供 @Test、生命週期的 @BeforeEach,以及 @ParameterizedTest 搭配 @ValueSource / @CsvSource——這就是 Java 的表格驅動。斷言用 Assertions.assertEquals、assertThrows。Mockito 負責把協作物件換成替身,讓單元測試維持在單元層級:mock(Repository.class)、when(...).thenReturn(...)、verify(...)。這裡有條線要拿捏:替身只該用在真正的邊界上——網路、時鐘、檔案系統、外部服務。如果連自己模組內部的每個類別都 mock,測試斷言的其實是「這段程式碼有沒有照這個順序呼叫這些方法」,等於把實作照抄成一份鏡子;之後只要重構內部結構、行為完全沒變,測試照樣紅燈,這種測試是負債不是資產。
Rust 習慣把測試寫在同一個檔案裡的 #[cfg(test)] mod tests,函式標 #[test],斷言用 assert_eq! / assert!。整合測試放在 tests/ 目錄,會被當成獨立的 crate 編譯,只看得到公開 API——這道限制逼你站在使用者的角度檢查介面夠不夠用。還有 doctest:寫在 /// 文件註解裡的程式碼會被實際編譯並執行。它解的是一個很實際的問題——文件裡的範例會腐爛。函式簽章改了、參數順序換了,如果範例只是純文字,沒有人會發現它已經在騙人;doctest 讓 cargo test 直接對這些範例編譯執行,對不上就紅燈。代價是慢,每個 doctest 都是一次獨立編譯。
@pytest.fixture 是一個函式,測試只要在參數列寫上它的名字就會拿到它的回傳值。它比傳統的 setUp 好在幾個地方:setUp 對整個測試類別無差別地跑,每個測試都付一樣的代價;fixture 是「誰要誰拿」,一個測試不用的資源就不會為它建立。fixture 有 function / module / session 作用域,一個昂貴的資源(資料庫、容器)可以整個模組或整場測試只建一次。fixture 還能彼此組合:一個 db fixture 依賴一個 config fixture,pytest 會自動把依賴串好——這是 setUp 靠繼承做不乾淨的事。@pytest.mark.parametrize 則對應表格驅動。
四層語言各自的測試工具解決的是「代碼有沒有照預期運作」,但還有一個更早的關卡容易被忽略:AI 代理人寫完代碼、跑完 go test 或 pytest 全綠之後,就一定代表這段變更值得人類審查嗎?測試綠燈只證明「符合你寫的斷言」,不代表「這段邏輯本身沒問題」——一個斷言寫錯方向的測試,一樣會綠燈。這正是本文寫作所用的 Claude Code 環境裡,另外劃出一層獨立於測試金字塔之外的自動審查:一個可設定審查力度(低/中/高/深度)的程式碼審查技能,在提交變更前先掃過整份差異,找出邏輯錯誤與可簡化之處;紅燈-綠燈-重構的測試優先流程本身,也被封裝成一套可重複調用的工作方式,而不是每次都要工程師自己從頭喊口號。把它放進金字塔的比喻裡,這比較像是端對端測試上面再加一層旁觀者——不跑代碼,只讀代碼,抓的是測試斷言本身也可能漏掉的那類問題。
package village

import "testing"

// underTest: does a stated vote match the recorded audit log?
func voteMatchesLog(night int, claimed string, log map[int]string) bool {
	recorded, ok := log[night]
	return ok && recorded == claimed
}

func TestVoteMatchesLog(t *testing.T) {
	log := map[int]string{1: "seat-3", 2: "abstain", 3: "seat-5"}

	cases := []struct {
		name    string
		night   int
		claimed string
		want    bool
	}{
		{"true claim on night 1", 1, "seat-3", true},
		{"false claim on night 2", 2, "seat-5", false},
		{"abstain is a recorded value", 2, "abstain", true},
		{"unknown night", 9, "seat-1", false},
	}

	for _, tc := range cases {
		t.Run(tc.name, func(t *testing.T) {
			if got := voteMatchesLog(tc.night, tc.claimed, log); got != tc.want {
				t.Errorf("night=%d claimed=%q: got %v, want %v", tc.night, tc.claimed, got, tc.want)
			}
		})
	}
}
/// Returns true when a claimed vote matches the audit log for that night.
///
/// ```
/// # use village::vote_matches_log;
/// let log = [(1u8, "seat-3"), (2, "abstain")];
/// assert!(vote_matches_log(1, "seat-3", &log));
/// assert!(!vote_matches_log(2, "seat-5", &log));
/// ```
pub fn vote_matches_log(night: u8, claimed: &str, log: &[(u8, &str)]) -> bool {
    log.iter().any(|&(n, who)| n == night && who == claimed)
}
Go 那段要看的是 cases 這個 slice:四個元素分別打中真報(第一夜確實投 seat-3)、假報(第二夜投的是棄票不是 seat-5)、棄票本身也是一個要能查得到的值、以及根本不存在的第九夜。斷言只有迴圈裡那一行 if got != tc.want,四個案例共用,所以不會有某個案例漏檢;每個 t.Run 帶著 tc.name,失敗訊息會直接告訴你是哪一個案例掛了。Rust 那段把同一組檢查寫進 /// 裡的範例,開頭 # use ... 那行前面的井號表示「編譯時要,但在產生的文件裡藏起來」,剩下的就是使用者會照著打的程式碼——簽章一改、範例跟不上,cargo test 立刻抓到。兩者都在做七號做的事:把一個聲明拆成可以逐條核對的小命題,而不是整包丟出去賭運氣。
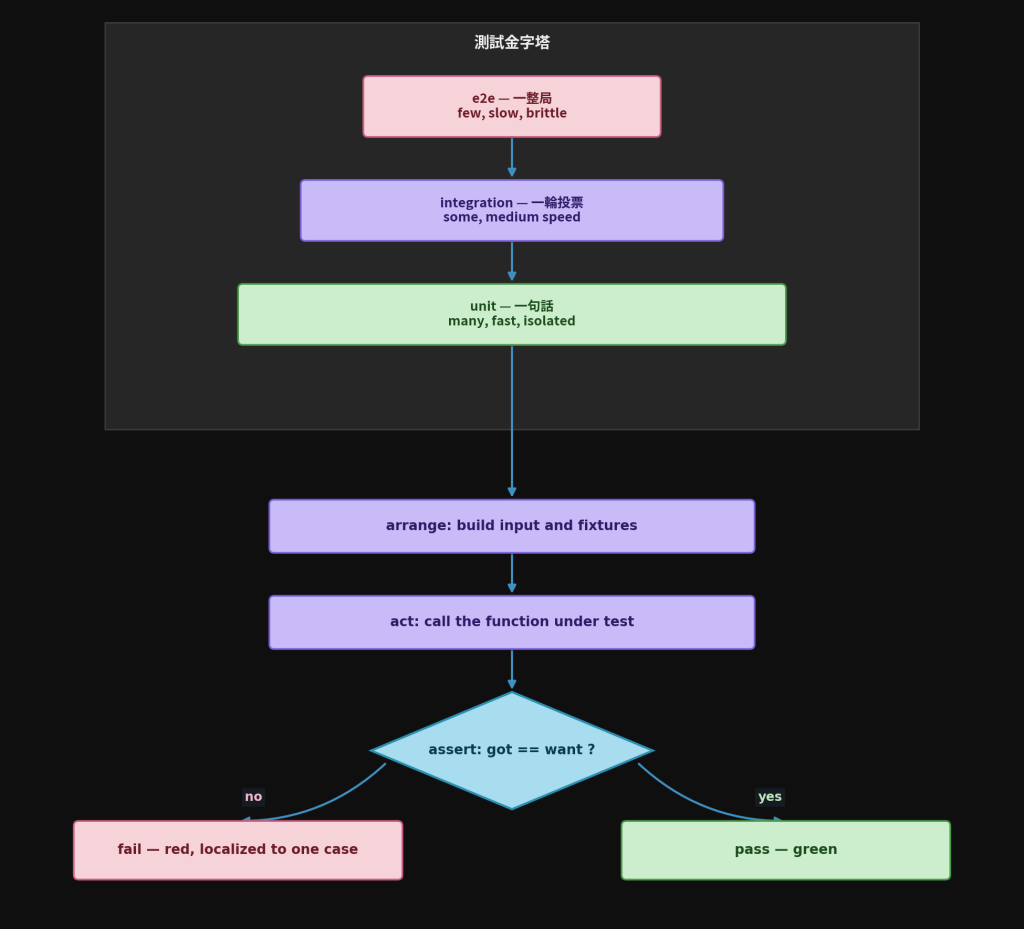
五號那一輪沒能把鍋甩到七號頭上,不是因為七號比較會講,是因為她手裡那頁紙可以往回查。一句話對一句話,是誰嗓門大;一整局的紀錄擺出來,爭論就結束了——這就是金字塔頂端那層端對端測試的價值:它慢、它笨重,跑一次要把整條時間線重放一遍,但它驗的是整條路徑,沒有人能靠一句漂亮話繞過去。反過來,如果七號手上只有「我覺得五號怪」這種單點印象,那就只是最脆弱的那種測試,換個人多講兩句就翻盤了。
二號那天也在記東西,炭筆在桌面下沒停過。有人問,他還是那句「隨手寫的」,紙沒給任何人看過。七號的表格跟他的筆記最大的差別,不在寫得多不多,在她的可以被別人翻開來查,他的不行——一份不能被審查的紀錄,跟沒有紀錄差不多。
還有一件事我一直沒跟任何人講:我死過這麼多次,每一次重來,桌上的人、牌、連我自己的記憶都會回到原點,只有七號那卷羊皮紙上的字,從來沒有跟著被抹成空白。它像是不歸這局的重來管。
你現在該能:講出單元、整合、端對端三層測試各自驗什麼、為什麼數量要從下往上遞減;看懂 Go 的表格驅動測試怎麼用一個 struct slice 涵蓋多個案例,以及 Rust 的 doctest 為什麼能讓文件裡的範例不會過期。想動手,就照 Rust 官方 Book 的「Writing Automated Tests」跟 Go 官方文件的 testing 章節,替同一個小函式分別寫出表格驅動測試與 doctest,再用 pytest 的 fixture 把測試資料抽出來共用;roadmap.sh 有各語言測試工具的學習路徑。
testing 套件(表格驅動測試與子測試)
Go table-driven tests subtests t.Run JUnit 5 parameterized tests Mockito verify Rust doctest cargo test integration tests directory pytest fixtures scope conftest parametrize
¹ 註:本書名為情境設定之虛構文獻,非真實歷史或開源紀錄。


 iThome鐵人賽
 看影片追技術